Rayyanの使い方|スクリーニング手順・PRISMA数・κ
システマティックレビューのタイトル・抄録スクリーニングは、「各データベースから出力する → 統合して重複を削除する → 2名が互いの判定を見ずに選別する(ブラインド)→ 意見が分かれた文献(コンフリクト)を解決する → 除外理由と件数を記録する」という流れで進めます。Rayyanはこの作業を支援するツールの1つで、本記事では手順の例として使います。ツールの優劣は論じません。PRISMAのフロー図に必要な件数はどのソフトでも同じです。また、2名の一致度を表すCohenのκ(カッパ)は計算が簡単な反面、読み違えやすい指標なので、公開論文の実データでRによる計算例を示します。
本記事が扱うのは、タイトル・抄録の選別作業の実務と記録です。検索式の作り方、PRISMA 2020の項目全体、メタアナリシスの統合方法は扱いません。全体の流れはシステマティックレビューのやり方(8ステップ)、報告方法はPRISMA 2020の報告方法、統合はメタアナリシスの手順をご覧ください。
1. スクリーニングで残すべき4つのもの
使うツールにかかわらず、タイトル・抄録スクリーニングの結果として次の4点を残します。
- 全文献について、査読者ごとの判定(採用・除外・保留)を監査できる記録として残す。
- PRISMA 2020のフロー図に使う件数(第3章)。
- 意見が分かれたときの解決ルール(開始前に決めておく)。
- 報告に必要な方法の記述。PRISMA 2020の項目8は、各レコードを何名が選別したか、独立して作業したか、自動化ツールを使ったならその詳細を求めています(Page et al., 2021)。
査読者の人数について、Cochraneハンドブック第4章(バージョン6.5.1、2025年3月更新。2026年10月8日に閲覧)は、各研究が適格基準を満たすかの判断に、少なくとも2名が独立して関わることを求めています。一方、タイトル・抄録の段階を2名で行うことは「望ましいが必須ではない」とし、最終的な全文での判断は2名が独立して行うことが不可欠だとしています。また、適格基準を少数の文献(例として6〜8件)で試し、複数の人が同じように適用できるか確かめることを勧めています。なお、閲覧した範囲では、ハンドブック第4章にもPRISMA 2020にもκを求める記載はありません。κを報告するかどうかはレビューチームの判断です。
2. Rayyanでの手順(7ステップ)
Rayyanは、Ouzzaniら(2016)によって、タイトルと抄録の初期選別を半自動化によって効率化するウェブ・モバイルアプリとして紹介されました(抄録、PMID 27919275)。以下の現在の機能に関する記述は、すべてRayyan公式ページを2026年10月8日に確認した内容です。機能や画面は変わりますので、実際の作業前に最新のヘルプをご確認ください。料金やプランの上限は扱いません。
ステップ1:各データベースから出力し、生の件数を記録する。統合する前に、データベースごとの件数を控えます(PRISMAのフロー図は情報源ごとの件数を求めます)。Rayyanの「対応ファイル形式」ページには、EndNote(.enw)、RefMan/RIS(.ris)、BibTeX(.bib)、CSV(.csv)、PubMed/NBIB(.nbib)、PubMed XML(.xml)、Web of Science CIW(.ciw)、PDFが載っており、コンテナとして.txt、.docx、.ris.gz、.zipも挙げられています。出力時は「full record」または「include abstract」を選ぶようにとの注意書きがあり、抄録がないとRayyanのAI機能の精度が下がるとされています。このページにEmbaseの記載はないため、Embaseの出力形式は最新のRayyanヘルプで確認してください。概要ページには、一度に最大10ファイル(各100 MB)までアップロードできるとあります。
ステップ2:重複を削除し、その数を記録する。概要ページによれば、Rayyanは完全一致および近似の重複レコードを自動で検出・解決できます。自動検出は出発点にとどめ、削除した重複の数(PRISMAのフロー図の項目)を控え、統合された組を抜き取りで確認してください。PRISMA 2020は、同じ報告(reports)を指すレコードを「重複」と定義し、似ているだけの別報告(例:2つの学会に出された類似の抄録)は別個のレコードとして扱います。Cochraneハンドブックも、選別の最初の手順として、検索結果を文献管理ソフトで統合し、同じ報告の重複レコードを除くことを挙げています。
ステップ3:査読者を招待し、ラベルの命名を決め、パイロットを行う。概要ページは、チームで作業する場合に共同作業者を招待すること、除外理由やラベルは選別中にその場で作られるため、命名規則を事前に合意しておくことを勧めています。前章のCochraneの提案のように、最初に少数の文献で基準を試し、文言を修正してから全体に進みます。
ステップ4:ブラインドモードで選別する。概要ページは、ブラインドモードを、チームの判定を互いに隠して独立した選別を保つ機能として説明しています。全査読者が終えるまでオンのままにします。
ステップ5:コンフリクトを見つけて解決する。RayyanのコンフリクトFAQによると、コンフリクトを表示・解決できるのはブラインドモードがオフのときだけで(オフにできるのはレビューのオーナー)、「Filter by inclusion」で「Conflict」を選んで絞り込みます。解決方法はReview settings > Screeningで設定し、既定は「Consensus(合意)」です。
- Consensus:Include対Excludeの不一致がすべてコンフリクトです(「Maybe」だけでは該当しません)。同ページは、Rayyanはコンフリクトを自動では解決しないと述べています。査読者が話し合い、全員の判定が一致するまで各自が自分の判定を更新します。
- Majority(多数決):明確な多数がない場合(例:1対1、2対2)にのみコンフリクトとなります。決着には別の査読者が選別し、同ページは偶数ではなく奇数の査読者数を勧めています。
解決方法を変更しても、影響するのはその後の判定だけです。全文選別でも同じ手順で、解決済みのコンフリクトが再び現れることがあります。CochraneのMECIR項目C39が求めるとおり、選んだ方法と第三者のルールは、開始前にプロトコルへ書いておきます。
ステップ6:ガイドラインが求める範囲で除外理由を記録する。Rayyanは選別中に除外理由をラベルやメモとともに付けられます。報告の観点では、CochraneのMECIR項目C41が、タイトル・抄録段階の除外は件数で足りるとし、全文段階の除外には理由が必要としています。PRISMA 2020の項目16bも、適格に見えて除外した研究を引用し、除外理由を示すことを求めています。つまり、タイトル・抄録段階の理由コード化は報告上は任意ですが、監査のためには有用で、全文段階では必須です。
ステップ7:判定を出力して記録を保管する。エクスポートのヘルプページには、RefMan(.ris)、BibTeX(.bib)、EndNote(.enw)、CSV(.csv。Rayyanのデータはnotes列に入る)が挙がっており、抄録・判定・除外理由・ラベル・ユーザーのメモを含めるかどうか、全件か絞り込んだ一部かを選べます。判定のエクスポートはプロトコルとともに保管します。概要ページには、事前設定されたPRISMAフロー図を自動生成する機能があり、有料プランで利用できると記されています。使う場合は、ご自身のプランの内容を確認し、図の数値を自分で集計した件数と照合してください。
AI機能について。Rayyanのトップページは、機能の1つとしてAIによる関連度評価(ResearchPilot)を挙げています。こうしたツールを使った場合、PRISMA 2020の項目8は使用した自動化ツールの詳細の報告を求めており、レビューの記録として残るのは人間の査読者の判定です。
出典(いずれも2026年10月8日閲覧):対応ファイル形式、Understanding Rayyan(概要)、コンフリクトFAQ、エクスポート、Rayyanトップページ。
3. 各段階で記録する件数(PRISMA 2020)
PRISMA 2020の項目16aは、検索で特定したレコード数から含めた研究数までの検索・選別の結果を、できればフロー図で示すことを求めています。下の表は、各段階で控えるべき内容と、公開されているレビュー1本の実際の件数です。このレビューが使ったツールはRayyanではなくCovidenceです。件数の記録方法はツールに依存しないため、記録の例としてのみ示します(Ansari et al., 2026, Front Digit Health 8:1911937、CC BY 4.0。件数は結果の本文と図1の説明文の記載どおり)。
| 段階 | 記録する内容 | 例のレビュー(高血圧管理のチャットボット) |
|---|---|---|
| 特定 | 統合前のデータベース別の件数 | Embase 126、Scopus 114、Web of Science 43、PubMed 33、計316 |
| 重複削除 | 削除した重複の数 | 139(Covidence経由138、手作業1) |
| タイトル・抄録選別 | 選別した件数、除外した件数 | 177件を選別、147件を除外 |
| 全文評価 | 評価した報告数、理由つきの除外数 | 30件を評価、21件を除外 |
| 採用 | 含めた研究数 | 9 |
算術は毎回確認してください。126 + 114 + 43 + 33 = 316、316 − 139 = 177、177 − 147 = 30、30 − 21 = 9です(Rで確認済み)。ツールのフロー図とご自身の表計算が食い違う場合は、投稿前に原因を調べます。
4. Cohenのκ:実際のスクリーニングデータによる計算例
Cohenのκは、2名が実際に達成した一致を、各自の採用・除外の割合から偶然に期待される一致と比べる指標です。2×2表のセルを a(両者が採用)、b(Aが採用・Bが除外)、c(Aが除外・Bが採用)、d(両者が除外)とし、n = a + b + c + d とすると次のとおりです。
- 観察一致率 po = (a + d) / n
- 偶然の一致率 pe = [(a + b)(a + c) + (c + d)(b + d)] / n²
- κ = (po − pe) / (1 − pe)
データ。第3章と同じレビュー(Ansari et al., 2026)が、表8「Title and abstract screening inter-rater reliability」で、査読者のペアごとの2×2表の度数を公開しています(査読者はイニシャルで示されています)。スクリーニングデータは一切作成・加工していません。公表された度数からRでκを再計算し、著者らの報告値と照合しました。
SFA-YLのペア(a = 6、b = 13、c = 0、d = 40、n = 59)を手計算すると、po = 46/59 = 0.7797、pe = (19 × 6 + 40 × 53)/59² = 0.6418、κ = (0.7797 − 0.6418)/(1 − 0.6418) = 0.3849です。
library(irr)
a <- 6; b <- 13; c <- 0; d <- 40          # SFA-YL, 表8
n <- a + b + c + d
po <- (a + d) / n
pe <- ((a + b) * (a + c) + (c + d) * (b + d)) / n^2
(po - pe) / (1 - pe)                         # 0.3849238
r1 <- rep(c(1, 1, 0, 0), c(a, b, c, d))     # 1 = 採用
r2 <- rep(c(1, 0, 1, 0), c(a, b, c, d))
kappa2(cbind(r1, r2))                        # Kappa = 0.385, z = 3.75, p = 0.000177
全ペアのRの結果です(観察一致率とκは筆者の計算、「報告値」は著者らの値)。
| ペア | n | a / b / c / d | 観察一致率 | κ(R) | κ(報告値) |
|---|---|---|---|---|---|
| SFA-YL | 59 | 6 / 13 / 0 / 40 | 0.780 | 0.385 | 0.38492 |
| NAS-SA | 43 | 7 / 2 / 4 / 30 | 0.860 | 0.610 | 0.61027 |
| SFA-SA | 28 | 7 / 0 / 0 / 21 | 1.000 | 1.000 | 1 |
| NAS-SFA | 22 | 2 / 1 / 2 / 17 | 0.864 | 0.492 | 0.49231 |
| SA-YL | 16 | 2 / 3 / 0 / 11 | 0.813 | 0.478 | 0.47826 |
| AR-YL | 9 | 0 / 0 / 0 / 9 | 1.000 | 算出不可 | NaN |
6ペアの合計は177件で、第3章の選別件数と一致します。κが定義できる5ペアの平均は0.593(範囲0.385〜1.000)で、論文の「平均0.59、範囲0.38〜1.00」と一致します。
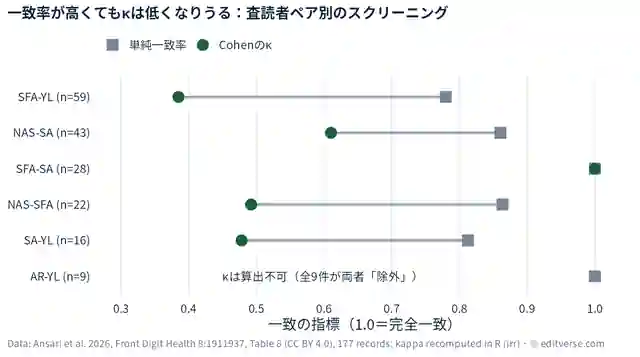
読み方:灰色の四角(一致率)と緑の丸(κ)の距離が大きいペアほど、偶然による一致の割合が大きいことを示します。
- 一致率とκは別の数字です。SFA-YLは59件中78%で一致しましたが、κは0.385です。両者が除外とした文献が多いため、偶然に期待される一致が大きい(pe = 0.642)からです。このペアの13件の不一致は、すべてAが採用・Bが除外の文献です(c = 0)。
- AR-YLは9件すべてで一致しましたが、全件が両者とも除外でpe = 1となり、κは0/0で定義できません。誰も採用しない表ではκは求まりません。
- 件数の少ないペアは不安定です。単純な大標本の標準誤差(nが小さいと精度が悪い近似)を使うと、SFA-YL(n = 59)の95%区間は約0.09〜0.68、SA-YL(n = 16)は0を下回る値から1を上回る値にまで及び、点推定値がほとんど情報を持たないことを示します。
- 6つの表をまとめると(筆者による説明用の計算で、著者らが報告した値ではありません。ペアごとに査読者が異なります)、24 / 19 / 6 / 128、観察一致率0.859、κ 0.572(近似95%区間0.42〜0.73)となります。
- 「0.41〜0.60は中等度」といった区分は慣例です。例の論文の著者らはMcHugh(2012)を引いてこの区分を使っていますが、McHugh自身が、この区分ではかなり低い一致でも「相当な(substantial)」一致と呼べてしまうと指摘しています。ラベルに頼らず、数値、元の表、対象とした文献(全件か、キャリブレーション用の一部か)を報告してください。
5. MethodsとResultsに何を書くか
以下はEditverseの編集上の提案であり、ジャーナルやPRISMAの規則ではありません。実際に行った内容に合わせて調整してください。
Methods(英文例):Records were imported into [tool, access date], duplicates were removed [automatically and checked manually], and two reviewers independently screened titles and abstracts with decisions hidden from each other. Disagreements were resolved by [discussion / a third reviewer]. Agreement between reviewers was [kappa = x on all n records / on a calibration sample of n records].
Resultsには、第3章のPRISMAの件数とフロー図を示します。フロー図の作成にはPRISMA 2020を、データベース検索そのものの報告にはPRISMA-S(Rethlefsen et al., 2021)を引用します。検索式は別の記事の主題です(本シリーズのPubMed検索式の作り方)。自動化ツールを使った場合は、その旨と役割を書きます。
6. 実データ:PubMedでRayyanに言及する論文数
PubMedの検索式は Rayyan[Title/Abstract] で、Entrez date(datetype=edat)による暦年別の件数です。2026年10月8日にNCBI E-utilities(esearch)で取得しました。2016年1件、2017年4件、2018年4件、2019年10件、2020年25件、2021年59件、2022年103件、2023年155件、2024年202件、2025年332件、2026年(10月8日まで)323件で、2016〜2026年の合計は1,218件です(これより前のEntrez dateの2件は図に含めていません)。
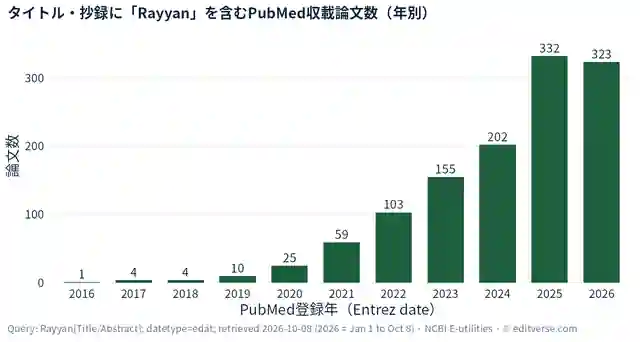
読み方:これは、タイトルまたは抄録にこの語が出てくる論文の数です。利用者数やこのツールを使ったレビューの数ではなく、どのツールが優れているかを示すものでもありません。
7. よくあるつまずき
- 全査読者が終える前にブラインドモードをオフにしてしまう。
- 「2名が選別した」とだけ書き、独立して作業したかを書かない(PRISMA 2020の項目8が求めています)。
- κを報告しながら、どの文献が対象かを書かない。
- 自動の重複件数やフロー図を、自分の表計算と照合せずに信用する。
- コンフリクトを見てから、解決ルールを決める(プロトコルで事前に決めるべきです)。
系統的レビュー・メタアナリシスの執筆面をサポートします
Editverseは、プロトコルの文章、PRISMA 2020など報告チェックリストへの整合、原稿の英文校正・体裁調整を共同作業でお手伝いします。スクリーニングの判断、解釈、結論はレビューチームのものです。採択まで追加料金なしでサポートを継続します(採否はジャーナルが判断します)。
まとめ
- 各段階の件数(データベース別、重複削除、選別、全文評価、理由つき除外、採用)を記録し、合計が合うか確認する。
- ブラインドで独立して選別し、コンフリクトの解決ルールは事前に決め、判定のエクスポートを保管する。
- κは補助的な指標で、今回確認したガイドラインが求めるものではない。2×2表、対象件数、注意点とともに示す。
- 例のレビューの6査読者ペア(177件)では、観察一致率が0.78〜1.00、κが0.385〜1.000(1ペアは算出不可)だった。
公費・研究費でのお支払い
見積書・請求書などの書類発行は公費・研究費でのお支払いのページをご覧ください。ご相談はお問い合わせから承ります。
関連記事
- システマティックレビューとは?やり方を8ステップで解説
- メタアナリシスとは?手順・フォレストプロットの読み方・よくある誤り
- PRISMA声明でシステマティックレビューを正しく報告する方法
- EQUATOR Networkの報告ガイドライン
- 文献レビューの執筆支援と研究倫理
- PROSPERO登録のガイド
- PubMed検索式の作り方(システマティックレビュー)
- スコーピングレビューのやり方
よくある質問
タイトル・抄録スクリーニングは2名で行う必要がありますか?
Cochraneハンドブック第4章では、研究の採否の最終判断に独立した2名以上が関わることは不可欠、初期のタイトル・抄録選別を2名で行うことは「望ましいが必須ではない」とされています。投稿先ジャーナルやプロトコルの要件もご確認ください。
κの報告は必須ですか?
閲覧した範囲では、Cochraneハンドブック第4章にもPRISMA 2020にもκを求める記載はありません。PRISMA 2020が求めるのは、各レコードを何名が選別したか、独立して作業したかです。κを報告する場合は、対象とした文献を明記してください。
一致率が高いのにκが低くなるのはなぜですか?
両者が除外とした文献が多いと、偶然の一致が大きくなるためです。例のレビューでは、あるペアが59件中78%で一致しましたが、κは0.385でした。
RayyanはPubMedやEmbaseの出力を取り込めますか?
Rayyanのヘルプには、PubMedのNBIBとPubMed XMLのほか、RIS、BibTeX、CSV、EndNote、Web of ScienceのCIWが対応形式として載っています。Embaseの記載はないため、Embaseの出力形式は最新のヘルプで確認してください。
コンフリクトはいつ確認できますか?
Rayyanのヘルプによると、ブラインドモードがオフのときだけです。オフにできるのはレビューのオーナーです。
参考資料
- Ouzzani M, Hammady H, Fedorowicz Z, Elmagarmid A. Rayyan-a web and mobile app for systematic reviews. Syst Rev. 2016;5:210. doi: 10.1186/s13643-016-0384-4. PMID: 27919275.
- Page MJ, McKenzie JE, Bossuyt PM, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71. doi: 10.1136/bmj.n71. PMID: 33782057. PMCID: PMC8005924(項目8、16a、16bを本文で確認)。
- Rethlefsen ML, Kirtley S, Waffenschmidt S, et al. PRISMA-S: an extension to the PRISMA Statement for Reporting Literature Searches in Systematic Reviews. Syst Rev. 2021;10:39. doi: 10.1186/s13643-020-01542-z. PMID: 33499930.
- Ansari SF, Abu Saifan NA, Alneyadi RK, et al. Effectiveness of chatbot interventions in individuals for hypertension management: a systematic review and narrative synthesis. Front Digit Health. 2026;8:1911937. doi: 10.3389/fdgth.2026.1911937. PMID: 42818756. CC BY 4.0(表8の度数とフロー図の件数の出典)。
- McHugh ML. Interrater reliability: the kappa statistic. Biochem Med (Zagreb). 2012;22(3):276-282. PMID: 23092060. PMCID: PMC3900052(全文を確認)。
- Lefebvre C, Glanville J, Briscoe S, et al. Chapter 4: Searching for and selecting studies [last updated March 2025]. In: Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions version 6.5.1. Cochrane; 2025. Cochraneハンドブック第4章(2026年10月8日閲覧)。
- NCBI E-utilities(esearch)。検索式
Rayyan[Title/Abstract]、2026年10月8日取得。R(irrパッケージ)による計算は筆者による。