【統計の書き方】論文における統計解析結果の報告方法
統計解析の結果を論文で正確に報告することは、研究の信頼性と再現性を保証する上で極めて重要です。本記事では、主要な統計手法の報告方法、よくある誤り、そしてジャーナルが求める統計報告の基準を解説します。
統計報告の基本原則
| 原則 | 内容 | 重要性 |
|---|---|---|
| 透明性 | 使用した統計手法をすべて明記 | 再現性の確保 |
| 正確性 | 正しい検定を選択し、正確に報告 | 結論の妥当性 |
| 完全性 | 必要な統計量をすべて報告 | メタ分析への貢献 |
| 適切性 | データに適した手法を選択 | 結果の信頼性 |
統計ソフトウェアの記載方法
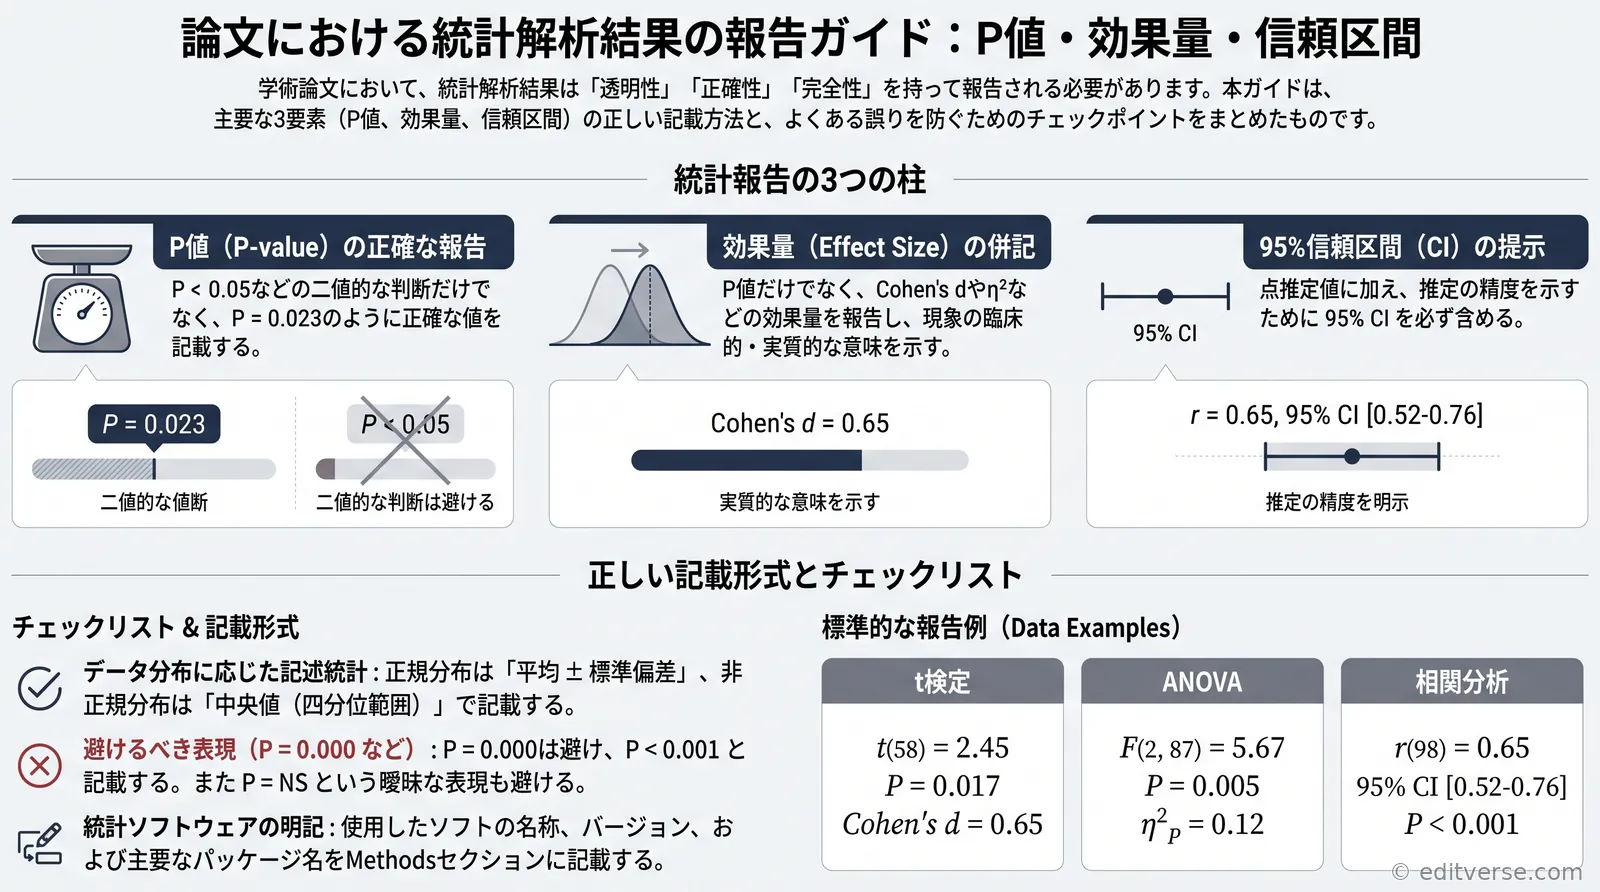
Methods セクションでの記載例:
“Statistical analyses were performed using R version 4.3.1 (R Foundation for Statistical Computing, Vienna, Austria) with the ‘lme4’ package for mixed-effects models. GraphPad Prism version 9.5.1 was used for generating figures. P values less than 0.05 were considered statistically significant.”
主要統計ソフトウェアの記載形式
| ソフトウェア | 記載例 |
|---|---|
| R | R version 4.3.1 (R Foundation for Statistical Computing) |
| SPSS | IBM SPSS Statistics version 28.0 (IBM Corp., Armonk, NY) |
| SAS | SAS version 9.4 (SAS Institute Inc., Cary, NC) |
| Stata | Stata version 17.0 (StataCorp LLC, College Station, TX) |
| GraphPad Prism | GraphPad Prism version 9.5.1 (GraphPad Software, San Diego, CA) |
| Python | Python 3.11 with scipy 1.11.0 and statsmodels 0.14.0 |
基本的な統計量の報告
記述統計の報告形式
| データ分布 | 報告内容 | 記載例 |
|---|---|---|
| 正規分布 | 平均 ± 標準偏差 | mean ± SD: 45.2 ± 8.3 years |
| 非正規分布 | 中央値(四分位範囲) | median (IQR): 12.5 (8.3-18.7) mg/dL |
| カテゴリデータ | 度数(割合%) | n (%): 45 (56.3%) |
注意: SD(標準偏差)と SEM(標準誤差)を混同しないでください。SDはデータのばらつき、SEMは平均値の精度を示します。記述統計には通常SDを使用します。
仮説検定の報告
t検定(t-test)
| 検定タイプ | 報告内容 | 記載例 |
|---|---|---|
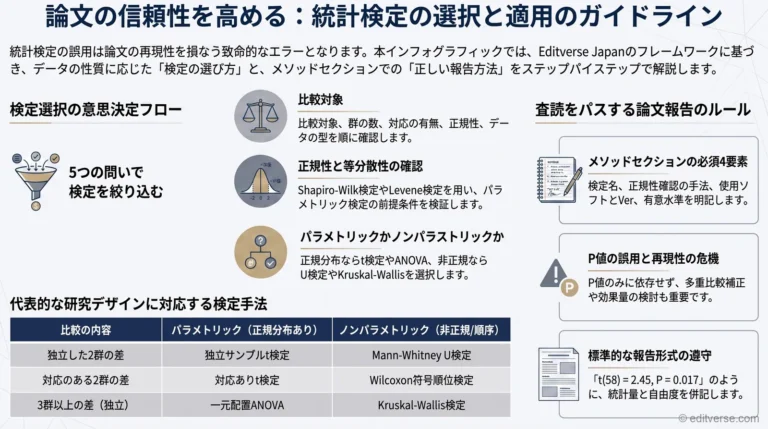
| 対応のないt検定 | t値、自由度、P値 | t(58) = 2.45, P = 0.017 |
| 対応のあるt検定 | t値、自由度、P値 | t(29) = 3.21, P = 0.003 |
| Welchのt検定 | t値、補正自由度、P値 | t(45.7) = 2.89, P = 0.006 |
完全な報告例:
“The treatment group showed significantly higher scores than the control group (mean ± SD: 78.5 ± 12.3 vs. 65.2 ± 14.1; t(58) = 3.89, P < 0.001, Cohen's d = 0.98)."
分散分析(ANOVA)
| 検定タイプ | 報告内容 | 記載例 |
|---|---|---|
| 一元配置ANOVA | F値、自由度、P値 | F(2, 87) = 5.67, P = 0.005 |
| 二元配置ANOVA | 各効果のF値、自由度、P値 | 主効果: F(1, 80) = 12.3, P < 0.001 交互作用: F(2, 80) = 3.45, P = 0.037 |
| 反復測定ANOVA | F値、自由度、P値(Mauchly検定含む) | F(2, 58) = 8.92, P < 0.001, η²p = 0.24 |
事後検定(Post-hoc test)の報告:
“Post-hoc comparisons using Tukey’s HSD test revealed significant differences between Group A and Group C (mean difference = 12.5, 95% CI [5.3, 19.7], P = 0.001) but not between Group A and Group B (P = 0.234).”
カイ二乗検定(Chi-square test)
| 検定タイプ | 報告内容 | 記載例 |
|---|---|---|
| カイ二乗検定 | χ²値、自由度、P値 | χ²(2) = 8.45, P = 0.015 |
| Fisherの正確検定 | P値(小サンプル時) | Fisher’s exact test, P = 0.032 |
| McNemar検定 | χ²値、P値 | McNemar’s χ²(1) = 6.25, P = 0.012 |
相関分析
| 検定タイプ | 報告内容 | 記載例 |
|---|---|---|
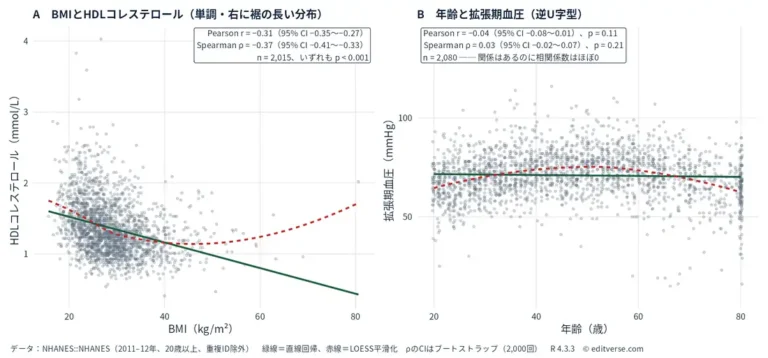
| Pearson相関 | r値、サンプルサイズ、P値 | r(98) = 0.65, P < 0.001 |
| Spearman相関 | ρ値、サンプルサイズ、P値 | ρ(98) = 0.58, P < 0.001 |
回帰分析
| 項目 | 報告内容 |
|---|---|
| 線形回帰 | β係数、SE、95% CI、P値、R² |
| ロジスティック回帰 | OR、95% CI、P値 |
| Cox回帰 | HR、95% CI、P値 |
ロジスティック回帰の報告例:
“After adjusting for age and sex, hypertension was significantly associated with increased risk of cardiovascular events (OR = 2.35, 95% CI [1.45-3.82], P = 0.001). The model showed good discrimination (c-statistic = 0.78) and calibration (Hosmer-Lemeshow P = 0.45).”
ノンパラメトリック検定
| 検定 | 用途 | 報告形式 |
|---|---|---|
| Mann-Whitney U検定 | 2群比較(対応なし) | U = 245, z = -2.45, P = 0.014 |
| Wilcoxon符号順位検定 | 2群比較(対応あり) | Z = -3.12, P = 0.002 |
| Kruskal-Wallis検定 | 3群以上の比較 | H(2) = 12.45, P = 0.002 |
| Friedman検定 | 反復測定(3時点以上) | χ²(2) = 15.67, P < 0.001 |
効果量(Effect Size)の報告
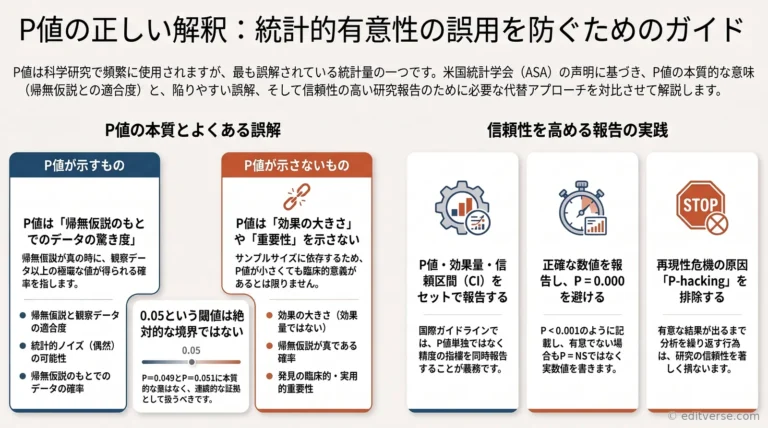
多くのジャーナルでは、P値だけでなく効果量の報告を求めています。
| 効果量 | 適用場面 | 解釈基準 |
|---|---|---|
| Cohen’s d | t検定 | 小: 0.2、中: 0.5、大: 0.8 |
| η² (eta-squared) | ANOVA | 小: 0.01、中: 0.06、大: 0.14 |
| η²p (partial eta-squared) | 複数要因ANOVA | 小: 0.01、中: 0.06、大: 0.14 |
| r (相関係数) | 相関分析 | 小: 0.1、中: 0.3、大: 0.5 |
| Cramér’s V | カイ二乗検定 | 小: 0.1、中: 0.3、大: 0.5 |
| OR / HR | 回帰分析 | 臨床的意義で判断 |
P値の報告ガイドライン
| 状況 | 報告形式 | 例 |
|---|---|---|
| P ≥ 0.001 | 正確な値を報告 | P = 0.023 |
| P < 0.001 | P < 0.001と記載 | P < 0.001 |
| 有意でない | 正確な値を報告 | P = 0.234(P = NS は避ける) |
避けるべき表現:
- P = 0.000(P < 0.001 を使用)
- P = NS または P > 0.05(正確な値を報告)
- P = 0.05(境界値は慎重に解釈)
- 「統計的に有意な傾向」(P = 0.05-0.10)
多重比較の補正
| 補正方法 | 特徴 | 報告例 |
|---|---|---|
| Bonferroni | 最も保守的 | Bonferroni-corrected P < 0.017 |
| Tukey HSD | ANOVA事後検定 | Tukey’s HSD, P = 0.023 |
| Holm | Bonferroniより検出力高い | Holm-adjusted P = 0.034 |
| FDR (Benjamini-Hochberg) | 多数の検定に適する | FDR-adjusted q = 0.045 |
信頼区間の報告
推奨される報告形式:
- 平均差: 12.5 (95% CI: 8.3 to 16.7)
- オッズ比: OR = 2.35 (95% CI: 1.45-3.82)
- ハザード比: HR = 0.65 (95% CI: 0.48-0.88)
- 相関係数: r = 0.65 (95% CI: 0.52-0.76)
サンプルサイズと検出力
| 項目 | 報告内容 |
|---|---|
| 事前検出力分析 | α水準、検出力(1-β)、想定効果量、必要サンプルサイズ |
| 事後検出力分析 | 観測された効果量に基づく達成検出力 |
| 使用ソフトウェア | G*Power, nQuery, PASS など |
報告例:
“Sample size was calculated a priori using G*Power 3.1. Assuming a medium effect size (Cohen’s d = 0.5), α = 0.05, and power = 0.80, a minimum of 64 participants per group was required. To account for potential dropouts (estimated 15%), we aimed to recruit 75 participants per group.”
よくある統計報告の誤り
| 誤り | 正しい対応 |
|---|---|
| 正規性を確認せずにパラメトリック検定を使用 | Shapiro-Wilk検定などで正規性を確認 |
| 多重比較の補正を行わない | 適切な補正方法を適用し報告 |
| 効果量を報告しない | P値と共に効果量を報告 |
| 信頼区間を省略 | 点推定値と95% CIを報告 |
| 欠測データの処理を記載しない | 欠測データの数と処理方法を明記 |
| 統計ソフトウェアのバージョンを記載しない | 使用ソフトウェアとバージョンを明記 |
統計報告チェックリスト
| チェック項目 | 確認内容 |
|---|---|
| □ 統計ソフトウェア | 名称とバージョンを記載 |
| □ 有意水準 | α = 0.05 などを明記 |
| □ 検定の選択理由 | データの性質に基づく説明 |
| □ 記述統計 | Mean ± SD または Median (IQR) |
| □ 検定統計量 | t, F, χ² などの値 |
| □ 自由度 | 該当する検定で報告 |
| □ P値 | 正確な値(P < 0.001 は例外) |
| □ 効果量 | Cohen’s d, η², OR など |
| □ 信頼区間 | 95% CI を報告 |
| □ 多重比較補正 | 補正方法と補正後P値 |
よくある質問(FAQ)
Q: P値が0.05ちょうどの場合、有意と言えますか?
A: 慣例的にP < 0.05を有意としますが、P = 0.05は境界線上です。効果量や信頼区間も含めて総合的に解釈し、「P = 0.05」と正確に報告することが推奨されます。
Q: 統計的に有意でない結果はどう報告すべきですか?
A: 「差がなかった」ではなく「有意な差は検出されなかった」と記載します。効果量と信頼区間も報告し、結果が臨床的に意味があるかどうかを議論します。
Q: 事後検出力分析は必要ですか?
A: 多くの統計学者は事後検出力分析の価値に疑問を呈しています。代わりに、効果量の信頼区間を報告することが推奨されます。
EditVerse Japanの統計サポート
EditVerse Japanでは、統計報告の英文校正に加え、統計専門家による記載内容のレビューサービスを提供しています。適切な検定の選択から報告形式まで、ジャーナルの要求に適合した統計セクションの作成をサポートします。
関連サービス:医学統計解析サポート
解析はできた。論文になっていない。
統計解析を請け負う会社は解析結果までしか提供せず、英文校正会社は統計そのものを扱いません。当社はその二つを一つの仕事として引き受けます。分布の確認からモデル選択、解析、Table 1と図表の作成、IMRAD形式の執筆までを定額¥238,000で(個別発注¥277,800)。単語数による加算はなく、アクセプトまで修正回数無制限です。