相関係数とは|求め方・ピアソンとスピアマンの違いと論文での書き方
相関係数(correlation coefficient)とは、2つの変数がどの程度そろって動くかを、−1から+1までの1つの数値で表す指標です。符号が向き(正・負)を、絶対値が強さを示し、0は直線的な関連(ピアソン)または単調な関連(スピアマン)がないことを意味します。両変数が連続量で、散布図がおおむね直線状に分布し極端な外れ値がなければピアソンの積率相関係数(Pearson’s r)を、順位データ・順序尺度・歪んだ分布・外れ値を含むデータにはスピアマンの順位相関係数(Spearman’s ρ)を使います。論文では係数の種類・値・95%信頼区間・p値・n を報告し、必ず先に散布図を確認してください。まったく異なるデータから同じ r が得られることがあるからです。
「相関係数」で上位に表示される日本語ページの多くは、定義・計算式・「0.7以上なら強い」という目安で終わっています。本記事は、相関係数を論文に書き、査読者に説明しなければならない研究者のために書きました。計算式とExcelの関数を1つの節で押さえたうえで、どの係数を選ぶか、強さの目安がなぜ統一されていないのか、信頼区間の求め方、Resultsに何を書くか、査読でよく指摘される4つの誤りまでを扱います。以下の数値はすべて公開データをRで解析した実際の結果で、再現できるようコードも掲載しています。
1. 相関係数が示すもの・示さないもの
相関係数が答えるのは、「一方の変数が大きいとき、もう一方も大きい(正)傾向にあるのか、小さい(負)傾向にあるのか。そしてその傾向はどれだけ一貫しているか」という限られた問いだけです。
| 値 | 意味 |
|---|---|
| +1 | 完全な正の関連(ピアソンでは全点が右上がりの直線上に並ぶ。スピアマンでは順位が完全に一致する) |
| 0 | 直線的(ピアソン)または単調な(スピアマン)関連がない。「関係がない」とは限らない |
| −1 | 完全な負の関連 |
相関係数からわからないことが3つあります。
- 傾き。r = 0.8 は「xが1単位増えるとyが0.8単位増える」という意味ではありません。傾きは回帰分析で扱うものです。
- 因果関係。2変数の相関は、第3の変数(交絡因子)や、性質の異なるサブグループが混ざることだけでも生じます(第7節のペンギンの例を参照)。
- 一致度。2つの測定法は、強く相関していても系統的にずれていることがあります。Bland と Altman は The Lancet 誌で、2つの臨床測定法の比較に相関を用いると誤解を招くことを示し、現在 Bland–Altman プロットと呼ばれている「差と平均のプロット」を提案しました[文献4]。「方法Bで方法Aを置き換えられるか」が問いであれば、相関係数は適切な方法ではありません。
2. 相関係数の求め方(計算式・手計算の例・Excel)
ピアソンの r は、x と y の共分散を、それぞれの標準偏差の積で割った値です。平均からの偏差の和で書くと次のようになります。
r = Σ(x − x̄)(y − ȳ) / √[ Σ(x − x̄)² × Σ(y − ȳ)² ]
2つのばらつきで割ることで、r は単位に依存しない値になります(mmHgをkPaに、kgをgに換算しても変わりません)。また、r は常に−1から+1の範囲に収まります。
実データによる手計算の例
アンスコムの4つのデータセットのうち1つ目を使います(Rに datasets::anscombe として収録、n = 11。第6節を参照)[文献5]。
| 手順 | 値 |
|---|---|
| 平均 | x̄ = 9.00、ȳ = 7.50 |
| Σ(x − x̄)(y − ȳ) | 55.01 |
| Σ(x − x̄)² | 110.00 |
| Σ(y − ȳ)² | 41.27 |
| r = 55.01 / √(110.00 × 41.27) | 55.01 / 67.38 = 0.816 |
有意かどうかの検定と信頼区間
r = 0 の検定には t = r√(n − 2) / √(1 − r²)(自由度 n − 2)を用います。この例では t = 0.816 × 3 / 0.578 = 4.24、自由度9、p = 0.002 です。Rの cor.test() はこれらの値を正確に再現し、さらに95%信頼区間 0.42〜0.95 を出力します。大切なのはこの区間のほうです。観測数がわずか11だと、r = 0.82 は「中程度」から「ほぼ完全」までのどの関連とも矛盾しません。
an <- datasets::anscombe
cor.test(an$x1, an$y1)   # r = 0.816, t = 4.24, df = 9, p = 0.002, 95% CI 0.42〜0.95
スピアマンの ρ の求め方
スピアマンの ρ は、ピアソンの式を値そのものではなく順位に当てはめたものです(同順位には平均順位を与えます)。同じデータで cor(rank(x), rank(y)) と cor(x, y, method = "spearman") を計算すると、どちらも 0.818 になります。教科書によく載っている簡便式 ρ = 1 − 6Σd² / [n(n² − 1)] が同じ答えになるのは、同順位がない場合だけです。
Excelでの計算
=CORREL(A2:A12, B2:B12)(または同じ値を返す =PEARSON(...))でピアソンの r が求まります。Excelにはスピアマン専用の関数がないため、補助列で各列を =RANK.AVG() で順位に変換し、2つの順位列に =CORREL() を適用します。また、Excelはp値や信頼区間を直接は出力しません。上の式で t を計算し、=T.DIST.2T(ABS(t), n−2) で両側p値を求めることはできますが、論文用の解析では、信頼区間を直接出力するソフトウェア(例:Rの cor.test())を使うほうが確実です。
3. ピアソンとスピアマン(とケンドール)の違いと使い分け
Schober らは Anesthesia & Analgesia 誌で、標準的な考え方を次のようにまとめています。ピアソンの積率相関係数は、2変数が同時に正規分布する(2変量正規分布の)データに通常用いられ、直線的な関係を測ります。正規分布しない連続データ、順序データ、影響の大きい外れ値を含むデータには、単調な関連の指標としてスピアマンの順位相関係数を使うことができます[文献1]。
| ピアソンの r | スピアマンの ρ(ロー) | ケンドールの τ(タウ) | |
|---|---|---|---|
| 測るもの | 直線的な関連 | 単調な関連(一貫して増加または減少。直線である必要はない) | 単調な関連(一致するペアと一致しないペアの数に基づく) |
| 計算に使うもの | 値そのもの | 値の順位 | 観測値のペア |
| データの種類 | 連続量(間隔尺度・比率尺度) | 連続量、または順序データ(リッカート項目、病期など) | スピアマンと同じ |
| 外れ値の影響 | 受けやすい(1点で r が大きく変わる) | はるかに受けにくい | はるかに受けにくい |
| 論文での典型的な用途 | 散布図がほぼ楕円状になる生理学的測定値 | 歪んだ検査値、スコア、質問紙の項目、外れ値を含む小標本 | 同順位の多い小標本 |
ケンドールの τ について Akoglu は、小さなデータセットで同じ順位が何度も繰り返される場合に使うべきだと述べています[文献3]。実際の臨床論文ではピアソンかスピアマンを報告するものが大半で、両方を報告する論文もあります。
実践的な判断手順
- まず散布図を描く。
- 点の雲がほぼ直線状・楕円状で、極端な点がない → ピアソン(正規性の確認方法は統計的仮定の確認(正規性・等分散性)を参照)。
- 一貫して増加・減少しているが曲線的、データが順位や順序尺度、または一部の点が他から大きく離れている → スピアマン。
- いったん上がってから下がる(またはその逆の)関係 → どちらの係数も適切な要約になりません。回帰分析で2次項やスプラインを使い、関係の形そのものをモデル化します。第5節に実例があります。
- どの係数をなぜ使ったかをMethodsに明記し、査読者が推測しなくて済むようにする。
両方を計算して見栄えのよいほうを報告する、という選び方はしないでください。p値を見る前に、データの種類と散布図から決めます。検定手法全般の選び方は統計検定の選び方で解説しています。
4. 「0.4は強い?」――相関係数の目安が統一されていない理由
「相関係数」と一緒によく検索されるのが、強い・弱いを判断する「目安」です。結論から言えば、唯一の基準はありません。Akoglu は心理学・政治学・医学で使われている3つの分類をまとめており、同じ係数でも分野によってラベルが異なります[文献3]。
| r(±) | Dancey & Reidy(心理学) | Quinnipiac University(政治学) | Chan YH(医学) |
|---|---|---|---|
| 0.9 | Strong(強い) | Very strong(非常に強い) | Very strong(非常に強い) |
| 0.7 | Strong(強い) | Very strong(非常に強い) | Moderate(中程度) |
| 0.5 | Moderate(中程度) | Strong(強い) | Fair(まずまず) |
| 0.3 | Weak(弱い) | Moderate(中程度) | Fair(まずまず) |
| 0.1 | Weak(弱い) | Negligible(無視できる程度) | Poor(乏しい) |
出典:Akoglu 2018, Table 1[文献3]。一部の行のみ抜粋。
つまり r = 0.7 は、ある分類では「非常に強い」、別の分類では「中程度」です。Akoglu の結論は、ラベルだけに頼らず、r の強さと向きを明示して報告すべきだというものです[文献3]。医学研究向けに広く引用されている Mukaka のガイドも、研究者による相関の誤用がよく見られることを指摘しています[文献2]。
日本で目にする目安
日本語のウェブサイトや講義資料では「0.7以上=強い、0.4〜0.7=中程度、0.2〜0.4=弱い」という目安が広く繰り返されていますが、一次資料が示されていないことがほとんどです。出典をたどれる日本の目安としては、日本疫学会「疫学用語の基礎知識:相関係数」があります。これは横山徹爾『はじめて学ぶやさしい疫学』(日本疫学会監修、改訂第2版、南江堂、2010)の表を転載したもので、|r| が0.8〜1.0で「強い」、0.5〜0.8で「中程度」、0.2〜0.5で「弱い」、0〜0.2で「無視できる程度」としています[文献6]。この基準では、r = 0.7 は「強い」ではなく「中程度」です。Cohen の小・中・大のような効果量の基準は、さらに別の目安です(効果量の計算を参照)。どの目安を使う場合も、その名前を明記してください。
原稿では、次の点に注意してください。
- 数値を95%信頼区間とともに報告する。ラベルは二の次です。
- ラベルを使うなら、依拠した分類を引用する(例:”interpreted according to Chan’s classification as cited in Akoglu”[文献3])。読者にどの基準なのかが伝わります。
- 強さと有意性を混同しない。大きな標本では、弱い相関でも高度に有意になります。後述のNHANESの例では、n = 2,015 で r = −0.31、p < 0.001 です。「統計的に有意」だからといって強いわけではありません(p値からわかること・わからないことはP値の正しい解釈を参照)。
5. Rによる実データ解析例(NHANES)
米国国民健康栄養調査(NHANES)のデータを収録したRパッケージ NHANES(v2.1.0)を使いました。パッケージの説明書によると、NHANES データフレームは、調査のオーバーサンプリングの影響を打ち消すために NHANESraw から再抽出した10,000行で構成されています。ここでは教育用のデータセットとして使用します。2011–12年調査の20歳以上の成人に限定し、重複した参加者IDを除いたうえで(n = 2,173)、2組の変数を調べました。
library(NHANES)
d <- NHANES[NHANES$SurveyYr == "2011_12" & NHANES$Age >= 20, ]
d <- d[!duplicated(d$ID), ]
# 組A:BMIとHDLコレステロール(mmol/L)
a <- d[complete.cases(d$BMI, d$DirectChol), ]
cor.test(a$BMI, a$DirectChol)                       # ピアソン
cor.test(a$BMI, a$DirectChol, method = "spearman")  # スピアマン
# スピアマンのρのブートストラップ95% CI(cor.testでは出力されない)
set.seed(2026)
bs <- replicate(2000, {
  i <- sample(nrow(a), replace = TRUE)
  cor(a$BMI[i], a$DirectChol[i], method = "spearman")
})
quantile(bs, c(0.025, 0.975))
# 組B:年齢と拡張期血圧(非現実的な0の記録8件を除外)
b <- d[complete.cases(d$Age, d$BPDiaAve) & d$BPDiaAve > 0, ]
cor.test(b$Age, b$BPDiaAve)
cor.test(b$Age, b$BPDiaAve, method = "spearman")
# 組Bの関係の形:年齢階級別の平均と2次回帰モデル
tapply(b$BPDiaAve, cut(b$Age, c(20, 30, 40, 50, 60, 70, Inf), right = FALSE), mean)
summary(lm(BPDiaAve ~ Age + I(Age^2), data = b))
結果(R 4.3.3 の実際の出力、丸め後)
| 組 | n | ピアソン r[95% CI] | p | スピアマン ρ[95% CI*] | p |
|---|---|---|---|---|---|
| A:BMIとHDLコレステロール | 2,015 | −0.31[−0.35, −0.27] | < 0.001 | −0.37[−0.41, −0.33] | < 0.001 |
| B:年齢と拡張期血圧 | 2,080 | −0.04[−0.08, 0.01] | 0.11 | 0.03[−0.02, 0.07] | 0.21 |
*ピアソンのCIは cor.test(Fisherのz変換)による。スピアマンのCIはパーセンタイル・ブートストラップ(2,000回リサンプリング、seed 2026)による。95%信頼区間そのものの意味は信頼区間の解釈で解説しています。
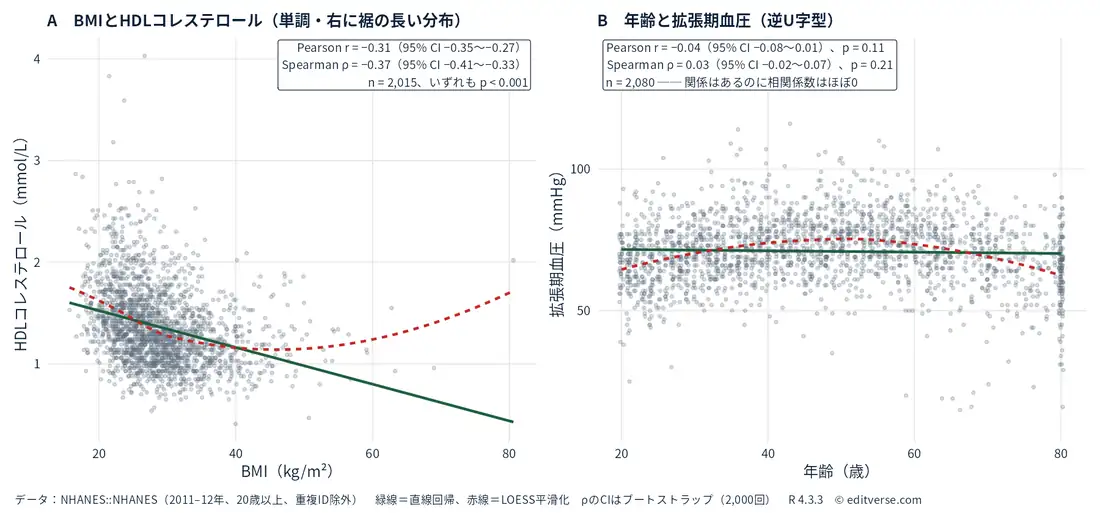
図の読み方:相関係数がとらえるのは、関係の形のうち1種類だけです。形が曲線的だと、関係を過小評価したり(A)、完全に見落としたり(B)します。
パネルAの読み方
BMIが高いほどHDLコレステロールは低くなりますが、BMIが約40を超えると低下は頭打ちになります。また、両変数とも右に裾の長い分布です(この標本の歪度はHDLが1.15、BMIが1.38)。関係は単調ですが直線ではないため、スピアマンの ρ(−0.37)のほうがピアソンの r(−0.31)より絶対値が大きくなっています。ここでは、1つの数値で要約するならスピアマンのほうが適しています。(右端で赤い曲線が上向いている部分は、BMI 50超のわずか18人のデータに基づくもので、深読みすべきではありません。)
パネルBの読み方
拡張期血圧の平均は、20〜29歳の67.0 mmHgから50〜59歳の75.5 mmHgまで上がり、70歳以上では64.7 mmHgに下がります。2次回帰はこの形をはっきりととらえます(年齢の両項とも p < 0.001、ピークは約49歳、R² = 0.11)。それにもかかわらず、ピアソンの r は−0.04、スピアマンの ρ は0.03で、いずれも有意ではありません。「年齢と拡張期血圧に相関はなかった」と報告すれば、技術的には正しくても科学的には誤りです。散布図を示すべき最大の理由がここにあります。
データクリーニングに関する注意
2011–12年の成人データには、拡張期血圧が0 mmHgと記録された値が8件あります。これらを含めると、ピアソンの r は−0.035から−0.056に変わる一方、スピアマンの ρ はほとんど動きません(0.028から0.020)。ピアソンのほうが非現実的な値の影響を受けやすいことを示す、小さいながらも実際の例です。こうした値の扱いは解析前に決め、Methodsに記載してください。
6. 同じ r でもデータは違う:アンスコムの例
1973年、統計学者 F. J. Anscombe は、要約統計量は一致するのに散布図はまったく異なるよう設計した4つの小さなデータセットを発表しました(現在はRに datasets::anscombe として収録)[文献5]。4つともピアソンの r = 0.82(各 n = 11)です。同じデータでスピアマンの ρ をRで計算すると、それぞれ異なる姿が見えてきます。
| セット | パターン | ピアソン r | スピアマン ρ |
|---|---|---|---|
| 1 | ほぼ直線 | 0.82 | 0.82 |
| 2 | なめらかな曲線 | 0.82 | 0.69 |
| 3 | 完全な直線+外れ値1点 | 0.82 | 0.99 |
| 4 | 1点を除いてxがすべて同じ(てこ比の大きい1点) | 0.82 | 0.50 |
an <- datasets::anscombe
sapply(1:4, function(k) c(
  r   = cor(an[[paste0("x", k)]], an[[paste0("y", k)]]),
  rho = cor(an[[paste0("x", k)]], an[[paste0("y", k)]], method = "spearman")))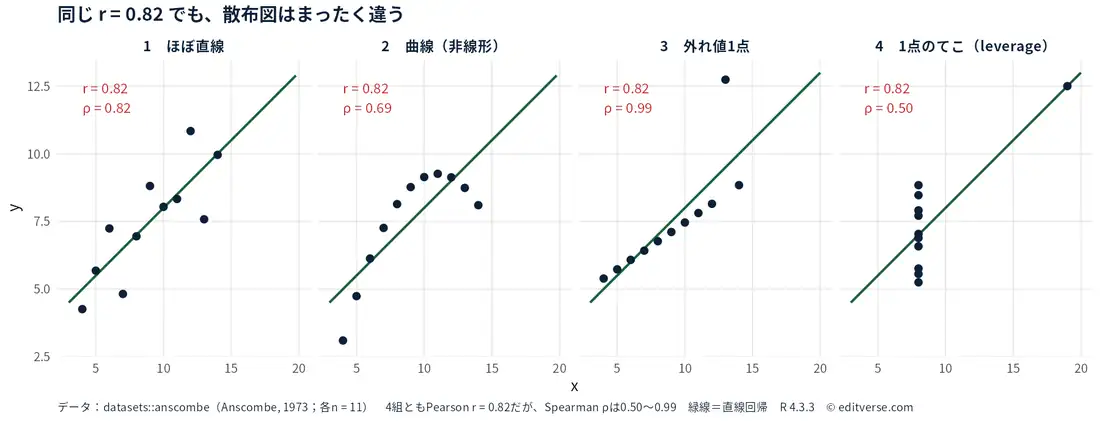
図の読み方:r = 0.82 という同じ数値が、きれいな直線にも、曲線にも、1つの外れ値で崩れた直線にも、1点だけが生み出した相関にも当てはまります。どれなのかは散布図を見なければわかりません。
セット3では、1つの外れ値が、それ以外はほぼ完全な直線であるデータのピアソン相関を引き下げています。順位を使うスピアマンはほとんど影響を受けません。セット4では、たった1点がピアソン相関のすべてを生み出しています。「r = 0.82, p = 0.002」しか見ていない査読者には、これらを区別できません。相関が主要な結果である場合に、散布図を本文または補足資料に示すことが望ましいのはこのためです。図の準備については出版品質の図の作り方を参照してください。
7. 査読で指摘される4つの誤り
相関係数について査読でよく指摘されるのは、次の4点です。統計に関するその他の典型的な指摘は査読で指摘される統計エラー10選にまとめています。
誤り1:散布図なしで相関を報告する
理由は第5節と第6節で見たとおりです。散布図は本文か補足資料に載せてください。
誤り2:p < 0.05 を「強い」と解釈する
有意性はnに左右されますが、強さは左右されません。Akoglu 自身の例示データでは、0.31の相関と0.64の相関が、同じように非常に小さなp値を示していました[文献3]。係数とCIを報告し、その大きさは選んだ分類に合った言葉で表現してください。
誤り3:サブグループを無視する(シンプソンのパラドックス)
palmerpenguins データセット(嘴の計測値がそろったペンギン n = 342)では、嘴の長さと嘴の深さは全体では負の相関を示します(r = −0.24、p < 0.001)。ところが種ごとに見ると、相関は正です。アデリーペンギン(Adelie)r = 0.39(95% CI 0.25〜0.52、n = 151)、ヒゲペンギン(Chinstrap)r = 0.65(0.49〜0.77、n = 68)、ジェンツーペンギン(Gentoo)r = 0.64(0.53〜0.74、n = 123)。両方の変数の値が異なるグループをひとまとめにしたことで、符号が逆転したのです。臨床データでも、性別、施設、疾患のサブタイプを無視すると同じことが起こりえます。
library(palmerpenguins)
p <- na.omit(penguins[, c("species", "bill_length_mm", "bill_depth_mm")])
cor.test(p$bill_length_mm, p$bill_depth_mm)          # 全体(プール)
by(p, p$species, function(q) cor.test(q$bill_length_mm, q$bill_depth_mm)$estimate)
# 種で調整した偏相関係数(残差どうしの相関)
rx <- resid(lm(bill_length_mm ~ species, data = p))
ry <- resid(lm(bill_depth_mm  ~ species, data = p))
cor(rx, ry)   # 0.53
偏相関係数(partial correlation)で調整する
「種の内部での」関連を1つの数値で報告する方法の1つが、偏相関係数です。各変数から種の影響を取り除き、残った部分どうしの相関をとります。ペンギンでは+0.53(自由度338、p < 0.001)となり、全体を単純にまとめた r の−0.24とは対照的です。ただし、偏相関係数が調整するのは指定した変数だけです。どの交絡因子が重要かを考えることの代わりにはならず、調整変数が1〜2個を超える場合は、回帰モデルで報告するほうが通常はわかりやすくなります。
誤り4:相関で一致度や因果関係を示そうとする
測定法の比較には Bland–Altman 分析を使います[文献4]。因果に関する問いでは、相関はせいぜい出発点にすぎません。回帰モデルで交絡因子を調整し、研究デザインをありのままに記述してください。
このほかにも、何十もの相関を検定して有意なものだけを報告すること(多重比較補正を参照)や、同じ人から繰り返し測定した値を独立した観測として相関を計算することが、よく問題になります。
8. 論文での相関係数の書き方
Methods(統計解析)の英文例
Associations between continuous variables were assessed with Spearman’s rank correlation coefficient because the variables were right-skewed on visual inspection of histograms and scatter plots. 95% confidence intervals for ρ were obtained by percentile bootstrap (2,000 resamples). Analyses were performed in R version 4.3.3.
和訳:連続変数間の関連は、ヒストグラムと散布図の目視で両変数が右に歪んでいたため、スピアマンの順位相関係数で評価した。ρの95%信頼区間はパーセンタイル・ブートストラップ法(2,000回リサンプリング)で求めた。解析にはR version 4.3.3を用いた。
Resultsの英文例(上記NHANESの出力を使用)
APAスタイル(心理学、教育学、多くの社会科学)。相関係数は1を超えないため、APAでは小数点の前の0を省略します。
BMI was negatively correlated with HDL cholesterol, Spearman’s ρ = −.37, 95% CI [−.41, −.33], p < .001, n = 2,015.
APAの論文では、nの代わりに括弧内に自由度(n − 2)を示すこともよくあります(例:rs(2013) = −.37)。読者が標本サイズを復元できれば、どちらでも構いません。ほかの検定の対応する書式は統計解析結果の報告方法にまとめています。
医学系ジャーナルのスタイル(多くの臨床系ジャーナルは小数点の前の0を残します。投稿先の投稿規程を確認してください)。
BMI was negatively correlated with HDL cholesterol (Spearman’s ρ = −0.37; 95% CI, −0.41 to −0.33; P < 0.001; n = 2,015).
和訳:BMIはHDLコレステロールと負の相関を示した(スピアマンのρ = −0.37、95% CI −0.41〜−0.33、P < 0.001、n = 2,015)。
有意でない結果や曲線的な関係では、係数だけで終わらせず、関係の形を記述します。
Age was not linearly correlated with diastolic blood pressure (Pearson’s r = −0.04; 95% CI, −0.08 to 0.01; P = 0.11); however, the scatter plot showed an inverted-U pattern, with diastolic pressure highest in participants aged 50–59 years (Figure 1B).
和訳:年齢と拡張期血圧に直線的な相関は認められなかった(ピアソンのr = −0.04、95% CI −0.08〜0.01、P = 0.11)。しかし散布図では逆U字型のパターンがみられ、拡張期血圧は50〜59歳の参加者で最も高かった(図1B)。
報告チェックリスト
| 項目 | 例 |
|---|---|
| どの係数か | “Spearman’s ρ”(単に “correlation” としない) |
| その係数を選んだ理由 | “because both variables were right-skewed” |
| 値(小数第2位まで) | ρ = −0.37 |
| 95% CIとその算出方法 | −0.41〜−0.33(ブートストラップ) |
| 正確なp値、または p < 0.001 | p < 0.001 |
| 実際に解析したn(欠測を除いた後) | n = 2,015 |
| 外れ値・非現実的な値の扱い | “8 diastolic values of 0 mmHg were excluded” |
| 散布図 | Figure 1 または Supplementary Figure S1 |
| ソフトウェアとバージョン | R 4.3.3 |
日本人研究者が英語で書く際、「相関が認められた」を直訳して “a correlation was recognized” とすることがあります。査読者にとっては “was correlated with” や “showed a weak negative correlation with” のほうが自然に読めます。また、強さを表す言葉が、報告した数値と合っていることも期待されます。
9. Editverse Japanがお手伝いできること
係数の選択、前提条件の確認、図の作成、報告文の作成は、正当な統計面・言語面の支援です。一方、その関連が研究課題にとって何を意味するかという解釈と、そこから導く結論は、著者ご自身が担うものです。これはICMJEの著者資格基準に沿った考え方です。統計解析サポートの全体像は統計解析サービスのページでご覧いただけます。
医学統計解析サポート(¥79,800)
データセットと解析計画をお送りください。統計の専門スタッフが、投稿先ジャーナルの要件に合わせてR・Stata・SPSS・SASで、研究者の方と一緒に解析を進めます。データにピアソン・スピアマン・回帰モデルのどれが適しているかの確認から、多変量解析・生存時間解析、サンプルサイズ計算まで対応します。解析コードと結果レポートを納品し、Methods・Resultsの執筆も支援します。料金は語数ではなく原稿1本単位で、採択まで追加料金なしでサポートを継続します(採否はジャーナルの編集者・査読者が判断します)。公費でのお支払い用の請求書も発行できます。
まだ原稿がなく、生データから始める場合は、データから論文へ|統計解析+執筆(¥238,000)で、解析と論文執筆支援を組み合わせて進められます。解釈の方向性は研究者ご自身が決めます。
相関についての査読コメントをすでに受け取っている場合は、査読対応・統計再解析(¥98,000)で、再解析、再現可能なRコード、修正した図表、統計に関する各コメントへのポイントごとの回答まで対応します。よくある指摘と回答のしかたは査読で統計を指摘されたらで紹介しています。
まとめ
- 相関係数(−1〜+1)は関連の向きと一貫性を測ります。ピアソンの r は直線的な関連、スピアマンの ρ は単調な関連です。
- ほぼ直線的でほぼ正規分布し、極端な外れ値のない連続データにはピアソン、順位・順序尺度・歪んだデータ・外れ値を含むデータにはスピアマンを使います[文献1]。
- 「強い」「中程度」といったラベルは分類によって異なり、r = 0.7 はある分類では「非常に強い」、別の分類では「中程度」です[文献3]。日本疫学会の用語集の目安でも「中程度」です[文献6]。数値を95% CIとともに報告し、ラベルを使うなら依拠した分類を引用します。
- r は共分散を2つの標準偏差の積で割った値です。Excelでは =CORREL を使い、スピアマンは RANK.AVG で求めた順位に =CORREL を適用します。小標本では信頼区間が広くなります(n = 11、r = 0.82 で95% CI 0.42〜0.95)。
- 有意性は強さではありません。n = 2,015 では r = −0.31 で p < 0.001 になります。
- 必ず散布図を示します。NHANESの実データでは r ≈ 0 なのに明確な逆U字型の関係があり、アンスコムの例では同じ r = 0.82 から4つの異なるパターンが現れます。
- 相関は一致度(Bland–Altman を使う[文献4])でも因果関係でもありません。シンプソンのパラドックスがないかサブグループも確認します。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 論文における統計解析結果の報告方法
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- P値の正しい解釈|統計的有意性の誤用を避けるガイド
- 信頼区間の解釈|95% CIの正しい意味と論文での報告方法
- 統計的仮定の確認|正規性・等分散性の検証と論文記述
- 統計エラー10選|査読で指摘される前に確認すべき統計的問題
- リッカート尺度の分析|個別項目と尺度得点の報告方法
- 相関と交絡|見かけの関係を疑う調整の方法
- 回帰分析との違いと使い分け
- 因子分析の論文での書き方|因子数・負荷量・CFAの適合度
よくある質問
Q. ピアソンとスピアマンの相関係数の違いは何ですか?
ピアソンのrは、2つの連続変数がどれだけ直線に当てはまるかを測り、値そのものから計算します。スピアマンのρは順位から計算し、関係が曲線的であっても2つの変数が一貫してそろって増減するかを測ります。順序データ、歪んだデータ、外れ値を含むデータにはスピアマンが適しています(Schober ら, 2018)。
Q. 相関係数はいくつ以上なら「強い」と言えますか?
共通の基準値はありません。公表されている分類によって異なり、r = 0.7 は心理学の分類では「強い」、政治学の分類では「非常に強い」、医学の分類では「中程度」とされます(Akoglu, 2018)。日本疫学会の用語集の目安(0.5〜0.8)でも「中程度」です。係数を95%信頼区間とともに報告し、ラベルを使う場合はどの分類に従ったかを引用してください。
Q. 相関が有意(p < 0.05)なら、関係は強いということですか?
いいえ。p値は標本サイズに大きく左右されます。本記事のNHANESの例では、参加者2,015人で r = −0.31 は p < 0.001 ですが、この大きさの係数は分類によって「弱い」から「中程度」と表現されます。強さは係数とその信頼区間から読み取るもので、p値から読み取るものではありません。
Q. 相関係数とその95%信頼区間はどのように求めますか?
Excelでは =CORREL(範囲1, 範囲2) でピアソンのrが求まります。スピアマンのρは、両方の列を RANK.AVG で順位に変換し、その順位に CORREL を適用します。Excelは信頼区間を出力しません。ピアソンのrについては、Rの cor.test() がFisherのz変換に基づく95%信頼区間を出力します。スピアマンのρについては cor.test() は信頼区間を出さないため、パーセンタイル・ブートストラップ(参加者を例えば2,000回リサンプリング)が手軽な方法です。用いた方法はMethodsに記載してください。
Q. 2つの測定法が一致していることを相関係数で示せますか?
いいえ。2つの方法は、一方が常に他方より高い値を示していても強く相関することがあります。Bland と Altman は、測定法の比較に相関を用いると誤解を招くことを示し、代わりに差と平均のプロット(Bland–Altmanプロット)を提案しました(Bland & Altman, 1986)。
参考資料
- Schober P, Boer C, Schwarte LA. Correlation Coefficients: Appropriate Use and Interpretation. Anesth Analg. 2018;126(5):1763-1768. doi: 10.1213/ANE.0000000000002864. PMID: 29481436.
- Mukaka MM. Statistics corner: A guide to appropriate use of correlation coefficient in medical research. Malawi Med J. 2012;24(3):69-71. PMID: 23638278. PMCID: PMC3576830.
- Akoglu H. User’s guide to correlation coefficients. Turk J Emerg Med. 2018;18(3):91-93. doi: 10.1016/j.tjem.2018.08.001. PMID: 30191186. PMCID: PMC6107969.
- Bland JM, Altman DG. Statistical methods for assessing agreement between two methods of clinical measurement. Lancet. 1986;1(8476):307-310. PMID: 2868172.
- Anscombe FJ. Graphs in Statistical Analysis. The American Statistician. 1973;27(1):17-21. doi: 10.1080/00031305.1973.10478966.(PubMed未収載。Crossrefで確認)
- 日本疫学会. 疫学用語の基礎知識「相関係数」(横山徹爾『はじめて学ぶやさしい疫学』日本疫学会監修, 改訂第2版, 南江堂, 2010, pp. 89-100 より許可を得て転載された表). https://jeaweb.jp/glossary/glossary026.html
データ・ソフトウェア
- NHANES Rパッケージ v2.1.0(Pruim R)。データは米国国立保健統計センター(NCHS)による:CRAN: NHANES
- palmerpenguins Rパッケージ(Horst AM, Hill AP, Gorman KB):palmerpenguins
- R Core Team. R: A language and environment for statistical computing(R 4.3.3):The R Project
- ICMJE. Defining the Role of Authors and Contributors:ICMJE Recommendations