カイ二乗検定とFisher正確検定|論文での使い分けと報告例文
2つのカテゴリ変数の関連を調べるときは、表の度数(カウント)が十分に大きければカイ二乗検定(χ²検定)を、度数が小さければFisherの正確確率検定を使います。従来の目安は、2×2分割表のすべてのセルで期待度数が5以上あることです。どちらを使う場合も、P値を見る前に検定を決めて解析計画に書き、論文では検定名・両側検定であること・度数の表を示します。本記事では、実データの小さな度数の表に両方の検定をRで適用して結果がどう変わるかを確認し、MethodsとResultsの英文例(ご自身の解析計画に合わせて調整してください)を示します。
本記事が扱うのは、2×2表およびr×c表(行数r・列数c)の度数についての関連の検定(独立性の検定)だけです。1つのカテゴリ変数の分布を調べる適合度検定や、ExcelやSPSSの画面操作の手順は扱いません。検定全般の選び方は統計検定の選び方を、2つの連続変数の関連は相関係数(ピアソン・スピアマン)をご覧ください。
1. 2つの検定は何をしているのか
どちらの検定も、度数の表について「2つの変数は独立か」という同じ問いに答えます。違いは、P値の求め方です。
| Pearsonのカイ二乗検定 | Fisherの正確確率検定 | |
|---|---|---|
| 帰無仮説 | 2つの変数は独立(関連なし) | 独立。2×2表ではオッズ比 = 1 と同値 |
| 統計量 | X² = Σ (O − E)² / E(全セルの合計) | 不要。行と列の合計を固定したときの表の超幾何分布からP値を求める |
| 期待度数 E | (行合計 × 列合計) / N | P値の計算には使わない |
| P値の求め方 | 自由度 (r − 1)(c − 1) のカイ二乗分布から求める。近似であり、度数が大きいほど精度が上がる | 厳密法。観測された表と同程度、またはそれより極端な表の確率を合計する |
| 典型的な用途 | 標本サイズが大きい場合 | 小標本向けだが、どの標本サイズでも有効 |
| Rの関数(statsパッケージ) | chisq.test() |
fisher.test() |
表の根拠:カイ二乗統計量・期待度数・自由度の説明はKim(2017)[文献1]とHazra と Gogtay(2016)[文献2]、Fisher正確検定が超幾何分布に基づく厳密検定でどの標本サイズでも有効であることはKim(2017)[文献1]、Rの関数の挙動は chisq.test と fisher.test のRヘルプによる。以下、Fisherの正確確率検定を「Fisher正確検定」と表記します。
結果を報告するときに押さえておきたい点が2つあります。
- Fisher正確検定の両側P値。Rの
fisher.test()は、観測された表の確率以下であるすべての表を「より極端」とみなし、それらの確率を合計します(Rヘルプ)。ほかのソフトでは両側P値の定義が異なる場合があり、ソフトウェア名を書く理由の1つです。 - Fisher正確検定のオッズ比。2×2表で
fisher.test()が返すのは、単純な標本オッズ比ではなく、条件付き最尤推定値です(Rヘルプ)。両者は近い値になりますが、一致はしません。
どちらの検定でも解決しない前提
どちらの検定も、観測値が互いに独立であることを前提にします。同じ参加者を2回測定する(治療前後など)対応のあるデータには、Pearsonのカイ二乗検定ではなくMcNemar検定(カイ二乗検定の仲間)を使います[文献2]。用量水準のように順序のあるカテゴリには、その順序を利用する傾向性のカイ二乗検定があります[文献2]。また、有意な検定結果は因果関係も関連の大きさも示しません。効果量も合わせて報告してください(効果量の計算を参照)。
2. 使い分けの考え方|公表されているガイダンス
「この条件ならこちら」という、すべての統計家が認める単一のルールはありません。以下の文献は意見が分かれており、閾値を1つ暗記するよりも、4つの立場を知っておくほうが実務では役に立ちます。
| 出典 | 内容 |
|---|---|
| 従来の目安(Kim, 2017;Hazra と Gogtay, 2016)[文献1・2] | カイ二乗検定は近似であるため、十分な標本サイズが必要。期待度数が5未満のセルが全体の20%以下で、かつ期待度数が1未満のセルがない場合にだけ適用できる。期待度数5未満のセルが20%を超えるときはFisher正確検定を使う。2×2表では、4つの期待度数がすべて5以上であることを意味する |
| Campbell(2007), Statistics in Medicine[文献3] | 現在の推奨の多くは、最小期待度数が5以上ならカイ二乗検定、そうでなければFisher-Irwin検定(Fisher正確検定)とする(FisherとCochranに従う)。Campbellは、Cochranによれば5という数字は恣意的に選ばれたものだと指摘している。7種類の両側検定を比較したシミュレーションでは、最小期待度数が1以上なら「N−1」カイ二乗検定、そうでなければFisher-Irwin検定とする方針が最良で、Cochranの推奨より検出力が高かった |
| Lydersen, Fagerland, Laake(2009), Statistics in Medicine[文献4] | 無条件検定は有意水準を保ち、中程度から小規模の標本ではFisher正確検定より一般に検出力が高い。ミッドP補正をかけたFisher正確検定は、無条件検定とほぼ同じ結果になる。著者らは、従来のFisher正確検定は実質的にまったく使うべきではないと結論している |
| Neuhäuser と Ruxton(2025), Pharmaceutical Statistics[文献5] | 観測データによってカイ二乗検定からFisher検定へ切り替えるのは統計の実務では珍しく、かつ不要である。Pearsonのカイ二乗検定はどの標本サイズでも厳密検定として実施できるため。データに関係なく、常に厳密検定を使うことを推奨しており、そうすれば検定を事前に規定できる |
「N−1」検定とは、Pearsonの統計量に (N − 1)/N を掛けたものです(MedCalcマニュアル。Campbell 2007とRichardson 2011を引用)。第3節の表ではX²が4.388から4.365に変わるだけで、Nが小さい場合を除き影響は大きくありません。
論文を書くうえでの実務的な読み方
以下は、これらの文献に対するEditverseの実務上の読み方であり、特定の文献に書かれたルールではありません。
- 事前に規定する。Neuhäuser と Ruxton の主張の核心は、手元のデータによって検定が変わってはならない、という点です。解析を始める前に、解析計画またはMethodsに検定の選択を書いておきます。
- P値で検定を選ばない。0.05を下回るかどうかを見てから検定を選ぶのは、選択的報告の一種です。第3節に、よく使われる方法の結果が0.05をまたぐ実際の表を示します。
- 分野・ジャーナルの慣行を確認する。「期待度数が5未満ならFisher」という従来の目安は、上記の入門的な文献に載っている慣行で[文献1・2]、
fisher.test()はRに組み込まれた厳密検定です。査読者や共著者がミッドP検定や無条件検定を望む場合(Lydersenら, 2009)、それも正当な選択であり、名称を明記します。 - 観測度数を必ず報告する。読者が好みの検定で再計算できるようにするためです。
イェーツの連続性補正(Yates補正)
2×2表では、Rの chisq.test() は既定(correct = TRUE)でイェーツの連続性補正を適用します。各セルの |O − E| から0.5を引く処理ですが、差そのものより多く引くことはありません(Rヘルプ)。補正するとP値は大きくなり、より保守的になります。小標本では、Fisher正確検定もYates補正も、補正なしのカイ二乗検定より保守的な結果になります[文献2]。Campbell(2007)のシミュレーションでは、Yatesの検定は比較された7つの検定の1つでしたが、最良の方針には含まれませんでした[文献3]。既定の設定が結果を黙って変えるため、補正を適用したかどうかを必ず明記してください。2×2より大きい表では、Rは連続性補正を行いません。
3. Rによる実例|高血圧歴と低出生体重
データ。MASS::birthwt には、1986年にマサチューセッツ州スプリングフィールドのBaystate Medical Centerで収集された189件の出生が収録されています(Rヘルプに記載の出典:Hosmer & Lemeshow, Applied Logistic Regression, 1989)。ここで使う2変数は、ht(高血圧歴)と low(出生体重が2.5 kg未満)です。高血圧歴のある女性は189人中12人だけなので、小さなセルが1つ生じます。これは検定の選び方を学ぶための教材であり、臨床的な結論ではありません。データは観察研究で、調整を行っておらず、1つの病院のものです。
# R 4.3.3; MASS 7.3.60.0.1
tab <- with(MASS::birthwt,
  table(Hypertension = factor(ht,  0:1, c("No","Yes")),
        LowBW        = factor(low, 0:1, c("No","Yes"))))
tab
round(prop.table(tab, 1), 3)          # 行ごとの割合

chi <- chisq.test(tab, correct = FALSE)
round(chi$expected, 2)                # 期待度数:5以上かを確認
chi                                   # Pearson(補正なし)
chisq.test(tab)                       # Pearson+Yates補正(Rの既定)
fisher.test(tab)                      # Fisher正確検定(両側)
出力(Rのセッションからのコピー):
            LowBW
Hypertension  No Yes
         No  125  52
         Yes   5   7

            LowBW
Hypertension    No   Yes
         No  0.706 0.294
         Yes 0.417 0.583

            LowBW
Hypertension     No   Yes
         No  121.75 55.25
         Yes   8.25  3.75

	Pearson's Chi-squared test
data:  tab
X-squared = 4.388, df = 1, p-value = 0.03619

	Pearson's Chi-squared test with Yates' continuity correction
data:  tab
X-squared = 3.1431, df = 1, p-value = 0.07625

	Fisher's Exact Test for Count Data
data:  tab
p-value = 0.05161
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
  0.8679484 13.9894703
sample estimates:
odds ratio
3.340866期待度数が5未満のセル(3.75)が1つあるため、chisq.test() の2回の呼び出しでは、どちらもRが警告 Chi-squared approximation may be incorrect を出しました。
同じセッションで計算した追加の値:φ係数(ファイ係数)= 0.152(φ = √(X²/N)、補正なしのPearson X²から。Kim 2017)[文献1]、「N−1」カイ二乗 = 4.365、P = 0.0367。標本オッズ比は (7 × 125)/(5 × 52) = 3.37 で、Rの条件付き推定値は3.34です。
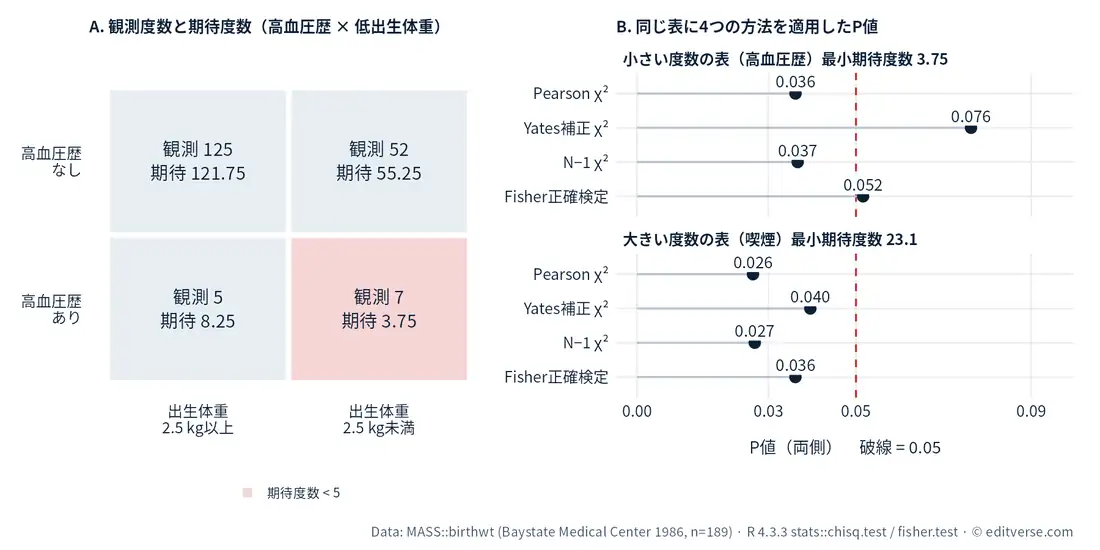
図の読み方:度数の小さい表では、4つの方法のP値は 0.036、0.076、0.037、0.052 となり、「有意かどうか」の判断が分かれます。度数の大きい表(妊娠中の喫煙、最小期待度数23.1)では、すべて0.05の同じ側に収まります。
結果の読み方
- 5の目安の確認は「不合格」。最小の期待度数は3.75なので、従来の目安に従えば、計画する解析はFisher正確検定で、P = 0.052 です。
- 食い違いは邪魔ものではなく、教訓そのもの。補正なしのPearsonではP = 0.036、YatesではP = 0.076、FisherではP = 0.052 です。P値が0.05を下回った検定を著者が選んでいたら、論文は「有意」と報告したでしょう。だからこそ、検定の選択は事前に決めておく必要があります。Neuhäuser と Ruxton(2025)も同じ主張をしています[文献5]。
- 閾値だけでなく区間を見る。オッズ比は3.34、95%信頼区間は0.87〜13.99です。曝露のあった女性が12人だけなので区間は広く、1を含んでいます。誠実なまとめは「関連の可能性はあるが、推定の精度は低い」であり、「関連なし」でも「証明された」でもありません。P値と区間の解釈はP値の正しい解釈と信頼区間の解釈をご覧ください。
- 丸めが問題を隠す。FisherのP = 0.0516は、小数第2位まで丸めると「0.05」になります。これは閾値ちょうどに見え、わずかに上回っていることが分かりません。SAMPLはP値を小数第1〜2位で示すことを提案しています(Lang と Altman, 2015)[文献7]。当社の編集上の助言は、P値が0.05に近いときは小数第3位まで書くことです。投稿先ジャーナルの規定がある場合は、それに従ってください。
比較のために、同じデータセットの「妊娠中の喫煙×低出生体重」の表(smoke 変数)を見ます。この表は度数が十分に大きく、期待度数はすべて23を超えます(最小23.1)。ここでは、Pearson P = 0.026、Yates P = 0.040、「N−1」P = 0.027、Fisher P = 0.036 でした(図1の右下)。度数が大きければ、検定の選択はほとんど問題になりません。
より大きな表(r×c)の場合
Fisher正確検定は2×2表に限りません。fisher.test() はr×c表も受け付け、厳密計算が重すぎる大きな表にはモンテカルロ・シミュレーションを使えます(Rヘルプ)。例として MASS::survey(学生237人、うち両変数が記録されているのは236人)で、喫煙習慣と運動頻度の4×3表を見ます。
s <- table(Smoke = MASS::survey$Smoke, Exer = MASS::survey$Exer)
s
round(suppressWarnings(chisq.test(s))$expected, 2)
chisq.test(s)                              # 警告:近似が不正確な可能性
fisher.test(s)                             # 厳密法(r×c表)
set.seed(2026)
fisher.test(s, simulate.p.value = TRUE, B = 1e5)$p.value
出力(要点を抜粋して掲載):
       Exer
Smoke   Freq None Some
  Heavy    7    1    3
  Never   87   18   84
  Occas   12    3    4
  Regul    9    1    7

Expected counts: smallest 1.07 (Heavy / None); 4 of 12 cells below 5 (33%)

Pearson's Chi-squared test: X-squared = 5.4885, df = 6, p-value = 0.4828
Fisher's Exact Test for Count Data: p-value = 0.4138
Monte Carlo Fisher (B = 1e5, seed 2026): p = 0.4156
12セルのうち4セル(33%)で期待度数が5未満であり、従来の目安の許容範囲(20%)を超えています[文献1]。そのため計画する解析は厳密検定で、P = 0.414 です。この例では、方法によって結論は変わりません(この236人では、喫煙習慣と運動頻度の関連を示す証拠はありませんでした)。厳密P値(0.414)とシミュレーションP値(0.416)はほぼ一致しています。ただしシミュレーションの値は、乱数のシードと B によってわずかに変わります。カテゴリが細かすぎて表がスパースになっている場合は、論理的に可能であればカテゴリを統合すると有効なことがあります[文献2]。Editverseの助言は、統合はP値を見てからではなく、事前に決めておくことです。
4. 論文での報告方法
報告ガイダンスが求めること
SAMPLガイドライン(Lang と Altman, 2015;EQUATOR Network)は、関連の検定を報告する著者に、使用した検定を明示すること、片側か両側かを書くこと(片側検定には理由を付ける)、P値を報告すること、主要な比較ではクロス集計表(度数の表)全体を示すことを検討すること、統計ソフトウェアのパッケージ名を書くことを求めています[文献7]。比較一般については、P値だけでなく、推定値とその信頼区間を示すよう求めています。
6つの主要医学雑誌でのFisher正確検定の使われ方を調べた監査(McKinneyら, 1989)では、選ばれた56本の論文のうち33本が片側・両側を明記しておらず、そのうち12本(36%)は実際には片側検定を用いていました。その12本のうち5本では、両側で解析し直すと、少なくとも1つの表でP < .05を満たさなくなりました。著者らは、これを明記しないと統計的有意性を誤って伝えるおそれがあると結論しています[文献6]。Rの fisher.test() は、alternative を変えなければ両側検定なので、Methodsには「two-sided」と書いてください。
Methodsの英文テンプレート
Associations between categorical variables were assessed with Pearson’s chi-square test, or with Fisher’s exact test (two-sided) when any expected cell count was below 5. No continuity correction was applied. Analyses were performed in R version 4.3.3 (
chisq.testandfisher.testfrom the stats package). A two-sided P value below 0.05 was considered statistically significant.
和訳:カテゴリ変数間の関連は、Pearsonのカイ二乗検定で評価し、期待度数が5未満のセルがある場合はFisher正確検定(両側)を用いた。連続性補正は行わなかった。解析にはRバージョン4.3.3(statsパッケージの chisq.test と fisher.test)を用いた。両側P値が0.05未満を統計的に有意とした。
これは、ご自身の事前規定の解析計画に合わせて調整してください。2×2表の比較すべてに厳密検定を事前に規定した場合(Neuhäuser と Ruxton, 2025)[文献5]は、その旨と使用した厳密検定の名称(Fisher正確検定、またはPearsonの統計量に基づく厳密検定など)を書きます。
Resultsの英文例(実データの数値入り)
A history of hypertension was recorded for 12 of 189 women. Low birth weight (< 2.5 kg) occurred in 7 of 12 women (58.3%) with a history of hypertension and in 52 of 177 women (29.4%) without it (Fisher’s exact test, two-sided P = 0.052; odds ratio 3.34, 95% CI 0.87 to 13.99). One expected cell count (3.75) was below 5.
和訳:高血圧歴は189人中12人で記録された。低出生体重(2.5 kg未満)は、高血圧歴のある12人中7人(58.3%)、ない177人中52人(29.4%)で認められた(Fisher正確検定、両側 P = 0.052、オッズ比3.34、95%信頼区間 0.87〜13.99)。期待度数が5未満のセルが1つ(3.75)あった。
この書き方がよい理由:両群の分子と分母を示し、検定名と片側・両側を明記し、正確なP値と、信頼区間つきの効果推定値を示しています。さらに、P > 0.05だからといって「関連なし」とは主張していません。実際の論文では、事前に規定した検定だけを本文に書きます。ほかの検定に触れるのは、査読者に求められた場合か、事前に計画した感度分析を行った場合に限ります。
表の書式
| Low birth weight, n (%) | No low birth weight, n (%) | Total | |
|---|---|---|---|
| Hypertension history: yes | 7 (58.3) | 5 (41.7) | 12 |
| Hypertension history: no | 52 (29.4) | 125 (70.6) | 177 |
表の脚注の例:「Fisher’s exact test, two-sided P = 0.052. Odds ratio 3.34 (95% CI 0.87 to 13.99), conditional maximum-likelihood estimate. Data: MASS::birthwt, R 4.3.3.」表のレイアウトについては、研究論文のテーブル(表)作成完全ガイドをご覧ください。
報告チェックリスト
- 割合だけでなく、すべてのセルの度数を示す(またはSupplementに表全体を載せる)。
- 検定名と、カイ二乗検定(連続性補正の有無)かFisher正確検定かを明記する。
- 両側か片側かを書く。片側検定には理由を付ける。
- 正確なP値を示す(SAMPL:小数第1〜2位。Editverseの編集上の助言:0.05に近いときは小数第3位まで。ジャーナルの規定がある場合はそれに従う)。
- 95%信頼区間つきの効果推定値(オッズ比、リスク差、リスク比)を示す。
- 期待度数が小さいことを理由にFisher検定を使った場合は、最小の期待度数と、適用したルールを書く。
- ソフトウェア名とバージョンを書く。
- この種の検定を多数行った場合は、多重比較への対処を書く(多重比較補正を参照)。
5. よくある誤り
- 割合(%)にカイ二乗検定をかける。この検定に必要なのは度数です。
- 対応のあるデータにPearsonの検定を使う。前後比較やマッチしたデータにはMcNemar検定を使います[文献2]。
- P値を見てから検定を選ぶ。第3節を参照してください。
- Fisher検定で片側・両側を書かない[文献6]。
- P > 0.05を「差がない」証明とみなす。信頼区間を確認してください。
- P値だけを報告する。効果推定値を添えてください。効果量の計算を参照。
- データを見てからカテゴリを統合し、表を「うまく」見せる。
査読者が指摘しやすいほかの統計上の問題は、統計エラー10選と査読で統計を指摘されたらで紹介しています。
6. Editverse Japanがお手伝いできること
検定の選択と記述を、投稿前に確認したい方へ
Editverse Japanの医学統計解析サポート(定額 79,800円)は、統計手法の選択、記述統計・推測統計の実施、MethodsとResultsの執筆支援までを、研究者の方と一緒に進めるサービスです。解析コードと結果レポートを納品し、R・SPSS・Stata・SASに、投稿先ジャーナルの要件に合わせて対応します。納期の目安は解析内容により5〜14営業日です。採択まで追加料金なしでサポートを継続します(採否はジャーナルの編集者・査読者が判断し、採択を保証するものではありません)。最終的な内容、結果の解釈、結論、投稿の判断は著者に帰属します(ICMJE・COPE準拠。統計支援は正当な貢献であり、研究デザイン・解釈・結論は研究者のものです)。
すでに査読者から検定について指摘を受けている場合(「Fisher正確検定を使うべき」「カイ二乗検定の前提が満たされていない」など)は、査読対応・統計再解析(定額 98,000円)をご覧ください。再解析、再現可能なRスクリプトと出力ログ、統計コメントへのポイントごとの回答まで対応します。
まとめ
- カイ二乗検定とFisher正確検定は、どちらも度数の表で独立性を検定します。カイ二乗検定は近似を使い、Fisher正確検定は厳密で、どの標本サイズでも有効です。
- 従来の目安:期待度数が5未満のセルが20%を超える場合、または1未満のセルがある場合は、Fisher検定を使います(2×2表では、4つの期待度数がすべて5以上)。Campbell(2007)とLydersenら(2009)は代替案を示し、Neuhäuser と Ruxton(2025)は厳密検定を事前に規定することを主張しています[文献1〜5]。
- 小さなセルが1つある189件の出生の実データでは、Pearson、Yates、FisherのP値は 0.036、0.076、0.052 でした。検定は事前に決め、オッズ比と信頼区間(3.34、95%信頼区間 0.87〜13.99)を報告します。
- 論文では、検定名、両側であること、度数、正確なP値、信頼区間つきの効果推定値、ソフトウェアを書きます。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- 【統計の書き方】論文における統計解析結果の報告方法
- 【信頼区間の解釈】95% CIの正しい意味と論文での報告方法
- 【多重比較補正】Bonferroni・Holm・FDRの選択と論文記述
- 査読で統計を指摘されたら|よくある7つの指摘と回答のしかた
- 相関係数とは|求め方・ピアソンとスピアマンの違いと論文での書き方
- リッカート尺度の分析|平均か中央値か・検定の選び方と書き方
- ROC曲線とAUCの見方|カットオフ値の決め方と論文の書き方
- 交絡因子とは|調整の方法と論文・査読での書き方【R実例つき】
- 有意差なしの結果の書き方
- 分散分析の論文での書き方|二元配置・反復測定・多重比較
- EZRでの二群比較と論文での書き方(EZR(Easy R)の使い方)
よくある質問
Q. カイ二乗検定とFisher正確検定は、どちらを使えばよいですか?
近似が成り立つほど度数が大きければカイ二乗検定を使います。従来は、2×2表で期待度数がすべて5以上であることが目安です。度数が小さい場合はFisher正確検定を使います。2×2の比較には常に厳密検定を事前に選ぶことを勧める統計家もいます(Neuhäuser と Ruxton, 2025)。どちらを選ぶにせよ、解析の前に決めて報告してください。
Q. 「期待度数5」は厳密な境界値ですか?
いいえ。Campbell(2007)は、Cochranによれば5という数字は恣意的に選ばれたものだと述べています。また彼のシミュレーションでは、最小期待度数1を基準に「N−1」カイ二乗検定を使う方針のほうが成績が良好でした。5は入門的な文献で教えられている慣行であり、法則ではありません。
Q. Fisher正確検定は、2×2より大きい表にも使えますか?
使えます。Rの fisher.test() はr×c表を受け付け、厳密計算が重すぎる場合のモンテカルロ・シミュレーションのオプションもあります。ただし、ソフトによっては2×2表でしかFisher検定を報告しません(Kim 2017は、例としてSPSSが既定では2×2表にのみ報告すると述べています)。
Q. イェーツの連続性補正は適用すべきですか?
Rは chisq.test() で2×2表に既定で適用します。補正により検定はより保守的になります(Hazra と Gogtay, 2016)。どうするにせよ、Methodsに適用したかどうかを書き、P値を見てからではなく事前に決めてください。
Q. Fisher正確検定は片側と両側のどちらにしますか?
プロトコルで片側検定の根拠が示されていない限り、両側検定を報告します。6つの医学雑誌の監査では、多くのFisher検定が片側・両側を明記せずに報告されており、両側で解析し直すと有意でなくなったものもありました(McKinneyら, 1989)。
参考資料
PubMed収載の文献(各文献は2026年10月6日にNCBI E-utilitiesのesummary/efetchで確認)
- Kim HY. Statistical notes for clinical researchers: Chi-squared test and Fisher’s exact test. Restor Dent Endod. 2017 May;42(2):152-155. doi: 10.5395/rde.2017.42.2.152. PMID: 28503482. PMCID: PMC5426219(全文を確認)。
- Hazra A, Gogtay N. Biostatistics Series Module 4: Comparing Groups – Categorical Variables. Indian J Dermatol. 2016 Jul-Aug;61(4):385-392. doi: 10.4103/0019-5154.185700. PMID: 27512183. PMCID: PMC4966396(全文を確認)。
- Campbell I. Chi-squared and Fisher-Irwin tests of two-by-two tables with small sample recommendations. Stat Med. 2007 Aug 30;26(19):3661-3675. doi: 10.1002/sim.2832. PMID: 17315184.(抄録を確認)
- Lydersen S, Fagerland MW, Laake P. Recommended tests for association in 2 x 2 tables. Stat Med. 2009 Mar 30;28(7):1159-1175. doi: 10.1002/sim.3531. PMID: 19170020.(抄録を確認)
- Neuhäuser M, Ruxton GD. The Choice Between Pearson’s χ² Test and Fisher’s Exact Test for 2 x 2 Tables. Pharm Stat. 2025 May-Jun;24(3):e70012. doi: 10.1002/pst.70012. PMID: 40156377.(抄録を確認)
- McKinney WP, Young MJ, Hartz A, Lee MB. The inexact use of Fisher’s Exact Test in six major medical journals. JAMA. 1989 Jun 16;261(23):3430-3433. PMID: 2724487.(抄録を確認。PubMedにDOIの記載なし)
- Lang TA, Altman DG. Basic statistical reporting for articles published in biomedical journals: the “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. Int J Nurs Stud. 2015 Jan;52(1):5-9. doi: 10.1016/j.ijnurstu.2014.09.006. PMID: 25441757.(SAMPLの本文はEQUATOR NetworkのPDFで確認)
ガイドライン・ソフトウェア・データ
- EQUATOR Network. SAMPL Guidelines (Lang & Altman):EQUATOR Network: SAMPL(PDF)
- R Core Team.
chisq.testとfisher.testのRヘルプ(statsパッケージ、R 4.3.3。本記事の作成に使ったRセッションでhelp()から確認) - MedCalc Software. Chi-squared test(「N−1」法)。Campbell 2007とRichardson 2011を引用しており、本記事では (N − 1)/N の係数の確認にのみ使用:MedCalc: Chi-squared test
- Venables WN, Ripley BD. Modern Applied Statistics with S, 4th ed. Springer; 2002(MASSパッケージの
birthwtとsurveyのドキュメント。birthwtの出典:Hosmer DW, Lemeshow S. Applied Logistic Regression. Wiley; 1989)