標準偏差と標準誤差の違い|論文の使い分けとエラーバー
標準偏差(SD)は、サンプルの個々の観測値がどれだけばらついているかを表します。標準誤差(SE)は、標本平均が母集団の平均をどれだけ精密に推定しているかを表し、SDをnの平方根で割った値です。観測値を増やしても、SDはほぼ同じ水準にとどまりますが、SEは小さくなり続けます。したがって、対象者や動物の特徴を記述するときはSD(歪んだデータでは中央値と四分位範囲)、推定値の精度を示すときは95%信頼区間(CI)を使い、図の凡例には誤差バーが何を表すか、そしてnがいくつかを必ず書きます。本記事では、Rの実データ2種類でSD・SE・95%CIを並べて示し、Methods・表・図の凡例にそのまま使える書き方を紹介します。
本記事が扱うのは、SDとSEの違いと誤差バー(エラーバー)の書き方だけです。信頼区間の意味や、オッズ比・ハザード比のCIの計算方法は【信頼区間の解釈】95% CIの正しい意味と論文での報告方法を、検定の選び方は統計検定の選び方を、P値はP値の正しい解釈をご覧ください。
1. SD・SE・95%CIの違いを1つの表で整理する
| 標準偏差(SD) | 標準誤差(SE、平均値の標準誤差) | 95%信頼区間(CI) | |
|---|---|---|---|
| 答える問い | 個々の観測値は、平均からどれだけ離れているか | 研究全体を繰り返したとき、標本平均はどれだけ変動するか | 母集団の平均として、どの値がもっともらしいか |
| 種類 | 記述統計 | 推測統計 | 推測統計 |
| 式 | SD = √( Σ(x − 平均)² / (n − 1) ) | SE = SD / √n | 平均 ± t(n−1) × SE |
| nが増えると | 系統的には変わらず、母集団のSDの近くに落ち着く | 1/√n に比例して小さくなる | 狭くなる。係数tも小さくなる(n = 5で2.78、n = 10で2.26、n = 189で1.97) |
| 使う場面 | サンプルの記述(Table 1の「平均値(SD)」) | CIを求める途中の値。単独の要約としては不向き | 平均値や群間差の精度を示す |
式と「記述統計・推測統計」の区別は、Cumming、Fidler、Vaux(2007)の表Iに沿っています。tの値はRの qt(0.975, n - 1) によるものです。報告ガイドラインのSAMPL(Lang と Altman, 2015)も同じ考え方で、データのばらつきを示すためにSEを使わず、SD・パーセンタイル範囲・範囲を使うこと、推定の精度を示すためにSEを使わず、95%CIを使うことを求めています。SAMPLは、SEは本質的に68%信頼区間にあたるとも述べています。この区別を扱った短い解説として、BMJのStatistics NoteであるAltman と Bland(2005)があります。
ここで押さえておきたい点が2つあります。
- SEは(n > 1のとき)常にSDより小さくなります。n = 10なら、SEはSDの0.316倍です。「平均値(SD)」の代わりに「平均値 ± SE」と書くと、サンプルが実際より均質に見えてしまいます。Nagele(2003)は、これが読者にサンプル内の個人差を過小評価させる点を問題としています。
- SEが小さいことは、平均が精密に推定されていることを意味します。観測値同士が近いことを意味するわけではありません。
2. nが増えると何が起こるか:Rの実データで確認
データ: MASS::birthwt は、1986年にマサチューセッツ州スプリングフィールドのBaystate Medical Centerで集められた189件の出生データで、bwt は出生体重(g)です(Rのヘルプページ。出典として挙げられているのはHosmer と Lemeshow, Applied Logistic Regression, 1989)。この189件を母集団のプールとみなし、5・10・20・40・80・189件の乱数サブサンプルを取りました。乱数の種は set.seed(2026) で、サブサンプルは入れ子(1回シャッフルした順序の先頭からn件)にしているため、大きいサンプルは小さいサンプルを含みます。
# R 4.3.3; MASS 7.3.60.0.1
se_summary <- function(x) {
  n  <- length(x); m <- mean(x); s <- sd(x)
  se <- s / sqrt(n)                       # SE = SD / sqrt(n)
  tc <- qt(0.975, df = n - 1)
  c(n = n, mean = m, SD = s, SE = se, t = tc,
    CI_low = m - tc * se, CI_high = m + tc * se)
}
x <- MASS::birthwt$bwt
set.seed(2026)
idx <- sample(length(x))                  # 1回シャッフルした順序(入れ子のサブサンプル)
res <- t(sapply(c(5, 10, 20, 40, 80, 189),
                function(n) se_summary(x[idx[1:n]])))
print(round(res, 2))
出力(Rセッションからそのまま転記):
       n    mean     SD     SE    t  CI_low CI_high
[1,]   5 3491.00 478.31 213.91 2.78 2897.10 4084.90
[2,]  10 3002.90 891.48 281.91 2.26 2365.17 3640.63
[3,]  20 3098.85 818.21 182.96 2.09 2715.91 3481.79
[4,]  40 3089.85 687.30 108.67 2.02 2870.04 3309.66
[5,]  80 2908.18 734.46  82.11 1.99 2744.73 3071.62
[6,] 189 2944.59 729.21  53.04 1.97 2839.95 3049.22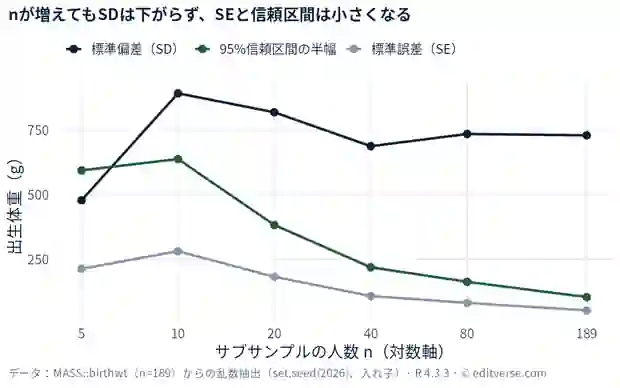
読み方:n = 10から189のあいだ、SDは687 gから891 gの範囲にとどまる一方、SEは281.9 gから53.0 gまで小さくなっています。
この結果の読み方
- SDは小さくなりません。n = 5で478 g、n = 10で891 g、その後は687〜734 gと上下しますが、下がり続ける傾向はありません。サンプルが小さいとばらつきの推定自体が不安定になるためです。全189件のSDは729.21 gです。
- SEは小さくなります。n = 10の281.91 gから、n = 189の53.04 gまで下がります。SE = SD / √n なので、nを4倍にするとおよそ半分になります。20件から80件にすると、182.96 gから82.11 gです。
- 1回の抽出はぶれるので、繰り返して確かめました。各nについて1,000回、乱数サブサンプルを取り(再び
set.seed(2026)、189件のプールから非復元抽出)、平均しました。SDの平均は、n = 5、10、20、40、80、189でそれぞれ695.0、708.1、722.8、724.6、728.2、729.2 gです。SEの平均は、同じ順に310.8、223.9、161.6、114.6、81.4、53.0 gです。SEが何を表すかを確かめるため、1,000個のサブサンプル平均そのもののSD(SEが推定している量)も求めると、n = 5、10、20、40、80で323.1、217.5、154.6、100.0、60.9 gでした。n = 80で平均SE(81.4 g)より小さいのは、わずか189件のプールから抽出していてサブサンプル同士が大きく重なるためです。これはこのデモの性質であり、大きな母集団から標本を取る実際の研究の性質ではありません。 - 観測値のおよそ3分の2は、平均から1 SD以内に入ります。全サンプルでは、189件中128件(67.7%)が1 SD以内、182件(96.3%)が2 SD以内でした。これがSDの記述的な意味です。Cummingら(2007)も同じ目安(約3分の2が1 SD以内、約95%が2 SD以内)を示しています。
- CIの半幅(図1の緑の線)は t × SE です。SEとtがともに小さくなるため、n = 10の637.7 gからn = 189の104.6 gまで下がります。
繰り返し抽出に使ったコードは次のとおりです。
set.seed(2026)
ns <- c(5, 10, 20, 40, 80, 189)
# 1,000回の乱数サブサンプル(非復元抽出)におけるSDの平均とSEの平均
sapply(ns, function(n) { r <- replicate(1000, { s <- sample(x, n); c(sd(s), sd(s)/sqrt(n)) }); rowMeans(r) })
set.seed(2026)
# 1,000個のサブサンプル平均そのもののばらつき(SEが推定している量)
sapply(ns[-6], function(n) sd(replicate(1000, mean(sample(x, n)))))
3. 目的別:SD・SE・95%CIのどれを使うか
以下は引用文献をもとにしたEditverseの整理であり、特定の文献の規則をそのまま写したものではありません。
| 目的 | 使うもの | 補足 |
|---|---|---|
| サンプルの記述(Table 1、Results本文) | おおむね左右対称なら平均値(SD)、歪んでいれば中央値(四分位範囲) | SAMPLは、おおむね正規分布するデータには平均値とSD、正規分布しないデータには中央値とパーセンタイル範囲や範囲を勧めています。また「mean ± SD」ではなく「mean (SD)」の形を勧めています。「±」の後ろが何かを示さないためです。ただ、ジャーナルによっては「±」を使うので、投稿先の規定に従い、何の数値かを必ず明記してください。平均と中央値の選び方はリッカート尺度の分析|平均か中央値か・検定の選び方と書き方をご覧ください |
| 平均値や差がどれだけ精密に推定されているかを示す | 95%CI | SAMPLはSEではなく95%CIを勧めています。Cummingら(2007)は、CIはnに関係なく同じ意味をもつため読者に分かりやすいと述べています |
| 図の誤差バー | どれかを明記し、nも書く | 同じ長さのバーでも、記述的(SD)にも推測的(SE、CI)にもなり得ます。見た目は同じなので、凡例で何かを示す必要があります(Cummingら, 2007, Rule 1) |
| nがきわめて小さい(3程度) | 個々のデータ点を描く | Cummingら(2007, Rule 4)は、nがきわめて小さいときは誤差バーや統計量の代わりに個々のデータ点を示すほうがよいとしています |
Cummingら(2007)は、実験生物学では群間比較が目的であることが多いため、そこではSEやCIの誤差バー(推測的なバー)が通常は適切だと述べています。また、CIはSEバーよりも解釈しやすいとも指摘しています。意味がnに左右されないためです。上記の文献のどこにも「SEバーは禁止」とは書かれていません。求められているのは、メッセージに合ったバーを選び、それが何かを明記することです。
実例:同じデータに3種類のバーを描く
データ: datasets::ToothGrowth は、モルモット60匹の歯の長さ(len、象牙芽細胞の長さ)のデータです。各個体はビタミンCを3段階の用量(0.5、1、2 mg/日)のいずれかで、オレンジジュース(OJ)またはアスコルビン酸(VC)として投与され、各群10匹です(Rのヘルプページ)。
| 群(n = 10) | 平均 | SD | SE | 95%CI |
|---|---|---|---|---|
| OJ 0.5 mg | 13.23 | 4.460 | 1.410 | 10.040〜16.420 |
| OJ 1 mg | 22.70 | 3.911 | 1.237 | 19.902〜25.498 |
| OJ 2 mg | 26.06 | 2.655 | 0.840 | 24.161〜27.959 |
| VC 0.5 mg | 7.98 | 2.747 | 0.869 | 6.015〜9.945 |
| VC 1 mg | 16.77 | 2.515 | 0.795 | 14.971〜18.569 |
| VC 2 mg | 26.14 | 4.798 | 1.517 | 22.708〜29.572 |
どの群もt = 2.262(自由度9)なので、CIの半幅は 2.262 × SE です。

読み方:3種類のバーは同じ平均値の上にありますが、SDバーは個体の広がりを示し、SEバーはその0.316倍の長さで、CIの半幅はSEの2.26倍(n = 10)です。
SDバーの重なりで差を判断してはいけない理由
0.5 mgでは、OJとVCの平均の差は5.25です(Welchのt検定:t = 3.17、自由度14.97、P = 0.006、差の95%CIは1.72〜8.78)。ところがSDバーは重なっています。OJは8.77〜17.69、VCは5.23〜10.73です。一方、2群の95%CI(10.040〜16.420と6.015〜9.945)は重なっていません。SDバーは個々の動物の広がりを表すので、SDバーが重なっていても、平均に差があるかどうかは何も言えません。2 mgでは差は−0.08(t = −0.05、P = 0.964)で、CIはほぼ完全に重なっています。
SEバーやCIバーの重なりに関する目安は存在しますが(Cummingら, 2007, Rules 5〜7)、nが小さい場合やSEとCIの違いで変わり、独立した群にしか使えません。心理学・行動神経科学・医学の研究者473人を対象とした調査(Beliaら, 2005)では、誤差バーと統計的有意性の関係について深刻な誤解が見られ、CIとSEバーの区別もできていませんでした。最も安全なのは、2群のバーの重なりを読者に推測させるのではなく、差の推定値とそのCIを直接報告することです(P値の正しい解釈も参照)。
4. 論文での書き方
Methodsの文例
Continuous variables are presented as mean (standard deviation, SD) when approximately normally distributed and as median (interquartile range) otherwise. Precision of estimates is expressed as 95% confidence intervals. Analyses were performed in R version 4.3.3.
Results本文の文例(birthwtの実数値)
Mean birth weight was 2944.59 g (SD 729.21 g, n = 189); the 95% confidence interval for the mean was 2839.95 to 3049.22 g.
ここでは、SDが赤ちゃん同士の出生体重の違いの大きさを示し、CIが平均の推定の精密さを示します。SE(53.04 g)は本文に書かなくても構いません。CIを求める途中の値だからです。
図の凡例の文例
Tooth length (mean and 95% confidence interval) by vitamin C dose and supplement type. Error bars show 95% confidence intervals; dots are individual animals. n = 10 guinea pigs per group.
誤差バーがSDなら「Error bars show the standard deviation.」、SEなら「Error bars show the standard error of the mean.」と書きます。「error bars」とだけ書いた凡例や「mean ± error」は不完全です(Cummingら, 2007, Rule 1)。凡例にはnが何かも書きます(Rule 2)。
nとは何を数えるか
Cummingら(2007, Rules 2・3)は、独立したサンプルと反復(レプリケート)を区別しています。3連のウェルを独立した4回の実験で繰り返したなら、nは3でも12でもなく4です。1つの試料の反復から計算した誤差バーは、ピペット操作や測定の再現性を表すだけで、効果が再現されるかどうかは示しません。「代表的な実験」を1つだけ示す場合はn = 1なので、誤差バーもP値も示すべきではありません。
チェックリスト
- サンプルの記述は、SEではなく平均値(SD)または中央値(四分位範囲)で行う。
- 推定値(平均、差、比)の精度は95%CIで示す。
- 図の凡例に、誤差バーが何か、nが何かを書く。
- nは反復測定ではなく、独立した単位の数で数える。
- nがきわめて小さいときは、個々のデータ点を示す。
- 「±」を使う場合は、後ろの量を明記する(「mean ± SD」)。
- ソフトウェアとそのバージョンを書く。
5. よくある間違い
- サンプルの記述にSEを使う。Nagele(2003)は、2001年の主要な麻酔科雑誌4誌を調べ、860本中198本(23%)が記述統計でSEMを不適切に使っていたと報告しています(雑誌ごとの範囲は11.5%〜27.7%)。査読でもよく指摘されます。査読で統計を指摘されたらと統計エラー10選もご覧ください。
- ラベルのない「平均値 ± 数値」。SDなのかSEなのか、読者には分かりません。
- 凡例がない、あるいはnがない誤差バー。
- SDバーの重なりを有意差の判断に使う。上の0.5 mgの例を参照してください。
- SEが小さいことを「データが揃っている」と読む。SEが反映しているのはnであり、観測値の広がりではありません。
- 反復をnとして数える(第4章を参照)。
- 歪んだデータを確認せずにSDで示す。歪んだデータでは中央値と四分位範囲を使います(【統計的仮定の確認】正規性・等分散性の検証と論文記述を参照)。
表のレイアウトは研究論文のテーブル(表)作成完全ガイドを、図のファイル形式と解像度は論文投稿用図のファイル形式と解像度をご覧ください。論文における統計解析結果の報告方法にあるSDとSEMについての1行の注意書きを、本記事で詳しく展開しました。
6. Editverse Japanがお手伝いできること
記述統計・信頼区間・図の凡例を、投稿前に第三者の目で確認したい方へ
Editverse Japanの医学統計解析サポート(定額 79,800円)は、記述統計・推測統計の実施と、MethodsとResultsの執筆支援までを、研究者の方と一緒に進めるサービスです。解析コードと結果レポートを納品し、R・SPSS・Stata・SASに、投稿先ジャーナルの要件に合わせて対応します。納期の目安は解析内容により5〜14営業日です。採択まで追加料金なしでサポートを継続します(採否はジャーナルの編集者・査読者が判断し、採択を保証するものではありません)。最終的な内容、結果の解釈、結論、投稿の判断は著者に帰属します(ICMJE・COPE準拠)。
図をジャーナルの規定に合わせて作り直したい場合は、論文図表作成(14,800円。棒グラフ・折れ線グラフ・散布図・箱ひげ図に対応。TIFF・EPS・PDF・PNGで納品。納期は図1点あたり3営業日)をご覧ください。
まとめ
- SDは個々の観測値のばらつきを表し、nが増えても小さくなりません。SE = SD / √n は平均の精度を表し、nが増えると小さくなります。
- 189件の出生体重の実データでは、SDは729.21 g、SEは53.04 gでした。n = 10から189のサブサンプルでは、SDは687 gから891 gの範囲にとどまり、SEは281.91 gから53.04 gまで小さくなりました。
- サンプルの記述には平均値(SD)または中央値(四分位範囲)、推定の精度には95%CIを使い、どちらにもSEは使いません(SAMPL)。
- 図では、凡例に誤差バーが何か、nが何かを書き、nは独立した単位で数えます。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- 【統計の書き方】論文における統計解析結果の報告方法
- 【信頼区間の解釈】95% CIの正しい意味と論文での報告方法
- P値の正しい解釈|統計的有意性の誤用を避けるガイド
- リッカート尺度の分析|平均か中央値か・検定の選び方と書き方
よくある質問
Q. 標準偏差と標準誤差の違いは何ですか?
SDは、個々の観測値がどれだけばらついているかを表します。SE(平均値の標準誤差)はSDをnの平方根で割った値で、標本平均が母集団の平均をどれだけ精密に推定しているかを表します。SDはnが増えても小さくなりませんが、SEは小さくなります。
Q. 論文にはSDとSEのどちらを書けばよいですか?
サンプルの記述にはSD(歪んだデータでは中央値と四分位範囲)を使い、推定値の精度には95%信頼区間を使います。SAMPLは、どちらの目的にもSEを使わないよう勧めています。ジャーナルによって規定が異なるので、投稿規定をご確認ください。
Q. 誤差バーは何を表せばよいですか?
伝えたい内容に合うものを選びます。データの広がりならSD、平均の精度なら95%CI(またはSE)です。凡例には何のバーか、そしてnを必ず書きます。
Q. 人数を増やすとSEが小さくなるのはなぜですか?
SE = SD / √n だからです。出生体重の例では、SDは687〜891 gの範囲にとどまる一方、SEはn = 10の281.91 gからn = 189の53.04 gまで小さくなりました。
Q. 「mean ± SD」と「mean (SD)」のどちらが正しいですか?
どちらも使われています。SAMPLは、「±」の後ろが何かを示さないため、「mean (SD)」の形を勧めています。「±」を使う場合は、MethodsまたはTableの注記で、それがSDであると明記してください。
参考資料
- Cumming G, Fidler F, Vaux DL. Error bars in experimental biology. J Cell Biol. 2007;177(1):7-11. doi:10.1083/jcb.200611141. PMID: 17420288.
- Altman DG, Bland JM. Standard deviations and standard errors. BMJ. 2005;331(7521):903. doi:10.1136/bmj.331.7521.903. PMID: 16223828.
- Nagele P. Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals. Br J Anaesth. 2003;90(4):514-516. doi:10.1093/bja/aeg087. PMID: 12644429.
- Belia S, Fidler F, Williams J, Cumming G. Researchers misunderstand confidence intervals and standard error bars. Psychol Methods. 2005;10(4):389-396. doi:10.1037/1082-989X.10.4.389. PMID: 16392994.
- Lang TA, Altman DG. Basic statistical reporting for articles published in biomedical journals: the “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. Int J Nurs Stud. 2015;52(1):5-9. doi:10.1016/j.ijnurstu.2014.09.006. PMID: 25441757.
- EQUATOR Network. SAMPL Guidelines (Lang & Altman).
- R Core Team. R documentation for
ToothGrowth(package datasets)andbirthwt(package MASS). R 4.3.3; MASS 7.3.60.0.1. ToothGrowthの出典:Bliss CI (1952), The Statistics of Bioassay. birthwtの出典:Hosmer DW, Lemeshow S (1989), Applied Logistic Regression, Wiley.