ロジスティック回帰分析のオッズ比|論文での書き方と報告例
ロジスティック回帰分析では、各回帰係数を指数変換(exp)した値がオッズ比です。説明変数が1単位増えたとき(またはある群が参照群と比べたとき)に、他の変数を固定した条件で、アウトカムが起こるオッズが何倍になるかを表します。論文では、オッズ比を95%信頼区間とともに示し、何で調整したかを明記します。アウトカムが珍しくない事象の場合は、オッズ比をリスク比(相対リスク)として読まないよう注意が必要です。本記事では、1つの実データ(R、MASS::birthwt、n = 189)を使い、モデルの出力から、論文のResultsに使える文章・表・図までを順に示します。
本記事が扱うのは、ロジスティック回帰モデルと、そのオッズ比・信頼区間の読み方と書き方です。効果量としてのオッズ比の一般論は効果量の計算、信頼区間全般の解釈は信頼区間の解釈、P値はP値の正しい解釈をご覧ください。ここでは繰り返しません。
1. ロジスティック回帰は何を推定するのか|オッズとは
確率とオッズは別のものです。確率はアウトカムが起こる人の割合、オッズはアウトカムが起こる確率を、起こらない確率で割った値です(Sperandei, 2014[文献7])。オッズ比は2つのオッズの比です。ロジスティック回帰は、オッズの対数を、説明変数の一次結合としてモデル化します。
log( p / (1 − p) ) = β0 + β1·x1 + β2·x2 + … + βm·xm
ここで p はイベントが起こる確率です(Sperandei, 2014[文献7])。同論文が述べる実務上のポイントは次の3つです。
- exp(βj) が変数 j のオッズ比です。連続変数では、その変数が1単位増えたときのオッズの変化を表します。k 水準のカテゴリ変数では、ソフトウェアが k − 1 個のダミー変数を作り、すべてのオッズ比は参照カテゴリとの比較になります。
- exp(β0)(切片)は、すべての変数が参照値にある群のオッズです。報告されることはほとんどありません。
- オッズと確率は異なります。そのため「大きなオッズ比」は「大きな確率」を意味しません。参照群の確率が小さければ、オッズ比が大きくても確率は小さいままのことがあります。
この後で使うbirthwtデータで、簡単に確認します。非喫煙者では115人中29人が低出生体重児を出産しており(オッズ 29/86 = 0.337)、喫煙者では74人中30人でした(オッズ 30/44 = 0.682)。オッズ比は 0.682 / 0.337 = 2.02 です。喫煙だけを説明変数にしたロジスティック回帰は、まさにこの値を返します(下のRの出力)。モデルを当てはめるたびに行える、よい動作確認です。
2. Rによる実例|妊娠中の喫煙と低出生体重
データ。MASS::birthwt は、1986年に米国マサチューセッツ州スプリングフィールドのBaystate Medical Centerで記録された、189件の出生のデータです(Rのヘルプに示された出典:Hosmer & Lemeshow, Applied Logistic Regression, Wiley, 1989)。アウトカム low は出生体重2.5 kg未満で、189件中59件(31.2%)です。関心のある曝露は妊娠中の喫煙の有無です。ほかに使う変数は、母親の年齢、最終月経時の母親の体重(ポンド)、人種(データ上は 1 = white、2 = black、3 = other)、高血圧の既往、子宮易刺激性です。1980年代の米国のデータですが、公開されていて実在し、教材として広く使われているために選びました。ここで示したいのは報告の方法であり、臨床的な結論ではありません。
教材としての注意。この共変量の組は、このデータで標準的に使われるものであり、あらかじめ定めたプロトコルではありません。実際の研究では、P値を見る前に交絡因子を決め、その理由を書きます(第4節を参照)。
Rコード(R 4.3.3。glm() はbase statsパッケージ。glmに対する confint() はプロファイル尤度による信頼限界を返し、MASS 7.3.60.0.1を読み込んだ状態で実行しました。confint.default() はWald信頼限界を返します):
library(MASS)
d <- birthwt
d$race    <- factor(d$race, levels = 1:3, labels = c("White", "Black", "Other"))
d$smoke_f <- factor(d$smoke, levels = 0:1, labels = c("Non-smoker", "Smoker"))
d$lwt10   <- d$lwt / 10      # per 10 lb
d$age5    <- d$age / 5       # per 5 years

# crude (unadjusted) model
m0 <- glm(low ~ smoke_f, data = d, family = binomial)
exp(cbind(OR = coef(m0), confint(m0)))          # profile-likelihood CI

# adjusted model
m1 <- glm(low ~ smoke_f + age5 + lwt10 + race + ht + ui,
          data = d, family = binomial)
summary(m1)
exp(cbind(OR = coef(m1), confint(m1)))          # profile-likelihood CI
exp(cbind(OR = coef(m1), confint.default(m1)))  # Wald CI
drop1(m1, test = "Chisq") # likelihood-ratio test per term実際の出力(抜粋)。粗モデル(喫煙のみ):
                 OR     2.5 %    97.5 %      (profile)
smoke_fSmoker 2.0219  1.0819    3.8006
                 OR     2.5 %    97.5 %      (Wald)
smoke_fSmoker 2.0219  1.0807    3.7831
調整モデルの summary(m1):
              Estimate Std. Error z value Pr(>|z|)
(Intercept)    0.43724    1.19193   0.367  0.71374
smoke_fSmoker  1.02757    0.39393   2.609  0.00909
age5          -0.09128    0.17677  -0.516  0.60559
lwt10         -0.16285    0.06859  -2.374  0.01758
raceBlack      1.28064    0.52669   2.431  0.01504
raceOther      0.90188    0.43436   2.076  0.03786
ht             1.85762    0.68885   2.697  0.00700
ui             0.89539    0.44849   1.996  0.04589

Null deviance: 234.67 on 188 df;  Residual deviance: 203.95 on 181 df;  AIC: 219.95
オッズ比(係数のexp)、プロファイル尤度による95%信頼区間、Waldによる95%信頼区間:
| 項目 | オッズ比 | 95%信頼区間(プロファイル) | 95%信頼区間(Wald) | Wald P値 | 尤度比検定のP値(drop1) |
|---|---|---|---|---|---|
| 喫煙(あり vs なし) | 2.79 | 1.31–6.19 | 1.29–6.05 | 0.009 | 0.008 |
| 年齢(5歳ごと) | 0.91 | 0.64–1.29 | 0.65–1.29 | 0.606 | 0.604 |
| 体重(10 lbごと) | 0.85 | 0.74–0.97 | 0.74–0.97 | 0.018 | 0.011 |
| 人種:Black vs White | 3.60 | 1.29–10.32 | 1.28–10.10 | 0.015 | 人種全体(2 df):0.020 |
| 人種:Other vs White | 2.46 | 1.07–5.91 | 1.05–5.77 | 0.038 | (同じ2 dfの検定) |
| 高血圧の既往(あり vs なし) | 6.41 | 1.72–27.01 | 1.66–24.72 | 0.007 | 0.006 |
| 子宮易刺激性(あり vs なし) | 2.45 | 1.01–5.94 | 1.02–5.90 | 0.046 | 0.047 |
モデルのN = 189(欠測なし)、イベント数59、説明変数の推定係数は7個です。
表が係数から導かれることの手計算による確認:喫煙では exp(1.02757) = 2.794、Wald限界は exp(1.02757 ± 1.96 × 0.39393) = 1.291 と 6.048 で、confint.default() の結果と一致します。
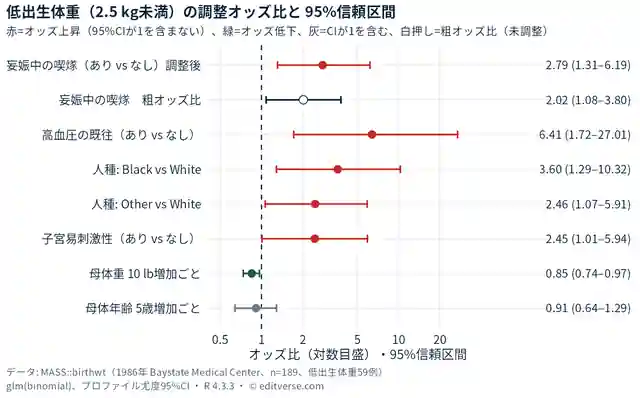
図の読み方:破線(オッズ比1)の右側にあり、区間が1に触れないものは、オッズが高い方向と両立します。高血圧の区間(1.72–27.01)は非常に広く、高血圧の女性が12人(イベント7件)しかいないと情報がいかに少ないかを示しています。点推定値は最大であるにもかかわらずです。
3. オッズ比と95%信頼区間の読み方
向きと大きさ。オッズ比 = 1 は2群のオッズが同じこと、1より大きければ参照群よりアウトカムのオッズが高いこと、1より小さければ低いことを意味します。この例では、年齢・体重・人種・高血圧の既往・子宮易刺激性を一定にしたこのモデルのもとで、喫煙者が低出生体重児を出産するオッズは、非喫煙者の2.79倍です。
95%信頼区間。信頼区間は、モデルのもとで、データと無理なく両立する効果の大きさの範囲です。Greenlandら(2016)[文献10]に基づく、厳密な点が2つあります。
- 「95%」は手続きの長期的な性質を指します。妥当な条件のもとで95%信頼区間を繰り返し計算すれば、平均して95%が真の効果を含みます。これは個々の区間の性質ではないため、「この区間が真のオッズ比を含む確率は95%」という言い方は、典型的な誤解です。
- 同じ論文は、P > 0.05 から「関連なし」と結論するのは、点推定値が帰無値とちょうど一致する場合を除き、誤りだと警告しています。信頼区間でも同様で、1を含む区間は「効果なし」を示したことになりません。区間を報告し、どの大きさが否定され、どの大きさが否定されないかを述べてください。
区間の幅の読み方。喫煙の信頼区間(1.31–6.19)は、オッズの小さな上昇から非常に大きな上昇までと両立します。データは示唆的ですが、精度は低いのです。そのように書いてください。精度は n だけでなく、イベント数に依存します。
単位のとり方。lwt の単位はポンドなので、1 lbあたりのオッズ比は1に近く、情報になりません。10 lbごと、5歳ごと、1標準偏差ごとのようにスケールを変えて、オッズ比が意味を持つ大きさにし、表に単位を明記します。コードのようにモデルに入れる前にデータを割り算しておくと、exp(10·β) とまったく同じ値になります。
Wald信頼区間とプロファイル尤度信頼区間。confint.default() はWald信頼区間 exp(β ± 1.96·SE) を返します。glmに対する confint() は尤度をプロファイルして求めるため、対数尺度では左右対称になりません。この例では、年齢・体重・子宮易刺激性の項で両者はほぼ同じですが、喫煙・人種・高血圧の項では、プロファイル尤度の区間のほうが上限が大きくなります。差がとくに目立つのは、データが疎な高血圧の項です(Wald 1.66–24.72、プロファイル 1.72–27.01)。HeinzeとSchemper(2002)[文献4]は、罰則付きロジスティック回帰の文脈で、罰則付きプロファイル尤度による区間と尤度比検定のほうがWaldよりも望ましいことが多いと述べています。どちらを使う場合も、Methodsに方法名を書いてください。
多水準のカテゴリ変数。2つの人種のオッズ比は、それぞれ参照カテゴリ(White)との比較です。「人種全体」のP値は2 dfの尤度比検定(ここではP = 0.020)であり、2つのWald P値のどちらでもありません。オッズ比はすべて、選んだ参照カテゴリに依存します。Sperandei(2014)[文献7]は、参照カテゴリを意図して選ぶことを勧め、参照カテゴリを変えると結果が変わると述べています。
4. 粗オッズ比と調整オッズ比|両方を報告する
STROBE声明の項目16(a)は、未調整の推定値と、該当する場合は交絡因子で調整した推定値を、精度(例:95%信頼区間)とともに示すこと、そしてどの交絡因子で調整したか、なぜそうしたかを明らかにすることを求めています(Vandenbroucke, 2007[文献8];von Elm, 2007[文献9])。STROBEの解説(E&E)は、さらに次の点を挙げています。読者は未調整の値と調整後の値を比べて、どれだけ変わったかを判断できること。調整後の解析に含まれた人数を示すこと(共変量の欠測で人数が変わりうるため)。「調整済み」の結果にも、残余交絡や選択バイアスがないとは限らないこと。
この例では次のようになります。
| 項目 | イベント数/群の人数 | 粗オッズ比(95%信頼区間、プロファイル) | 調整オッズ比(95%信頼区間、プロファイル) |
|---|---|---|---|
| 喫煙:非喫煙(参照) | 29/115 | 1 | 1 |
| 喫煙:喫煙 | 30/74 | 2.02(1.08–3.80) | 2.79(1.31–6.19) |
| 人種:White(参照) | 23/96 | 1 | 1 |
| 人種:Black | 11/26 | 2.33(0.93–5.77) | 3.60(1.29–10.32) |
| 人種:Other | 25/67 | 1.89(0.96–3.76) | 2.46(1.07–5.91) |
| 高血圧の既往:あり | 7/12 | 3.37(1.03–11.83) | 6.41(1.72–27.01) |
| 子宮易刺激性:あり | 14/28 | 2.58(1.13–5.88) | 2.45(1.01–5.94) |
| 体重(10 lbごと) | – | 0.87(0.76–0.97) | 0.85(0.74–0.97) |
| 年齢(5歳ごと) | – | 0.77(0.56–1.05) | 0.91(0.64–1.29) |
Resultsで1文ずつ触れる価値のある点が2つあります。喫煙では、調整によってオッズ比が1から遠ざかりました(2.02から2.79)。人種のBlack vs Whiteでは、粗オッズ比の信頼区間は1を含みますが(0.93–5.77)、調整後は含みません(1.29–10.32)。調整は推定値をどちらの方向にも動かしうるので、小さくなるとは限りません。
調整オッズ比は、調整に用いる変数の組に依存します。同じデータで、人種だけで調整すると喫煙のオッズ比は3.05(95%信頼区間 1.50–6.44)、これに年齢、体重、早産歴、高血圧の既往、子宮易刺激性を加えると2.33(1.06–5.29)、本記事で使った組(早産歴の変数なし)では2.79(1.31–6.19)です。3つとも、R 4.3.3で計算したプロファイル尤度による信頼区間です。STROBEが調整に用いた変数の組とその理由を書くよう求めるのは、このためです。共変量のリストが違えば、数値が正当に違ってくることがあります。
交絡因子の選び方。STROBEは、どの変数を含めるかは、因果関係についての知識や明示的な仮定に基づいて決めること、そして因果経路上にある変数で調整するとバイアスが生じうることを述べています(Vandenbroucke, 2007[文献8])。ステップワイズ法や変化率に基づく方法を使った場合は、その方法を説明してください。標本サイズが限られるときに、緩めたP値(例:0.25)で単変量の事前選択を行う方法は、Sperandei(2014)[文献7]が簡便な方法として紹介しています。ただし、これはデータに基づく近道であり、交絡の調整が目的であれば、引用するならSTROBEの立場のほうが安全です。
5. オッズ比はリスク比ではない|一般的なアウトカムでは絶対リスクも示す
アウトカムが稀なときは、オッズ比はリスク比の近似になります。アウトカムが一般的な(研究集団でおよそ10%を超える)ときは、調整オッズ比はリスク比の近似にならず、1を超える場合には過大評価します(Zhang & Yu, 1998[文献5])。Daviesら(1998)[文献6]は、読者向けに同じ点を述べています。どちらかの群のリスクがおよそ20%を超えると、オッズ比と相対リスクの差が開きます。この例では、出生の31%が低出生体重児で、非喫煙者のリスクは25%なので、オッズ比は対応するリスク比より大きく見えます。
同じオッズ比が、2つの基準リスクのもとでリスクにどう対応するかを、算術だけで示します(R。リスク = オッズ/(1+オッズ)、曝露群のオッズ = 基準群のオッズ × オッズ比)。
| 基準リスク(参照群) | オッズ比 | 曝露群の推定リスク | 推定リスク比 |
|---|---|---|---|
| 5% | 2.79 | 12.8% | 2.56 |
| 5% | 5.00 | 20.8% | 4.17 |
| 25.2%(非喫煙者での観測値) | 2.79 | 48.5% | 1.92 |
| 25.2%(非喫煙者での観測値) | 5.00 | 62.8% | 2.49 |
STROBEの項目16(c)は、該当する場合、相対リスクの推定値を、意味のある期間についての絶対リスクに置き換えることを検討するよう述べています(Vandenbroucke, 2007[文献8])。ロジスティックモデルの後でこれを行う方法の1つが、標準化です。全員を非喫煙者に設定した場合と全員を喫煙者に設定した場合(他の共変量は観測どおり)の、各女性のリスクを2回予測して平均します。R 4.3.3で、ノンパラメトリックなブートストラップ(2,000回の再標本化、シード 20261006、パーセンタイル法の95%区間)を用いた結果は次のとおりです。
Adjusted average risk, non-smokers  0.238 (95% CI 0.166 to 0.320)
Adjusted average risk, smokers      0.431 (95% CI 0.311 to 0.545)
Risk difference                      0.192 (95% CI 0.048 to 0.327)
Risk ratio                           1.81 (95% CI 1.16 to 2.77)
Crude risks 25.2% vs 40.5%; crude RR 1.61; crude RD 0.153
(Risk difference is computed from unrounded risks: 0.4307 - 0.2382 = 0.1925, hence 0.192.)
このデータでは、調整オッズ比2.79を与えるのと同じ当てはめ済みモデルから、標準化したリスク比1.81と、約19パーセントポイントのリスク差が得られます(共変量で調整したモデルのオッズ比と標準化したリスク比は別の量なので、一致するとは限りません)。オッズ比と、これらの絶対的な数値の両方を報告すれば、読者や査読者が2.79を「リスクが2.79倍」と読むことを防げます。この標準化の手順は本記事独自の例示です。STROBEが求めているのは絶対リスクを検討することだけであり、この方法を使う場合は、方法名と前提を明記してください。
6. 査読者が確認する点|変数あたりのイベント数・スパースデータ・検証
変数あたりのイベント数(EPV:events per variable)。Peduzziら(1996)[文献1]は、心臓の臨床試験に基づくシミュレーションで、EPVが10以上であれば大きな問題は見られず、10未満では係数が両方向にバイアスを受け、分散の推定値と90%信頼区間の被覆率が不安定になり、逆説的な関連が増えることを示しました。その後、VittinghoffとMcCulloch(2007)[文献2]は、EPVが10未満でも被覆率とバイアスが許容できる状況が幅広くあり、ほかの要因が同程度かそれ以上に重要になりうることを見いだし、とくに交絡が十分にコントロールされていることを示す感度分析では、この基準を緩めてよいと結論づけました。査読者がEPVを指摘したときのために、両方を参考文献に入れておいてください。この例のモデルは、イベント59件、説明変数の係数7個なので、係数で数えるとEPV = 59/7 = 8.4です(人種はダミー変数を2つ使います。変数で数えると6個なので59/6 = 9.8)。どちらで数えても従来の目安の10を下回るため、限界として明記すべき点です。どちらの数え方を使ったかも書いてください。実際の投稿では、まさに統計の専門家が対処する点で、共変量を減らすか、VittinghoffとMcCullochの趣旨に沿って根拠を示すことになります。
あわせて読みたい:説明変数の選び方とステップワイズの問題(Rの実例)
分離(separation)。ある説明変数がアウトカムをほぼ完全に分けてしまう場合(偏りが大きく予測力の高い因子がある小標本で起こりがちです)、最尤推定値は正または負の無限大に発散することがあります。HeinzeとSchemper(2002)[文献4]は、Firthの罰則付き尤度が、有限の推定値を与える解決法になると述べています。兆候は、極端に大きなオッズ比と標準誤差、または Rの警告 glm.fit: fitted probabilities numerically 0 or 1 occurred や algorithm did not converge です(これはソフトウェアの挙動であり、完全に分離したシミュレーションデータで確認しました。論文から引いたものではありません)。
医学文献での報告の水準。Bagleyら(2001)[文献3]は、ある医学領域でロジスティック回帰を用いた15本の論文を調べ、使い方と報告に大きな不備があることを見いだしました。多くの研究でEPVが小さく、検証解析、回帰診断、適合度の指標を報告した研究は1つもありませんでした。モデルをどう確認したか(診断、適合度、必要に応じて検証)をMethodsに一文書いておけば、この指摘を先回りして防げます。
目的が調整後の関連ではなく予測である場合。報告ガイドラインはSTROBEだけでなくTRIPODです(EQUATOR NetworkのTRIPODのページを参照)。このとき、変数ごとのオッズ比の表は二の次で、較正と識別能が中心になります。
7. 論文での書き方|Methods・Results・表・図の凡例
以下のMethods・Results・図の凡例の文例は、英語の原稿にそのまま使えるよう、英文のまま示します。[ ]内は研究ごとに記入してください。
Methodsの文例(テンプレート)
"The association between smoking during pregnancy and low birth weight (<2,500 g) was estimated with multivariable logistic regression. Results are reported as odds ratios (OR) with 95% confidence intervals (CI) calculated by the profile-likelihood method. The model was adjusted for maternal age, maternal weight at the last menstrual period, race, history of hypertension and uterine irritability [state how these were chosen]. Overall p-values for multi-level variables were obtained from likelihood-ratio tests. Adjusted (standardized) risks were obtained by predicting the risk of each woman with smoking set to yes and to no, with the other covariates as observed, and averaging; 95% CIs for risks, risk differences and risk ratios were obtained by nonparametric bootstrap (2,000 resamples, percentile method). Analyses used R version 4.3.3 (glm, family = binomial)."
Resultsの文例(上の数値を使用)
"Of 189 births, 59 (31.2%) were low birth weight: 30 of 74 (40.5%) among women who smoked and 29 of 115 (25.2%) among those who did not. Smoking during pregnancy was associated with higher odds of low birth weight (crude OR 2.02, 95% CI 1.08 to 3.80; adjusted OR 2.79, 95% CI 1.31 to 6.19; adjusted for age, weight, race, hypertension and uterine irritability; n = 189, 59 events). The standardized adjusted risk of low birth weight was 43.1% if all women smoked versus 23.8% if none did (risk difference 19.2 percentage points, 95% CI 4.8 to 32.7, computed from unrounded risks)."
この書き方がよい理由は、度数を示し(STROBEの項目15・16)、粗・調整の両方の推定値を区間つきで示し(16a)、調整に用いた変数の組を明記し、n とイベント数を述べ、絶対リスクに置き換えている(16c)からです。「有意」とだけ書いたり、研究デザインが裏づけない因果的な表現を使ったりすることもありません。
論文形式の表(粗オッズ比と調整オッズ比)
表は、1変数を1行にし、列は「イベント数/N」「粗オッズ比(95%信頼区間)」「調整オッズ比(95%信頼区間)」とします。すべての変数に参照カテゴリと単位を示し、調整に用いた変数と信頼区間の方法は脚注に書きます。以下は、本記事の数値で作った、原稿にそのまま使える形の例です(レイアウトは研究論文のテーブル作成ガイドと図の凡例と表の脚注を参照)。
Table 1. Crude and adjusted odds ratios for low birth weight (<2,500 g) (n = 189; 59 events)
| Variable | Events/N | Crude OR (95% CI) | Adjusted OR (95% CI) |
|---|---|---|---|
| Smoking during pregnancy: no | 29/115 | 1 (reference) | 1 (reference) |
| Smoking during pregnancy: yes | 30/74 | 2.02 (1.08 to 3.80) | 2.79 (1.31 to 6.19) |
| Race: White | 23/96 | 1 (reference) | 1 (reference) |
| Race: Black | 11/26 | 2.33 (0.93 to 5.77) | 3.60 (1.29 to 10.32) |
| Race: Other | 25/67 | 1.89 (0.96 to 3.76) | 2.46 (1.07 to 5.91) |
| History of hypertension: yes (reference: no) | 7/12 | 3.37 (1.03 to 11.83) | 6.41 (1.72 to 27.01) |
| Uterine irritability: yes (reference: no) | 14/28 | 2.58 (1.13 to 5.88) | 2.45 (1.01 to 5.94) |
| Maternal weight, per 10 lb | – | 0.87 (0.76 to 0.97) | 0.85 (0.74 to 0.97) |
| Maternal age, per 5 years | – | 0.77 (0.56 to 1.05) | 0.91 (0.64 to 1.29) |
OR, odds ratio; CI, confidence interval (profile likelihood). Adjusted ORs are from one multivariable logistic regression containing all variables listed (age, weight, race, history of hypertension, uterine irritability and smoking). Events/N is the number of low-birth-weight births over the number of births in each group. Data: MASS::birthwt (Baystate Medical Center, 1986); analysed in R 4.3.3.
図の凡例の文例
"Figure 1. Adjusted odds ratios (dots) and profile-likelihood 95% confidence intervals (bars) for low birth weight from a multivariable logistic regression (n = 189; 59 events). The hollow marker is the unadjusted odds ratio for smoking. The dashed line marks OR = 1; the horizontal axis is on a log scale."
避けたい典型的な誤り
- 回帰係数 β(対数オッズ)をオッズ比のように報告する。必ずexpで変換し、どちらを示すかを明記します。
- アウトカムが一般的なのに、オッズ比を「リスクが○倍」と解釈する(第5節)。
- 1ポンドあたり・1単位あたりのオッズ比が「1.00(0.99–1.01)」のようになる。スケールを変えます。
- P値だけを示す。STROBEの解説は、曝露とアウトカムに有意な関連があるかないかを述べるだけでは不十分だとしています。区間つきの推定値を示します。
- 参照カテゴリ、単位、解析対象のN、イベント数を省く。
- 調整変数をP値で選んだのに、そのことを書かない(STROBE 16a)。
統計結果の報告ルール全般は【統計の書き方】論文における統計解析結果の報告方法、査読者からの統計コメントは査読で統計を指摘されたら、よくある誤りは統計エラー10選をご覧ください。
Editverse Japanがお手伝いできること
ロジスティック回帰の解析と記述を、査読者に指摘される前に確認したい方へ
データと研究デザインをお持ちください。Editverse Japanの医学統計解析サポートは、研究デザインに合った解析方法を研究者の方と一緒に検討し(ロジスティック回帰・Cox回帰は商品ページに記載があります)、R・Stata・SPSS・SASで解析を実施し、サンプルサイズ計算にも対応します。解析コードと結果レポートを納品し、MethodsとResultsの執筆を支援します。研究デザイン、結果の解釈、結論は、引き続き研究者の方のものです(統計支援と言語支援は、ICMJEの著者資格の考え方のもとで正当な支援です)。1原稿につき、採択まで追加料金なしでサポートを継続します。採否はジャーナルの編集者・査読者が判断するもので、採択を保証するものではありません。
すでに査読者から統計について指摘を受けている場合は、査読対応・統計再解析をご覧ください。再解析、解析コード、回答文の作成まで対応します。
まとめ
glm(family = binomial)の係数のexp(β) がオッズ比です。95%信頼区間、参照カテゴリ、単位、N/イベント数とともに報告します。- 粗オッズ比と調整オッズ比の両方を報告し、調整に用いた変数の組と、その選び方を書きます(STROBE 16a)。
- 95%信頼区間が表すのは、手続きの長期的な被覆率であり、個々の区間が真の値を含む95%の確率ではありません(Greenland, 2016)。
- アウトカムが一般的な場合は、絶対リスクを添えます。オッズ比はリスク比ではありません(STROBE 16c;Zhang & Yu, 1998)。
- EPVとモデルの確認方法を書きます。どちらも査読者から指摘されうる点です(Peduzzi, 1996;Vittinghoff, 2007;Bagley, 2001)。
- 実例(n = 189、イベント59件)では、喫煙の調整オッズ比は2.79(95%信頼区間 1.31–6.19)、標準化したリスク差は19.2パーセントポイント(4.8–32.7)でした。これは1986年の米国データを用いた教材の例であり、臨床的な知見ではありません。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 【信頼区間の解釈】95% CIの正しい意味と論文での報告方法
- 【完全ガイド】STROBE声明で観察研究を正しく報告する方法
- 査読で統計を指摘されたら|よくある7つの指摘と回答のしかた
- 回帰分析の種類と選び方
- 交絡因子の調整方法
- ROC曲線とAUCの報告
- 医学統計解析の外注|依頼前の準備と納品物・著者資格
- 傾向スコアでマッチングしたあとの結果の報告
よくある質問
Q. ロジスティック回帰でオッズ比2.79はどう解釈しますか?
曝露群のアウトカムのオッズが、参照群のオッズの2.79倍であることを意味します(モデル内の他の変数は一定とした場合)。リスクが2.79倍高いという意味ではありません。アウトカムが一般的な場合、リスク比はそれより小さくなります(この例では、標準化したリスク比は1.81です)。
Q. オッズ比の95%信頼区間が1を含むとは、どういうことですか?
データは、オッズに差がない場合とも、どちらの方向の効果とも両立するという意味です。区間を報告し、どの大きさが否定されるかを述べてください。「関連なし」と書いてはいけません。95%とは、妥当な研究を繰り返したとき、この方法で計算した区間が真の値を含む頻度のことです(Greenlandら, 2016)。
Q. 粗オッズ比と調整オッズ比の違いは何ですか? どちらを報告しますか?
粗オッズ比は曝露だけから求めた値、調整オッズ比は交絡因子も入れたモデルから求めた値です。STROBEの項目16(a)は、交絡因子とその採用理由を示したうえで、両方を示すことを求めています。この例では、喫煙のオッズ比は調整により2.02から2.79に動きました。
Q. ロジスティック回帰にはイベントがいくつ必要ですか?
従来の目安は、説明変数1個あたりイベント10件以上です(Peduzziら, 1996)。ただし、その後のシミュレーションで、状況によっては緩めてよいことが示されています(VittinghoffとMcCulloch, 2007)。自分のEPVを報告し、その根拠を示してください。この例は8.4(係数7個で数えた場合)で、限界として明記しています。
Q. Wald信頼区間とプロファイル尤度信頼区間は、どちらを使いますか?
どちらも95%信頼区間の妥当な計算方法です。データが十分にあれば近い値になり、データが疎だと差が出ます。HeinzeとSchemper(2002)は、罰則付きロジスティック回帰では、プロファイル尤度による区間と尤度比検定のほうが望ましいことが多いと述べています。選んだ方法はMethodsに書いてください。
参考資料
PubMed収載の文献(題名・著者・雑誌・年・巻・ページ・DOIは、2026年10月6日にNCBI E-utilitiesのesummaryで確認。本文で用いた主張ごとに、抄録または全文を確認)
- Peduzzi P, Concato J, Kemper E, Holford TR, Feinstein AR. A simulation study of the number of events per variable in logistic regression analysis. J Clin Epidemiol. 1996 Dec;49(12):1373-9. doi: 10.1016/s0895-4356(96)00236-3. PMID: 8970487.
- Vittinghoff E, McCulloch CE. Relaxing the rule of ten events per variable in logistic and Cox regression. Am J Epidemiol. 2007 Mar 15;165(6):710-8. doi: 10.1093/aje/kwk052. PMID: 17182981.
- Bagley SC, White H, Golomb BA. Logistic regression in the medical literature: standards for use and reporting, with particular attention to one medical domain. J Clin Epidemiol. 2001 Oct;54(10):979-85. doi: 10.1016/s0895-4356(01)00372-9. PMID: 11576808.
- Heinze G, Schemper M. A solution to the problem of separation in logistic regression. Stat Med. 2002 Aug 30;21(16):2409-19. doi: 10.1002/sim.1047. PMID: 12210625.
- Zhang J, Yu KF. What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA. 1998 Nov 18;280(19):1690-1. doi: 10.1001/jama.280.19.1690. PMID: 9832001.
- Davies HT, Crombie IK, Tavakoli M. When can odds ratios mislead? BMJ. 1998 Mar 28;316(7136):989-91. doi: 10.1136/bmj.316.7136.989. PMID: 9550961.(無料の全文:PMC1112884。「20%を超える」という記述は、このPMCのページで確認)
- Sperandei S. Understanding logistic regression analysis. Biochem Med (Zagreb). 2014;24(1):12-8. doi: 10.11613/BM.2014.003. PMID: 24627710.(全文:PMC3936971)
- Vandenbroucke JP, von Elm E, Altman DG, Gotzsche PC, Mulrow CD, Pocock SJ, Poole C, Schlesselman JJ, Egger M; STROBE Initiative. Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): explanation and elaboration. PLoS Med. 2007 Oct 16;4(10):e297. doi: 10.1371/journal.pmed.0040297. PMID: 17941715.(全文:PMC2020496。項目16(a)、16(c)と交絡因子の選択に関する記述を確認)
- von Elm E, Altman DG, Egger M, Pocock SJ, Gotzsche PC, Vandenbroucke JP; STROBE Initiative. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Ann Intern Med. 2007 Oct 16;147(8):573-7. doi: 10.7326/0003-4819-147-8-200710160-00010. PMID: 17938396.
- Greenland S, Senn SJ, Rothman KJ, Carlin JB, Poole C, Goodman SN, Altman DG. Statistical tests, P values, confidence intervals, and power: a guide to misinterpretations. Eur J Epidemiol. 2016 Apr;31(4):337-50. doi: 10.1007/s10654-016-0149-3. PMID: 27209009.(全文:PMC4877414)
ガイドライン・ソフトウェア・データ
- EQUATOR Network. STROBE reporting guideline(コホート研究・症例対照研究・横断研究のチェックリスト):EQUATOR Network: STROBE
- EQUATOR Network. TRIPOD statement(予測モデルの開発・評価研究の報告):EQUATOR Network: TRIPOD
- R documentation,
MASS::birthwt(Venables & Ripley。出典:Hosmer & Lemeshow, 1989)。R 4.3.3、MASS 7.3.60.0.1 - データとコードは、2026年10月6日にR 4.3.3(stats::glm、MASSのプロファイル尤度による confint、ggplot2 4.0.3、ragg 1.5.2)で計算