論文Methodsの書き方|再現できる記載項目・順序・例文
論文の方法(Methods)の役割は、読者が「どのように、なぜその方法で研究が行われたか」を理解し、結果を判断・検証できるようにすることです。ICMJE勧告は、データにアクセスできる他者が結果を再現できる程度に詳しく書くことを求めています。具体的には、研究デザイン、場所と期間、対象者とその選び方、定義した変数、データの出所と測定、統計解析、倫理審査、ソフトウェアとそのバージョンを書きます。本記事では、記載項目のチェックリストと見出しの順序を示し、Rの実データで統計解析の段落に何を書くかを確認し、2024年に公表されたR利用論文でRのバージョンがどれだけ書かれているかを実際に数えました(294件中、Rのリリース番号が明確に書かれていたのは79.6%で、約5分の1は書かれていませんでした)。
本記事が扱うのは、Methodsセクションの言語・構造・書式です。研究デザイン、解析方法の選択、結果の解釈は研究者ご自身の判断です。IMRaD全体を書く順番は論文の書き方|IMRaD構成と「書く順番」をご覧ください。
1. Methodsセクションが果たす役割
多くの生物医学系ジャーナルが従う基準は、次の2つです。
- ICMJE勧告(2026-10-07に確認):Methodsの指導原則は「clarity about how and why a study was done in a particular way」(なぜ、どのように研究したかの明確さ)です。含めるのは計画やプロトコルの作成時点で分かっていた情報だけで、「all information obtained during the study belongs in the Results section」(研究中に得られた情報はResultsに属する)とされています。また、独立した地域・国の審査機関が研究を承認したことの記載が必要です。統計については、専門知識のある読者が元データを使って手法の適切性を判断し、結果を検証できる程度に詳しく書き、「Specify the statistical software package(s) and versions used」(統計ソフトウェアとバージョンを明記)、「Distinguish prespecified from exploratory analyses」(事前規定の解析と探索的解析を区別)することを求めています。
- EQUATOR Networkの執筆支援ページ(2026-10-07に確認):別の研究者が実験を再現できるか、査読者がバイアスのリスクを評価できるか、という問いで確認するよう促しています。
「再現できる」とは、すべての読者が実験を繰り返すという意味ではありません。何が行われたかを正確に理解でき、繰り返すことも監査することもできる、という意味です。このため、Methodsには「計画」を書き、研究の結果として出てきた数字(適格だった人数、除外した人数など)はResultsに置きます。この点は第4節で再び扱います。
2. 何を、どの順序で書くか
すべてのジャーナルに共通する見出しの型はなく、まず投稿規程に従います(論文投稿規程の読み方)。ジャーナルが型を指定していない場合は、STROBEチェックリスト(横断研究版)のMethods項目(項目4〜12)の順序が、無理のない標準になります(EQUATOR NetworkのチェックリストPDFを2026-10-07に確認)。下の表はその順序に、STROBEのMethods項目には含まれないがICMJEが求める2行(倫理、ソフトウェア)を加えたものです。
| 順序 | 見出しの例 | 書く内容 | STROBE項目 |
|---|---|---|---|
| 1 | Study design | 研究デザインを、一般的な用語で、セクションの早い位置に書く | 4 |
| 2 | Setting | 場所、施設、関連する日付(登録・曝露・追跡・データ収集の期間) | 5 |
| 3 | Participants | 適格基準、対象者の選択元と選択方法 | 6 |
| 4 | Variables | すべてのアウトカム、曝露、予測因子、交絡因子の候補、効果修飾因子を定義する。該当する場合は診断基準 | 7 |
| 5 | Data sources / measurement | 変数ごとのデータの出所と測定方法。ICMJEは機器(製造元)と手順を「in sufficient detail to allow others to reproduce the results」書くよう求める | 8 |
| 6 | Bias | バイアスの原因に対処するために行った工夫 | 9 |
| 7 | Study size | 症例数・標本サイズをどう決めたか | 10 |
| 8 | Quantitative variables | 連続変数の扱い。分類したときはその区分と理由 | 11 |
| 9 | Statistical analysis | 交絡の調整、サブグループと交互作用、欠測データ、標本抽出設計への対応、感度分析を含む全手法 | 12 |
| 10 | Ethics | 審査機関、承認、同意(ICMJEはMethodsに書くとしている。独立した宣言欄を設けるジャーナルもある) | (STROBEのMethods項目ではない) |
| 11 | Software | 名称、バージョン、主要なパッケージ(ICMJE) | (STROBEの項目ではない) |
補足です。STROBE自身が、チェックリストは研究の質を評価する道具ではなく、勧告は研究の設計や実施の処方箋ではない、と述べています(EQUATOR NetworkのSTROBEページ)。順序は報告のための目安として使ってください。ランダム化比較試験にはCONSORT 2025(2025年公表[文献4]。EQUATORのページを2026-10-07に確認)、システマティックレビューにはPRISMA 2020が該当します。EQUATORのトップページには708件の報告ガイドラインが掲載されており(2026-10-07に確認した件数)、「Selecting the appropriate reporting guideline」というツールキットのページもあります。
倫理の書き方は倫理承認とインフォームド・コンセントの正しい報告方法、標本サイズはサンプルサイズと検出力分析をご覧ください。
3. 実例:あるオープンアクセス論文のMethodsの構成
実例として、CC BY 4.0で公開されているPubMed Central掲載論文を取り上げます。Luo H, Shen Y. Association between DNA methylation predicted growth differentiation factor 15 and mortality: results from NHANES 1999-2002. Aging Clin Exp Res. 2024;36(1):234(PMID 39625596)[文献6]。この論文は、第5節で使う無作為標本のうちの1本として見つかったもので、「最良のMethods」としてではなく「実在するMethods」の例として示します。下の表は同論文のMethodsを要約したもので、短い語句以外は引用していません。
| 論文中の見出し | 内容 |
|---|---|
| Study population | データの出所とデザイン、使用した調査サイクル、分析対象に至るまでの除外人数(フローチャートで図示)、データ収集機関の審査委員会による倫理承認、インフォームド・コンセント、ヘルシンキ宣言とSTROBE声明に従ったという記述 |
| Data collection | 調査のデータ収集方法、抽出した変数の一覧 |
| Eligible samples and DNA methylation | 検査用試料の適格性、測定の手順とキットの版、派生指標の推定方法 |
| All-cause and cardiovascular mortality | アウトカムの追跡の出所、追跡の終了時点、ICD-10コードによるアウトカム定義 |
| Statistical analysis | 重み付きCoxモデル、3段階の共変量調整モデル、三分位への区分、Kaplan-Meier曲線、制限付き3次スプライン、交互作用検定つきのサブグループ解析、ソフトウェアとバージョン(「R version 4.3.3」と R Foundation for Statistical Computing)、有意水準 |
ここから読み取れることと、読者が疑問に思う点を整理します(確認したのは論文本文のみで、コードや補足資料が別の場所にある可能性はあります)。
- デザイン、STROBE、倫理の記述が最初の小見出しにあります。査読者がすぐ見つけられる配置です。ただしこれはジャーナルごとの選択で、倫理の記述は宣言欄に置かれることもあります。
- 参加者数(21,004人から1,912人)がMethodsに書かれています。STROBE項目13は各段階の人数をResultsに書くよう求め、ICMJEも研究中に得られた情報はResultsに属するとしています。ジャーナルのレイアウトに従うのが基本ですが、選べるなら人数とフローチャートはResultsに置きます。
- Rのバージョンは書かれていますが、パッケージはすべて書かれているわけではありません。本文に名前があるRパッケージは細胞組成の推定に使ったものだけで、重み付きCoxモデルやスプラインに使ったパッケージの名前も、パッケージのバージョンも書かれていません。重み付けを再現したい査読者は問い合わせるしかなく、これは第8節で述べる種類の指摘です。
4. Rの実データで作る統計解析の段落
統計解析の段落に何を書き、どの数字をMethodsとResultsのどちらに置くかを示すため、NHANES::NHANESで実際に解析しました。これは米国の国民健康栄養調査(NHANES、2009〜2012年)から再抽出した10,000行のデータです。パッケージのヘルプには、教育目的であれば単純無作為標本として扱ってよいこと、実際の解析では調査の重みと設計変数を使うべきというNCHSの警告が書かれています。したがって以下は「Methodsの書き方」の教材であり、母集団の推定でも因果の主張でもありません。
問い(Methodsでは、数字を見る前に固定しておくものです):20〜59歳の成人で、BMIが5 kg/m²高いと、収縮期血圧(BPSysAve、データセットの複合読み取り値)は年齢・性別・人種/民族(Race1)で調整したときにどれだけ高いか。
# R 4.3.3; NHANES 2.1.0, lmtest 0.9-40, sandwich 3.1-1
library(NHANES); library(lmtest); library(sandwich); library(splines)
d  <- NHANES
a  <- d[!is.na(d$Age) & d$Age >= 20 & d$Age <= 59, ]            # 適格基準:20〜59歳
b  <- a[!(!is.na(a$PregnantNow) & a$PregnantNow == "Yes"), ]    # 妊娠中を除外
vars <- c("BPSysAve", "BMI", "Age", "Gender", "Race1")
cc <- b[complete.cases(b[, vars]), ]                             # 完全ケース解析
cc$BMI5 <- cc$BMI / 5                                            # 5 kg/m2あたり
m1 <- lm(BPSysAve ~ BMI5 + Age + Gender + Race1, data = cc)
bptest(m1)                                                       # studentized Breusch-Pagan
V  <- vcovHC(m1, type = "HC3"); coeftest(m1, vcov. = V)          # HC3ロバスト標準誤差
m2 <- lm(BPSysAve ~ ns(BMI, 3) + Age + Gender + Race1, data = cc)
anova(lm(BPSysAve ~ BMI + Age + Gender + Race1, data = cc), m2)  # 線形性の確認
sessionInfo()
出力(Rセッションからの転記、2026-10-07):
Participants: all rows 10000; aged 20-59 5396; currently pregnant 72 (excluded) -> 5324;
  missing BPSysAve 200, missing BMI 32; complete cases n = 5100 (224 excluded for missing data)
Age mean (SD) 39.6 (11.4); BMI mean (SD) 28.7 (6.8); systolic BP mean (SD) 117.8 (14.7)
female 2459 (48.2%), male 2641 (51.8%)
Unadjusted per 5 kg/m2: 2.305 (95% CI 2.012 to 2.598)
Adjusted (age, sex, race/ethnicity): 1.895; classical 95% CI 1.616 to 2.174
studentized Breusch-Pagan: BP = 155.83, df = 7, p < 2.2e-16
HC3: SE 0.1795, 95% CI 1.543 to 2.247 (t = 10.555)
Spline vs linear BMI: F = 1.3598 (2, 5090 df), p = 0.2568
Residual SE 13.47 on 5092 df; R-squared 0.1653
Residuals: skewness 1.09, excess kurtosis 4.461
sessionInfo(): R version 4.3.3 (2024-02-29), x86_64-pc-linux-gnu, Ubuntu 24.04.4 LTS;
  attached: sandwich 3.1-1, lmtest 0.9-40, zoo 1.8-15, NHANES 2.1.0; base: splines, stats, graphics,
  grDevices, utils, datasets, methods, base
Methodsの段落(結果を見る前に読者が必要とする情報)
Statistical analysis. Continuous variables are summarised as mean (SD) and categorical variables as n (%). The association between body mass index (BMI, per 5 kg/m²) and the combined systolic blood pressure reading was estimated with multiple linear regression adjusted for age (years), sex and race/ethnicity (five categories). BMI was modelled as linear; linearity was checked by comparing this model with a model using a natural cubic spline of BMI (3 degrees of freedom) with an F test. Heteroscedasticity was assessed with the studentized Breusch-Pagan test, and heteroscedasticity-consistent (HC3) standard errors were planned for the reported confidence intervals. Participants with missing outcome or BMI were excluded (complete-case analysis). Tests were two-sided with a significance level of 0.05. No multiplicity adjustment was made because there was one primary exposure-outcome comparison. Analyses used R version 4.3.3 (R Foundation for Statistical Computing, Vienna, Austria) with the NHANES (2.1.0), lmtest (0.9-40) and sandwich (3.1-1) packages; splines is part of base R.
これは、計画が事前に固定されていた場合の書き方の例です。ご自身の事前規定の計画に基づいて書いてください。実施後に結果に合わせて書いてはいけません。後から加えた解析は探索的と明記します(ICMJE)。
対応するResultsの文(数字はここに置く)
Of 10,000 records, 5,396 were aged 20 to 59 years; after excluding 72 current pregnancies and 224 with missing blood pressure or BMI, 5,100 participants were analysed. Each 5 kg/m² higher BMI was associated with 1.90 mmHg higher systolic blood pressure after adjustment (95% CI 1.54 to 2.25, HC3 standard errors; unadjusted 2.31, 95% CI 2.01 to 2.60). The Breusch-Pagan test indicated non-constant variance (p < 0.001), which is why robust standard errors were used. There was no evidence that a spline fitted better than a linear term (F test, p = 0.26).
注目してほしい分担は次のとおりです。Methodsにはモデル、共変量、確認作業、欠測データの扱い、ソフトウェアを書き、Resultsには参加者のフローとすべての数字を書きます。Methodsには「不均一分散の確認を計画していた」とその後の対応を書き、Resultsでその確認が何を示したかを報告します。各統計量の報告方法は統計解析結果の報告方法、統計的仮定の確認、統計検定の選び方をご覧ください。
SAMPL(Lang と Altman, 2015)も、統計手法の記載を同じ層で整理しています[文献3]。予備的解析(変換、カテゴリ化)、主解析(目的、変数、前提、多重比較、有意水準、ソフトウェア)、補足的解析(感度分析、欠測値の補完、前提の検定)です。事後解析は探索的と明記するよう求めています。
5. ソフトウェアとバージョン:公表論文は実際にどう書いているか
ICMJEは統計ソフトウェアとバージョンの明記を求めています。Sandveらの「Ten simple rules for reproducible computational research」(2013年)は、結果が正確なバージョンに依存しうること、新しいバージョンでは古い入力がそのままでは動かない場合があることから、規則3として「Archive the Exact Versions of All External Programs Used」を挙げています[文献5]。では、Rのバージョンは、著者によってどれだけ書かれているのでしょうか。実際に数えました。
方法(再現できるように)。2024年に公表され、全文に「R Foundation for Statistical Computing」を含むPubMed Centralのオープンアクセス論文(PMC検索式 "R Foundation for Statistical Computing" AND 2024[pdat] AND open access[filter]、2026-10-07検索)は12,406件でした。そこから無作為に300件(Pythonの random.seed(2026) と random.sample でID一覧から抽出)を選び、NCBI E-utilitiesで全文XMLを取得しました。300件のうち294件が、参考文献欄以外の本文でR Foundationに言及していました。筆者がその前後の文を読み、Rのリリース番号が書かれているかを分類しました。
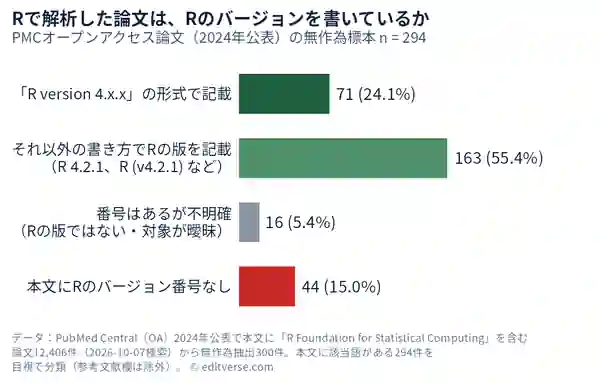
読み方:Rのリリース番号が明確に書かれていたのは約5分の4(294件中234件、79.6%、95%ウィルソン信頼区間74.6%〜83.8%)で、残りの約5分の1(番号なし44件、不明確16件)は、読者に推測を委ねています。
読み方と限界は次のとおりです。
- 「R version」という語句だけを数えると誤解します。PMCの語句検索
"R version" AND "R Foundation for Statistical Computing"は12,406件中3,073件(24.8%)で、標本でも294件中73件(24.8%)が「R version」を含んでいました。しかし、バージョンを書いている著者の多くは別の書き方(R 4.2.1、「version 4.2.1 of R」など)をしています。語句の件数だけを見ると4分の3の論文がバージョンを書いていないように見えますが、実際に読むと書いていないのは約5分の1でした。 - 範囲。1年分、オープンアクセス論文のみ、R利用者のみ、本文のみ(バージョンが補足資料やコード公開先にある場合もあります)、分類者1名、不明確16件は別枠で数えています(「あいまいだがもっともらしい」8件を「記載あり」に含めると242件、82.3%)。パッケージのバージョン、SPSS、Stata、SASは調べていません。特定の分野やジャーナルについての主張として読まないでください。
- EZR。標本のうちEZR(Rのグラフィカルなインターフェース。標本の論文によると自治医科大学で開発)に言及した18件では、Rのリリース番号を書いていたのは7件、書いていなかったのは11件でした。EZR自身のバージョン(例:「EZR version 1.54」)だけを書いて、Rのバージョンを書いていない例もありました。n = 18なので目安にすぎませんが、EZRはRのフロントエンドなので、両方を書いてください。EZR(Easy R)の使い方もご覧ください。
書き方。Rでは sessionInfo() でRのバージョン、プラットフォーム、読み込んだパッケージとそのバージョンが表示され、citation() でRを引用する文が得られます。パッケージは citation("パッケージ名") です。Methodsには1文で十分で(「R version 4.3.3 … with the lmtest (0.9-40) package」)、sessionInfo() の全文は補足資料やリポジトリに置けます。ほかのソフトウェアの書式例は統計解析結果の報告方法をご覧ください。
6. 時制と態
これはEditverseの実務上のアドバイスであり、ICMJEの規則ではありません。行ったことは過去形で書き(「Participants were recruited …」)、方法やデータセットの変わらない性質は現在形で書き、未来形はプロトコルや登録済み報告の計画に限ります。Methodsでは、行為が主題なので受動態がよく使われますが、ジャーナルが許す場合は、誰が何をしたかの曖昧さをなくす能動態の「we」も使えます。詳しくは研究論文における時制:セクション別ガイドと学術文章における能動態と受動態、表現は学術英語表現集をご覧ください。
7. 報告ガイドラインをMethodsにどう書くか
- 研究デザインからガイドラインを選びます。EQUATORのウィザードのページが使えます(コホート・症例対照・横断研究はSTROBE、ランダム化比較試験はCONSORT 2025、システマティックレビューはPRISMA 2020、基本的な統計報告はSAMPL)。EQUATOR Networkで最適な報告ガイドラインを選ぶ方法もご覧ください。
- ガイドライン名を、年と文献とともに1回書きます。MethodsまたはジャーナルのDeclarations欄に、第3節の例論文のように書きます。例:「This study is reported in accordance with the STROBE statement (von Elm et al., 2007).」ジャーナルが求める場合はチェックリストを補足ファイルとして添えます。
- ガイドラインの論文を参考文献に挙げます。略称だけにしません。STROBEは複数の雑誌に同時掲載され、EQUATORのページに一覧があります。PLoS Medicine版はオープンアクセスです[文献1]。
- 実際に行った以上のことを書きません。チェックリストは各項目をどこに書いたかを示すもので、質を保証するものではありません(前述のSTROBE自身の注意書き)。
各ガイドラインの詳細はSTROBE、CONSORT、PRISMAをご覧ください。
8. 査読でよくあるMethodsへの指摘
根拠のあるデータ(ランダム化比較試験のみ)。Hopewellら(2014)は、2012年にBMCシリーズの医学誌に掲載されたランダム化比較試験の報告93件を調べました。査読前の時点で、38%(n=35)は無作為割付の生成方法を、54%(n=50)は割付の隠蔽を、50%(n=46)は盲検化の有無を、34%(n=32)は標本サイズの計算を、35%(n=33)は主要・副次アウトカムを記載していませんでした。査読者の求めた変更のうち報告を改善したものには、無作為化と盲検化の追記・明確化(n=27)、標本サイズ(n=15)、アウトカム(n=16)がありました[文献2]。ほかの研究デザインや雑誌には当てはまりません。
Methodsへの典型的な指摘(Editverseの編集上の整理であり、頻度は主張しません)と対応:
| 指摘(要旨) | 通常の対応 |
|---|---|
| 「選択基準と除外基準を定義してください」 | 適格基準、除外基準、選択元を追記する(STROBE 6) |
| 「標本サイズはどう決めましたか」 | 計算を示す。行っていなければ、その旨と理由を書く(STROBE 10) |
| 「欠測データはどう扱いましたか」 | 扱いの規則(完全ケース、補完)をMethodsに、人数をResultsに書く(STROBE 12c) |
| 「どの比較にどの統計検定を使いましたか」 | 最後に1か所へ並べず、解析ごとに手法を示す(SAMPL) |
| 「前提は確認しましたか」 | 確認内容と、満たされなかった場合の対応を書く(SAMPL) |
| 「ソフトウェアとバージョンは」 | 名称、バージョン、主要パッケージを追記する(ICMJE) |
| 「この解析は事前に規定されていましたか」 | 探索的な解析はそう明記する(ICMJE) |
| 「倫理承認と同意の詳細を示してください」 | 審査機関、承認、同意の記述を追記する(ICMJE。倫理承認の記事を参照) |
各指摘には回答レターで1点ずつ答え、修正後のMethodsの文面を示します(査読反論レター書き方とテンプレート、査読で統計を指摘されたら)。行っていないことは決して追記せず、行わなかったのであればそのとおりに書きます。
提出前に、Methodsをチェックリストに照らして第三者の目で確認したい方へ
Editverse Japanの報告ガイドライン準拠確認(19,800円)では、研究デザインに合う報告ガイドラインの特定、チェックリスト項目ごとの確認、不足項目の指摘と改善提案、記入済みチェックリストの納品を行います。納期の目安は3〜5営業日です。研究デザイン、解析、結果の解釈は著者ご自身の判断で、本サービスは言語・構成・報告の面を支援します。
統計手法の記述や解析については医学統計解析サポート(79,800円)があります。原稿1本単位で、採択まで追加料金なしでサポートを継続します(採否はジャーナルが判断し、採択を保証するものではありません)。無料のお見積もりはお問い合わせから、執筆支援全般は論文執筆支援をご覧ください。
まとめ
- Methodsは、専門知識のある読者が研究を判断・検証できるようにするためのセクションです(ICMJE)。研究デザイン、場所と期間、対象者、変数、データの出所、バイアス、標本サイズ、統計、倫理、ソフトウェアとバージョンを書きます。
- ジャーナルが型を指定していないときは、STROBEのMethods項目の順序(項目4〜12)が無理のない見出しの順序です。参加者数はResultsに書きます。
- 統計解析の段落には、モデル、共変量、確認作業、欠測データの扱い、有意水準、多重性への対応、ソフトウェアを書き、数字はResultsに置きます。NHANESの実例では、Breusch-Pagan検定(p < 0.001)を受けてHC3の区間(BMI 5 kg/m²あたり1.90 mmHg、95% CI 1.54〜2.25)を報告しました。
- 2024年のオープンアクセスR論文294件の標本では、79.6%がRのリリース番号を明確に書き、15.0%は書いていませんでした。「R version」という語句だけを数えると約25%に見えます。
- 報告ガイドラインは参考文献とともに1回明記します。査読のMethodsへの指摘には、足りない情報を追記して答え、行っていないことを書き足してはいけません。
公費・研究費でのお支払い
見積書・納品書・請求書の発行に対応しています。詳細は公費・研究費でのお支払いをご覧ください。ご相談・お見積もりはお問い合わせからどうぞ。
関連記事
- 論文の書き方|IMRaD構成と「書く順番」を実データで解説
- 【統計の書き方】論文における統計解析結果の報告方法
- 【完全ガイド】EQUATORネットワークで最適な報告ガイドラインを選ぶ方法
- 倫理承認とインフォームド・コンセントの正しい報告方法
- 研究論文における時制:セクション別ガイド
- サービス:論文執筆支援
よくある質問
Q. 論文のMethodsには何を書きますか?
研究デザイン、場所と期間、対象者とその適格基準・選択方法、定義した変数、データの出所と測定、バイアスと標本サイズ、統計手法、倫理審査、ソフトウェアとバージョンです。ICMJEの原則は、データにアクセスできる他者が結果を再現できる程度の詳しさです。
Q. Methodsの見出しはどの順序にしますか?
ジャーナルの指定に従います。型がなければ、STROBEチェックリストの項目4〜12の順序(デザイン、場所、対象者、変数、データの出所、バイアス、標本サイズ、定量変数、統計手法)が無理のない標準で、倫理とソフトウェアを加えます。
Q. ソフトウェアのバージョンは必須ですか?
ICMJEは統計ソフトウェアとバージョンの明記を求めています。2024年のオープンアクセスR論文294件の標本では、79.6%がRのリリース番号を明確に書いていました。
Q. STROBEやCONSORTなどの報告ガイドラインはどう引用しますか?
MethodsまたはDeclarations欄に、ガイドライン名を年と文献とともに1回書き、ジャーナルが求めればチェックリストを添えます。チェックリストは各項目の記載箇所を示すもので、質を保証するものではありません。
Q. 参加者数や除外人数はMethodsとResultsのどちらに書きますか?
STROBE項目13は各段階の参加者数をResultsに置くよう求め、ICMJEも研究中に得られた情報はResultsに属するとしています。Methodsにフローを置くジャーナルもあるため、投稿規程に従ってください。
参考資料
PubMed IDとDOIは2026年10月7日にNCBI E-utilitiesのesummaryで確認しました。
- von Elm E, Altman DG, Egger M, Pocock SJ, Gotzsche PC, Vandenbroucke JP. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. PLoS Med. 2007 Oct 16;4(10):e296. doi: 10.1371/journal.pmed.0040296. PMID: 17941714. PMCID: PMC2020495。
- Hopewell S, Collins GS, Boutron I, et al. Impact of peer review on reports of randomised trials published in open peer review journals: retrospective before and after study. BMJ. 2014;349:g4145. doi: 10.1136/bmj.g4145. PMID: 24986891.(抄録を確認)
- Lang TA, Altman DG. Basic statistical reporting for articles published in biomedical journals: the “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. Int J Nurs Stud. 2015 Jan;52(1):5-9. doi: 10.1016/j.ijnurstu.2014.09.006. PMID: 25441757.(SAMPL本文はEQUATOR NetworkのPDFで確認)
- Hopewell S, Chan AW, Collins GS, et al. CONSORT 2025 statement: updated guideline for reporting randomised trials. PLoS Med. 2025 Apr 22;22(4):e1004587. doi: 10.1371/journal.pmed.1004587. PMID: 40228477. PMCID: PMC11996237。
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013 Oct 9;9(10):e1003285. doi: 10.1371/journal.pcbi.1003285. PMID: 24204232. PMCID: PMC3812051(全文を確認)。
- Luo H, Shen Y. Association between DNA methylation predicted growth differentiation factor 15 and mortality: results from NHANES 1999-2002. Aging Clin Exp Res. 2024;36(1):234. doi: 10.1007/s40520-024-02896-3. PMID: 39625596. PMCID: PMC11614981(CC BY 4.0、全文を確認)。
ガイドライン・ソフトウェア・データ(いずれも2026-10-07に確認)
- ICMJE. Preparing a Manuscript for Submission to a Medical Journal:ICMJE Recommendations
- EQUATOR Network. STROBE、SAMPL、CONSORT 2025、PRISMA 2020、Writing research、Selecting the appropriate reporting guideline。STROBE横断研究版チェックリストPDF:PDF
- R Core Team. R(
citation()の出力、R 4.3.3)。NHANES::NHANESのRヘルプ(パッケージ版2.1.0、作者 R. Pruim)