【仮説検定のフレームワーク】研究仮説から統計結論までの7ステップ
仮説検定は研究の問いを統計的に検証するための体系的なプロセスです。研究仮説の設定から統計的結論の導出まで、各ステップを正確に実行し論文に記述することで、査読者の信頼を得られます。本記事では、Neyman-Pearsonフレームワークとベイズ的アプローチの両方を解説します。
1. 研究仮説の立て方
良い研究仮説の条件(PICO形式):
- P: Population(対象集団を明確に)
- I: Intervention/Exposure(介入・曝露を特定)
- C: Comparison(比較対象の設定)
- O: Outcome(測定可能なアウトカム)
例: 「(P)2型糖尿病患者において、(I)12週間の有酸素運動が(C)通常ケアと比較して(O)HbA1cを有意に低下させるか」
2. 帰無仮説と対立仮説の設定
| 仮説の種類 | 内容 | 例 |
|---|---|---|
| 帰無仮説(H₀) | 効果なし、差なし、関連なし | H₀: μ₁ = μ₂(2群の平均は等しい) |
| 対立仮説(H₁) | 効果あり、差あり(方向性を含む) | H₁: μ₁ ≠ μ₂(2群の平均は異なる) |
| 片側対立仮説 | 方向性を指定 | H₁: μ₁ > μ₂(介入群が高い) |
HARKing(Hypothesizing After Results are Known)の回避:
結果を見てから仮説を設定する(HARKing)は研究倫理に反します。仮説は研究開始前に事前登録することが強く推奨されます。
結果を見てから仮説を設定する(HARKing)は研究倫理に反します。仮説は研究開始前に事前登録することが強く推奨されます。
3. Neyman-Pearsonフレームワーク
| 概念 | 内容 | 詳細参照 |
|---|---|---|
| 有意水準α | Type I errorの許容率(通常0.05) | 第1種・第2種の過誤 |
| 検出力(1-β) | 真の効果を検出する確率(通常0.80) | 検出力分析 |
| 棄却域 | H₀を棄却するための検定統計量の範囲 | — |
| P値 | H₀のもとでの観察データの確率 | P値の解釈 |
4. 片側検定 vs 両側検定
| 検定タイプ | 使用条件 | 有意水準の分割 | 推奨度 |
|---|---|---|---|
| 両側検定(two-tailed) | 効果の方向性が予測不可能 | α/2 = 0.025 × 両端 | (標準) |
| 片側検定(one-tailed) | 方向性が事前に明確かつ事前登録済 | α = 0.05 × 片端 | (慎重に使用) |
注意: 片側検定は「都合のよい方向性を後付けで決定する」リスクがあるため、多くのジャーナルは両側検定を標準としています。片側検定使用の場合は事前に仮説を登録し、その根拠を論文で明示してください。
5. ベイズ的アプローチとの比較
| アプローチ | 頻度論(Neyman-Pearson) | ベイズ統計 |
|---|---|---|
| 問い | H₀のもとでのデータの確率 | データが与えられたときのH₁の確率 |
| 主要指標 | P値 | ベイズ因子(BF) |
| 事前知識 | 組み込まない | 事前分布として組み込む |
| 解釈 | 「H₀のもとでは稀」 | 「H₁はH₀の何倍もっともらしいか」 |
| 適用場面 | 標準的な仮説検定 | 事前知識が豊富・逐次解析 |
仮説をメソッド・リザルトセクションに統合する
研究仮説の記述はイントロダクションの末尾、検定の記述はメソッドセクション、検定結果はリザルトセクションに分配します。各セクションの英語表現については学術英語表現集を参照してください。また統計報告完全ガイドで実例を確認しましょう。
6. 完全な仮説検定プロセス(7ステップ)
| ステップ | 内容 | 記述箇所 |
|---|---|---|
| Step 1 | 研究仮説の設定(PICO形式) | Introduction末尾 |
| Step 2 | H₀とH₁の明示(片側/両側の選択) | Methods(統計解析) |
| Step 3 | 有意水準αの設定(0.05等) | Methods(統計解析) |
| Step 4 | 事前検出力分析・サンプルサイズ計算 | Methods(サンプルサイズ) |
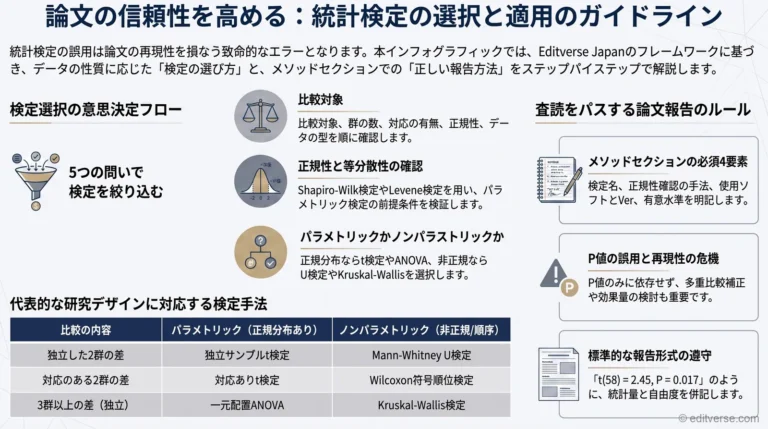
| Step 5 | 統計的仮定の確認 | Methods(統計解析) |
| Step 6 | 検定の実施・P値と効果量の算出 | Results |
| Step 7 | 結果の解釈と考察(臨床的意義) | Discussion |
7. 論文への記述例
Introduction末尾の仮説記述例:
“We hypothesized that 12-week aerobic exercise training would significantly reduce HbA1c levels compared to usual care in patients with type 2 diabetes. The primary outcome was the between-group difference in HbA1c change from baseline to 12 weeks.”
“We hypothesized that 12-week aerobic exercise training would significantly reduce HbA1c levels compared to usual care in patients with type 2 diabetes. The primary outcome was the between-group difference in HbA1c change from baseline to 12 weeks.”
Methods統計解析記述例:
“All hypotheses were tested two-sided at a significance level of α = 0.05. The primary hypothesis was tested using an independent-samples t-test after confirming normality (Shapiro-Wilk test) and homoscedasticity (Levene’s test). Effect sizes were calculated as Cohen’s d with 95% confidence intervals.”
“All hypotheses were tested two-sided at a significance level of α = 0.05. The primary hypothesis was tested using an independent-samples t-test after confirming normality (Shapiro-Wilk test) and homoscedasticity (Levene’s test). Effect sizes were calculated as Cohen’s d with 95% confidence intervals.”
参考PMID
| PMID | 著者 | 内容 |
|---|---|---|
| 27225100 | Wasserstein & Lazar (2016) | ASA声明 — 仮説検定の正しい実践 |
| 25892050 | Open Science Collaboration (2015) | HARKingと仮説の事後設定の問題 |
| 30581843 | Amrhein et al. (2019) | 仮説検定パラダイムの限界と代替 |
| 28817453 | Benjamin et al. (2018) | 仮説検定における有意水準の設定 |
| 26186117 | Ioannidis (2015) | 仮説検定の誤実践とその影響 |
統計専門家による仮説検定レビュー
研究仮説の設定から統計的結論の導出まで、Editverse Japanの統計チームが論文全体の整合性をチェックします。採択率向上のためのアドバイスも提供します。
関連サービス:医学統計解析サポート
仮説検定の枠組みを、研究デザインに合わせて設計する
検定手法の選択を誤ったまま解析を進めると、査読段階でのやり直しになります。研究デザインに応じた手法選択、前提条件の確認、解析の実施、図表作成までを定額¥79,800で。再現可能なRスクリプトと出力ログを納品します。執筆まで含む「データから論文へ」パッケージは定額¥238,000です。