iThenticateの類似度の見方|数値は盗用の判定ではない
iThenticateの「類似度(Similarity Score)」は、原稿の単語のうち、比較データベース内の文章と一致した単語の割合です。盗用かどうかの判定ではなく、すべてのジャーナルに共通する「合格ライン」もありません。Crossrefは、iThenticateは盗用を調べるのではなく類似性を調べるものだと説明し、編集者に対して、一定の数値を超えたら自動的に不採択とすることを勧めていません。レポートを読むときは、数値より先に、どの文献と一致しているか、論文のどの部分か、自分自身の文章かどうか、どんな種類の文章かを確認します。
この記事には、iThenticateのレポートは含まれていません。当社はiThenticateを実行していません。第5節の実例は、実在する公開論文(CC BY)に対して、当社が作成した単純な単語照合の計算を行ったもので、その旨を明記しています。盗用の定義と予防は盗用(プラギアリズム)を防ぐ方法と剽窃の種類と回避方法を、ご自身の過去の文章の再利用は自己剽窃とテキストリサイクリングをご覧ください。
1. 類似度とは何か、何ではないか
Crossrefのドキュメントによると、類似度は、文書内で一致した単語数を、文書全体の単語数で割って求めます。除外オプション(引用文や参考文献など)を使うと、その除外に当たる一致を取り除いて、類似度が再計算されます。新しいSimilarity Reportのヘルプも、概要で同じ計算(一致した単語数を文書全体の単語数で割る)を述べています。
| 類似度は | 類似度では「ない」もの |
|---|---|
| データベース内の1つ以上の文献と一致した単語の割合 | 出典を適切に使っているかどうか、意図の有無を測るもの |
| 除外設定(参考文献・引用文・小さな一致)や、検索するリポジトリによって変わる数値 | ジャーナルや分野を問わず同じ意味を持つ固定の数値 |
| ハイライトされた一致箇所を読むきっかけ | 判定そのもの。Crossrefは、ハイライトされた箇所は「必ずしも盗用を意味せず、類似しているだけ」だと述べています |
公式資料と査読付き論文から、さらに3点を挙げます。
- iThenticateの新しいSimilarity Reportのヘルプは、ハイライトされた一致は「必ずしも盗用を示すものではない」こと、一致が引用文や参考文献に載っている文献である場合もあることを明記しています。
- Elsevierの編集者向けガイダンスは、類似度が高くても盗用された文章を意味するとは限らないこと、30%という数値が1つの文献との30%一致のこともあれば、30の異なる文献との1%ずつの一致のこともあること、引用済みの再利用文、参考文献リスト、Methodsの文章もすべて類似度に含まれうることを述べています。また、レポートを解釈するには編集の専門家の専門知識が不可欠だとしています。
- Manley(2023)[文献2]は、類似度は、盗用の有無を判断するには「決して十分ではない」と述べています。それでも、単純な閾値を使い続けているジャーナルや機関があるとしています。Lykkesfeldt(2016)[文献3]は、1つのジャーナルの2巻分をiThenticateで調べ、自動的あるいは批判的な検討を欠いた使い方は、盗用の程度を公正に判断する基盤としては「あまりにも信頼できない」と結論づけました。判断は上級編集者の仕事のままだとしています。
2. 「何%ならOK」という共通の基準はない|公式ページが述べていること
以下のウェブページは、2026年10月7日に開いて確認しました。表の「記載なし」は、そのページに数値が見当たらなかったという意味で、出版社に内部基準がないという意味ではありません。
| 出典 | 述べていること | ページ上の%の記載 |
|---|---|---|
| Crossref「Understanding your Similarity Report」 | 「一定の類似度を超えたら自動的に不採択とする」ような基準を設けないよう求めています。高い重複を許容できるかどうかは、編集者と査読者が判断するとしています | 記載なし |
| Elsevier「Publishing Ethics Resource Kit(plagiarism detection)」 | 多くのジャーナルの新規投稿をCrossref Similarity Checkで自動的に確認しています。高い類似度は必ずしも盗用を意味せず、専門家による解釈が必要としています | 記載なし(30%と1%の例示のみ) |
| Springer Nature「Editorial policies」(Plagiarism) | 投稿原稿に対してCrossref Similarity Check(iThenticate)を日常的に使用しています。盗用が疑われる論文は調査されます | 記載なし |
| Wiley「Best Practice Guidelines on Research Integrity and Publishing Ethics」 | Crossref Similarity Checkなどで日常的に確認し、「significant and unexplained overlap(重大で説明のない重複)」が見つかった場合はCOPEのガイダンスに従うとしています | 記載なし |
| MDPI「Research and Publication Ethics」 | すべての投稿をiThenticateで確認するとしています。査読中に盗用が見つかった場合は不採択となることがあります | 記載なし |
| COPE「Handling text recycling」(見解) | 編集者は、重複の程度、重複の位置(Methodsで再利用された文章はDiscussionよりも許容されやすい場合がある)、関連論文の開示・引用の有無から、個別に判断するとしています | 記載なし |
| COPE承認の「Text recycling guidelines」(BioMed Centralが作成。Harriman と Patel, 2014[文献7]も参照) | Methodsは、方法の記述の仕方が限られるため、似た表現や同一の表現が現れても珍しくないとしています。Resultsでは、すでに公表したデータを重複して載せる場合、再利用はほぼ常に許容されないとしています | 記載なし |
| Royal Society Publishingのブログ(編集コーディネーター、2019年) | 重複の位置、量、著者が同じか、先行論文がいつ公表されたかを考慮するとしています。IntroductionやMethodsの重複は許容される場合があり、ResultsやDiscussionの重複は要注意の兆候です。プレプリントは自己剽窃とはみなされません | 記載なし |
個々のジャーナルを調べた査読付き研究を見ると、数値をそのまま持ち運べない理由が分かります。
- 2014年にAJRへ投稿された原稿のうち110本を、CrossCheckと目視で評価した研究では、ICMJEの基準を参照基準にして12本(10.9%)に盗用が含まれていました。その12本のうち9本は、引用文と参考文献を除いた全体の類似度が20%未満でした。7本では、単一の文献との最高の一致率が10%未満でした。著者らは、AJR向けの選別ルール(2つのスコアの平均が12%を超えたらさらに確認する)を提案し、現在の検出方法は最適とは言えないと結論しています(Taylorら, 2017)[文献4]。
- Korean Journal of Anesthesiologyに2012年以降に投稿された978本では、類似度の年ごとの平均は16%から19%でした。類似度が両極端の論文は、いずれも不採択率が高く、関係は直線的ではなく、論文の種類によって境目の値も異なりました(Chungら, 2017)[文献5]。
- Memon(2020, オープンアクセス, CC BY-NC)[文献1]は、これまでに報告された境目の値を整理しています。5%以下なら許容する編集者もいれば、20%を超えると精査する編集者もいます。別の論文では、10%を超えると不採択になりやすいと報告されています。Memon自身は、境目の値をそもそも設けないほうが賢明だと論じています。
- 86の英語ジャーナルの編集者・編集委員300人以上を対象にした調査では、大多数が状況によってはテキストリサイクリングが許されると考えていましたが、「どのような場合に適切か、明確な合意はない」ことが示されました(Hallら, 2018)[文献6]。
ここから言えるのは、ジャーナルが独自の内部基準を持っている可能性はあるものの、数値だけからそれを知ることはできないこと、そして経験則の下に収まっていても、コピーした箇所が許容されるわけではないことです。投稿先ジャーナルの投稿規程を確認し、数値を示された場合は編集部に問い合わせてください(第7節)。
3. 何が一致するのか|多くは無害な一致
| 一致するもの | 一致する理由 | 通常の対応 |
|---|---|---|
| 参考文献リスト | 多くの著者が同じ論文を引用するため | 対応は不要。書式だけ確認します |
| 引用文(クォート) | 引用した文章は出典の文章そのものであるため | 引用符と出典が付いているか確認します。引用は短くします |
| 標準的な方法の記述、試薬・キットの説明、統計ソフトの記載 | 同じ手順が似た言葉で書かれるため | 自分の手順を簡潔に書き、元の方法論文を引用します(COPEのガイドライン:方法の記述の仕方が限られる場合、Methodsで似た表現が現れるのは珍しくない) |
| 自分自身のプレプリント | プレプリントがデータベース、またはクロールされるプレプリントサーバーにあるため | 想定内の一致です。Crossrefは、同じ著者のプレプリントとの一致は盗用ではなく、著者が異なるプレプリントとの一致は調査が必要だと述べています |
| 自分自身の過去の論文・学位論文・会議論文 | 同じ著者による同じ文章であるため(学位論文は、検索対象に含まれる場合にだけ一致します) | 引用し、カバーレターで開示し、ResultsとDiscussionは新しい文章で書きます(後述の自己剽窃・二次出版の記事を参照) |
| 他の著者の文章をそのまま、または少し直しただけの箇所 | 表現がまだ出典の表現のままであるため | 引用符と出典を付けて引用するか、ご自身の理解にもとづいて書き直したうえで出典を示します |
データベースの範囲にも注意が必要です。Elsevierは、比較データベースは網羅的ではなく、参加していない出版社の論文やデジタル化以前の研究は含まれていない可能性があると述べています。したがって、類似度が低くても、何もコピーされていないことの証明にはなりません。日本語の文献を英語に訳した文章も同じで、Memon(2020)[文献1]は、翻訳された文章はこうしたツールで見落とされうること、ツールが検出するのは単語であってアイデアではないことを指摘しています。
4. レポートの読み方|6つのステップ
画面の表示名は、iThenticateのバージョン(v1、または新しいSimilarity Report。Crossrefの文書では「iThenticate 2.0」)や、所属機関・ジャーナルの設定によって異なります。以下の表示名は、末尾の参考資料に挙げたベンダーとCrossrefのヘルプページからの引用です。編集者からPDFやスクリーンショットだけが届いた場合は、これらの画面の一部は見られないことがあります。
- まず%を見ない。先に文献(Sources)の一覧を開きます。重複の大半が1つの文献によるものなのか、小さな一致が多数あるのかで状況は変わります(Elsevier)。
- どこで重複しているかを確認する。IntroductionやMethodsの重複と、ResultsやDiscussionの重複は、扱いが異なります(COPE、Royal Society)。
- 相手が自分自身かどうかを確認する。自分のプレプリント、学位論文、過去の論文などです。著者が同じなら、問題は盗用ではなく、開示と新規性になります。
- レポートにMatch Groupsがあれば見る。新しいSimilarity Reportは、引用符と出典が検出されたかどうかで一致を分類します。ヘルプには、「Not Cited or Quoted」「Missing Quotations」「Missing Citation」「Cited and Quoted」の4つのグループが挙げられています。レポートには「Match Groups」と「Sources」の2つの表示があります。
- 除外設定が何をするかを知る。Crossrefのv1の手順には、「Exclude Quotes」「Exclude Bibliography」、小さな文献・小さな一致の除外、見出しで判別した要旨とMethodsの除外が挙げられています。除外のたびに類似度は再計算されます。ただしCrossrefは、これらの機能は正確ではなく近似であり、重要な一致を見逃すおそれがあると注意しています。従来型レポートのiThenticateヘルプも、フィルターや除外を適用しても、文献の重なりなどの要因によって、類似度が変わる場合も変わらない場合もあると述べています。
- 一致箇所ごとに判断する。ハイライトされた箇所それぞれについて、参考文献か、引用文か、標準的な方法の記述か、自分自身の過去の文章か、他の人の文章かを考えます。
5. 実データで見る|同じ原稿でも「類似度」は変わる
これはiThenticateではありません。当社はiThenticateを実行できず、その照合アルゴリズムも分かりません。類似度が「何と比べるか」と「何を除外するか」でどう変わるかを示すために、Rでごく単純な指標を作り、実在する公開論文に適用しました。
- 原稿の文章(投稿原稿とみなして使用):Wu NC, ほか. PLoS Pathog 2020;16(12):e1009089(PMC7744049, CC BY 4.0)[文献8]。
- 比較先1「自分のプレプリント」:同じ論文のbioRxivプレプリント(PMC7523114, CC BY 4.0)[文献9]。雑誌論文のCrossrefメタデータにはプレプリントが記載され(
has-preprint)、bioRxivの記録にも公表版として雑誌論文が記載されています。雑誌論文の著者13人のうち12人が、プレプリントの著者一覧に含まれています。 - 比較先2「無関係な論文」:Shilts J, ほか. Sci Rep 2021;11:413(PMC7801465, CC BY 4.0)[文献10]。関連するウイルス分野の、別の研究グループの論文です。
文章はPMCの全文XML(NCBI E-utilities、2026年10月7日取得)から取得しました。方法:単語を小文字にし、比較先に連続8語以上の同一の並びがあれば、その並びに含まれる単語を「一致」とみなします。類似度 = 一致した単語数 / 全単語数で、Crossrefが述べている類似度の定義に合わせています。対象は、Abstract・Introduction・Results・Discussion・Methods・参考文献リストで、図の説明文、表、補足資料は含めていません。
# XML解析(xml2)は省略。doc[[セクション名]] は小文字の単語ベクトル
tok  <- function(s) stringi::stri_split_regex(stringi::stri_trans_tolower(paste(s, collapse = " ")),
                                              "[^\\p{L}\\p{N}]+", omit_empty = TRUE)[[1]]
kset <- function(sections, k) unique(unlist(lapply(sections, function(w)
          vapply(seq_len(max(0, length(w) - k + 1)), function(i) paste(w[i:(i + k - 1)], collapse = " "), ""))))
matched <- function(w, S, k) {            # k語の並びが比較先にあれば、その語すべてがTRUE
  g <- vapply(seq_len(max(0, length(w) - k + 1)), function(i) paste(w[i:(i + k - 1)], collapse = " "), "")
  m <- rep(FALSE, length(w)); for (i in which(g %in% S)) m[i:(i + k - 1)] <- TRUE; m }
score <- function(doc, S, k, use) 100 * sum(sapply(use, function(s) sum(matched(doc[[s]], S, k)))) /
                                         sum(sapply(use, function(s) length(doc[[s]])))
結果(k = 8。原稿は参考文献を含めて7,417語、参考文献を除くと5,197語、参考文献とMethodsを除くと3,485語):
| 設定 | 自分のプレプリントとの一致 | 無関係な論文との一致 |
|---|---|---|
| 全文(参考文献を含む) | 77.9%(5,777 / 7,417) | 0.5%(36 / 7,417) |
| 参考文献を除外 | 86.2%(4,481 / 5,197) | 0.0%(0 / 5,197) |
| 参考文献とMethodsを除外 | 87.7%(3,056 / 3,485) | 0.0%(0 / 3,485) |
セクション別(自分のプレプリントとの一致)は、Abstract 60.5%、Introduction 98.1%、Results 94.5%、Discussion 75.0%、Methods 83.2%、参考文献 58.4%でした。無関係な論文との一致は、参考文献リストの36語(参考文献リストの1.6%)だけでした。連続一致の最小語数を変えると(参考文献を除外)、プレプリントとの一致は 89.1%(k = 4)、87.8%(k = 6)、86.2%(k = 8)、84.5%(k = 12)、83.5%(k = 16)、無関係な論文との一致は 6.1%(k = 4)、1.8%(k = 6)、0.0%(k = 8、12、16)と動きました。
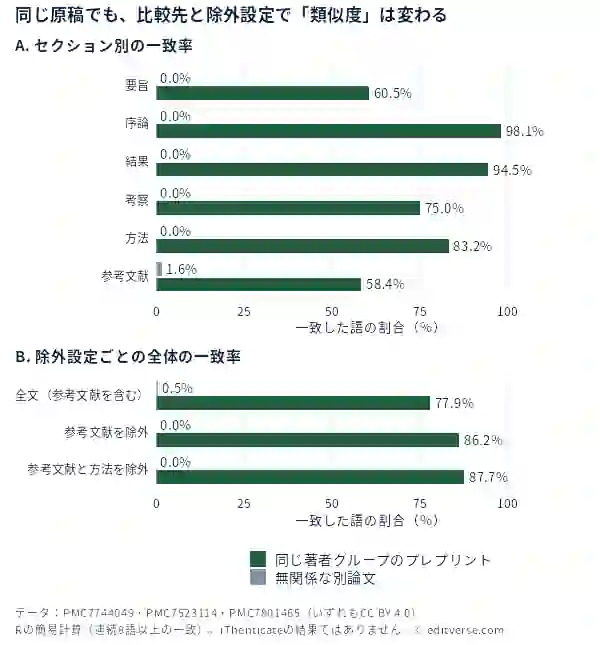
図の読み方:同じ文章が、参考文献とMethodsを除外するかどうかで77.9%、86.2%、87.7%になり、無関係な論文に対しては0.5%以下です。
この結果から言えること
- 約80%でも問題とは限らない。これは、公表された論文を自分たちのプレプリントと比べた値です。Crossrefのドキュメントは、この場合に高い類似度が想定内であることを述べています。
- 除外すると、%が上がることもある。参考文献は本文より一致が少なかったため、参考文献を除外すると百分率は上がりました。
- 数値は、比較先・除外設定・照合ルールで動く。意図については何も語りません。無関係な論文との唯一の重複は、共通する参考文献でした。
この実例の限界:1組の論文、当社独自の1つの照合ルール、投稿ファイルではなくPMCの文章を使っている点です。類似度がどう振る舞うかを示すものであり、iThenticateが実際に特定の原稿に対して返す値を推定するものではありません。
6. 正当な重複の直し方|Editverseの編集上の助言(ジャーナルの規則ではありません)
目的は、正確な出典表示と透明性であり、数値を下げることではありません。出典のアイデアや構成を出典を示さずに使い続けたまま、数値を下げるためだけに文を書き換えても、研究公正の問題は解決しません。
- 引用するか、書き直すか。どちらでも出典を示す。出典から取った文が一致している場合は、引用符を付けて出典を示す(引用は短く)か、出典の内容をご自身で理解したうえで書き直し、出典を示します。数語を入れ替えるだけでは、書き直しにはなりません(Wileyのページは、米国研究公正局(ORI)による盗用の説明として、「substantial unattributed textual copying(出典を示さない相当量の文章のコピー)」を含むとしています)。
- Methods。自分が行ったことを自分の言葉で簡潔に書き、元の方法論文を引用します。一致を避けるために標準的な専門用語をゆがめないでください。Memon(2020)[文献1]は、多くの論文で一致するが盗用ではない、標準的な方法の文の例を挙げています。
- 自分自身の過去の文章。過去の論文を引用し、カバーレターで伝え、ResultsとDiscussionは新しい内容にします。COPE承認のガイドラインは、すでに公表したデータを重複して載せる場合、Resultsでの再利用はほぼ常に許容されないとしています。COPEの見解は、関連論文を開示・引用する透明性を重視しています。Royal Societyのブログも、似た先行論文があればカバーレターに書くよう助言しています。日本語論文を英語で公表したい場合は、二次出版とは?日本語論文を英語で公表する条件をご覧ください。
- プレプリント。プレプリントを引用し、カバーレターにそのDOIを書いて、一致が自分のものだと編集者に分かるようにします(プレプリントの使い方)。
- 参考文献と引用文。レポートで参考文献リストがフラグされていても、修正は不要です。引用文には引用符と出典が付いていることを確認します。新しいレポートの「Missing Citation」と「Missing Quotations」のグループは、まさにこの点を示します。
- 参考文献そのものを確認する。参考文献リストの重複は普通のことですが、誤った文献や実在しない文献は別の問題で、類似度レポートでは見つかりません(参考文献・引用の書き方)。
7. ジャーナルから類似度の数値を指摘されたら
- 編集者が何を見たのかを尋ねる。数値だけには答えようがありません。数値はハイライトされた一致の要約にすぎないので、一致した文献やレポートを丁寧に依頼します。
- 一致を仕分ける。第3節の表を使って、参考文献、引用文、方法の記述、自分のプレプリント・過去の論文、他の人の文章に近すぎる箇所に分けます。
- 一致ごとに回答する。正当な一致は、説明して引用箇所(プレプリントのDOI、元の方法論文)を示します。近すぎる箇所は書き直し、何を変えたかを書きます。再利用した自分の文章は開示し、引用します。
- 協力的な姿勢で書く。判断は編集者のものであり、修正依頼になることも不採択になることもあります。特定の結果を保証するものではありません。
回答の骨子(編集上の例です。角括弧の部分はご自身のレポートの事実に置き換え、状況に合わせて調整してください):
Thank you for sharing the similarity report. The match with [source 1] corresponds to our preprint [DOI], which is cited as reference [n] and disclosed in the cover letter. The remaining matches are reference-list entries and standard wording of the [method name] procedure, for which we now cite the original method paper [n]. In [section], we rewrote [passage] in our own words and added the missing citation. We are happy to provide further information.
和訳:類似度レポートをお知らせいただきありがとうございます。[比較先1]との一致は、参考文献[n]として引用し、カバーレターでも明示した当方のプレプリント[DOI]に該当します。残りの一致は参考文献リストの項目と、[方法名]の手順の標準的な記述であり、元の方法論文[n]を新たに引用しました。[セクション]では、[該当箇所]をご自身の言葉で書き直し、不足していた引用を追加しました。ほかにも情報が必要でしたら、喜んでお知らせします。
編集者への回答の構成は、査読反論レター(Rebuttal Letter)書き方とテンプレートも参考にしてください。投稿前の確認事項はデスクリジェクト防止チェックリストにまとめています。
8. Crossref Similarity Checkとの関係
Crossrefの「Similarity Check」のページによると、Similarity CheckはCrossrefが提供し、iThenticateを基盤とするサービスです。Crossrefの会員(出版社など)は、Turnitin社のiThenticateを割引料金で利用できます。会員は自社が公表した全文をTurnitinのデータベースに提供し、DOIの付いたコンテンツを実際に公表している会員だけが、この調整されたiThenticateの利用環境を使えます。ツール本体、またはジャーナルの投稿システム(API経由)を通じて、類似度(Similarity Score)とハイライトされた一致箇所を含むSimilarity Reportが作成され、編集者がその一致箇所を確認して、原稿の独創性について自ら判断します。
したがって、ジャーナルが「Similarity Checkを使っている」と言うとき、それは出版社が共有するデータベースを使ったiThenticateを指しています。Springer NatureとWileyはポリシーのページでCrossref Similarity Checkを挙げ、ElsevierはこれをiThenticateを基盤とするものと説明し、MDPIはiThenticateを挙げています。Crossrefは、このサービスの利点を受けられるのはSimilarity Checkの会員だけだと述べているため、個々の著者がCrossrefのサービスを直接使うことはできません。ご自身が利用できるものについては、所属機関やジャーナルにご確認ください。
9. Editverse Japanがお手伝いできること
引用と参考文献の整合性を、投稿前に確認したい方へ
Editverse Japanの引用・参考文献の整合性監査(定額 29,800円)は、原稿中のすべての引用が実在するか、書誌情報が一致しているか、本文の主張が出典に支持されているか、撤回・訂正の対象になっていないかを1件ずつ確認し、投稿先の規程に沿った形式に整えるサービスです。標準納期は5〜7営業日です。なお、このサービスは類似度レポート(iThenticateなど)を発行するものではなく、類似度チェックの代わりにもなりません。出典に支持されていない記述については、指摘とご提案までを行い、最終的な判断は著者が行います(ICMJE・COPE準拠)。採否はジャーナルの編集者・査読者が判断し、採択を保証するものではありません。
ご自身で書き直した英文の文法や表現を確認したい場合は、スタンダード英文校正(¥9,800〜、単語数に応じてお見積もり)をご覧ください。変更履歴付きのWord文書で納品します。校正は文章の正確さと読みやすさを整えるもので、出典の扱いや研究内容の判断は著者の責任です。
まとめ
- 類似度は、一致した単語数を全単語数で割った値で、盗用の判定ではありません(Crossref、iThenticateのヘルプ)。
- 今回開いた公式ページのどれも、合格となる%を定めていません。Crossrefは自動的に不採択とするスコアを設けないよう求め、COPEは重複の程度・位置・透明性から個別に判断するとしています。
- 数値より先に、文献、セクション、著者が同じか、一致の種類を確認します。自分のプレプリントと参考文献リストの一致は想定内です。
- 直すときは、引用するか、本当に書き直して出典を示します。方法論文と過去の自分の論文を引用し、カバーレターで開示します。
- ジャーナルから数値を示されたら、一致した文献を尋ね、一致ごとに回答します。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 出版サポート・J-STAGE投稿支援
- 【研究者必読】盗用(プラギアリズム)を防ぐ方法
- 剽窃の種類と回避方法|直接・モザイク・自己剽窃
- 自己剽窃とテキストリサイクリング:何が許されるか完全解説
- 二次出版とは?日本語論文を英語で公表する条件【ICMJE準拠】
- プレプリントの使い方|arXiv・bioRxiv・medRxiv比較
- 学位論文の剽窃チェック:大学10校の公開ページに見る運用の違い
よくある質問
Q. 類似度が何%を超えると盗用とみなされますか?
今回開いた公式ページには、そのような基準はありません。Crossrefは、数値だけで自動的に不採択とすることを勧めておらず、編集者が一致箇所を見て判断するとしています。ジャーナルが独自の選別基準を持っている場合もありますが、それは投稿先ジャーナル自身に確認するしかありません。
Q. 何%なら許容されますか?
共通の数値はありません。個々のジャーナルの報告は異なり(Memon 2020、Taylorら 2017、Chungら 2017)、同じ%でも、一致の相手、セクション、著者が同じかどうかによって、無害にも深刻にもなります。
Q. 自分のプレプリントとの一致は不利になりますか?
Crossrefのドキュメントは、原稿と同じ著者のプレプリントとの間に高い類似度が出るのは想定内で問題ないとしています。著者が異なるプレプリントとの一致は調査が必要です。プレプリントを引用し、カバーレターでも伝えてください。
Q. 参考文献や引用文を除外すれば、数値を下げられますか?
ツールにはそうした除外機能があり、類似度は再計算されます。ただしCrossrefは、除外は近似であり、重要な一致を見逃すおそれがあると注意しています。レポートをどう読むかは編集者が決めます。目的は、数値を小さくすることではなく、出典を正しく示すことです。
Q. iThenticateとCrossref Similarity Checkの違いは何ですか?
iThenticateはTurnitin社の文章照合ソフトウェアです。Crossref Similarity Checkは、Crossrefが会員向けに提供するサービスで、iThenticateの割引利用と、会員が公表した文章の共有データベースを提供します。
参考資料
PubMed収載の文献(各文献は2026年10月7日にNCBI E-utilitiesのesummaryで確認。全文を読んだのはMemon 2020のみで、ほかは抄録の範囲で使用)
- Memon AR. Similarity and Plagiarism in Scholarly Journal Submissions: Bringing Clarity to the Concept for Authors, Reviewers and Editors. J Korean Med Sci. 2020 Jul 13;35(27):e217. doi: 10.3346/jkms.2020.35.e217. PMID: 32657084. PMCID: PMC7358069.
- Manley S. The use of text-matching software’s similarity scores. Account Res. 2023 May;30(4):219-245. doi: 10.1080/08989621.2021.1986018. PMID: 34569370.
- Lykkesfeldt J. Strategies for Using Plagiarism Software in the Screening of Incoming Journal Manuscripts: Recommendations Based on a Recent Literature Survey. Basic Clin Pharmacol Toxicol. 2016 Aug;119(2):161-164. doi: 10.1111/bcpt.12568. PMID: 26876730.
- Taylor DB. JOURNAL CLUB: Plagiarism in Manuscripts Submitted to the AJR: Development of an Optimal Screening Algorithm and Management Pathways. AJR Am J Roentgenol. 2017 Apr;208(4):712-720. doi: 10.2214/AJR.16.17208. PMID: 28125269.
- Chung S, Lee J, Lee Y, Park HY, Kim D. Characteristics of the similarity index in a Korean medical journal. Korean J Anesthesiol. 2017 Jun;70(3):327-334. doi: 10.4097/kjae.2017.70.3.327. PMID: 28580084. PMCID: PMC5453895.
- Hall S, Moskovitz C, Pemberton MA. Attitudes toward text recycling in academic writing across disciplines. Account Res. 2018;25(3):142-169. doi: 10.1080/08989621.2018.1434622. PMID: 29394122.
- Harriman S, Patel J. Text recycling: acceptable or misconduct? BMC Med. 2014 Aug 16;12:148. doi: 10.1186/s12916-014-0148-8. PMID: 25127654. PMCID: PMC4243367.
- Wu NC, Yuan M, Bangaru S, ほか. A natural mutation between SARS-CoV-2 and SARS-CoV determines neutralization by a cross-reactive antibody. PLoS Pathog. 2020 Dec;16(12):e1009089. doi: 10.1371/journal.ppat.1009089. PMID: 33275640. PMCID: PMC7744049(CC BY 4.0。第5節の「原稿」の文章)。
- Wu NC, Yuan M, Bangaru S, ほか. 上記論文のbioRxivプレプリント. bioRxiv. 2020 Sep 21. doi: 10.1101/2020.09.21.305441. PMID: 32995788. PMCID: PMC7523114(CC BY 4.0。比較先1)。
- Shilts J, Crozier TWM, Greenwood EJD, Lehner PJ, Wright GJ. No evidence for basigin/CD147 as a direct SARS-CoV-2 spike binding receptor. Sci Rep. 2021 Jan 11;11(1):413. doi: 10.1038/s41598-020-80464-1. PMID: 33432067. PMCID: PMC7801465(CC BY 4.0。比較先2)。
公式ページ(すべて2026年10月7日に閲覧)
- Crossref. Understanding your Similarity Report(ページ末尾の最終更新表示:2020年5月19日)
- Crossref. Working with your Similarity Report
- Crossref. Similarity Check
- iThenticate Guides. Overview of the new Similarity Report experience / How do the Match Groups work in the new Similarity Report? / Navigating the new, enhanced Similarity Report / Managing exclusions and filters in the classic Similarity Report
- Turnitin. Overview of the Similarity Report(iThenticateヘルプ)
- Elsevier. Plagiarism detection(Publishing Ethics Resource Kit)
- Springer Nature. Editorial policies
- Wiley. Best Practice Guidelines on Research Integrity and Publishing Ethics
- MDPI. Research and Publication Ethics
- COPE. Handling text recycling (also known as self-plagiarism)(最終確認日の表示:2024年8月20日)/Text recycling guidelines for editors(BioMed Central作成、2016年7月22日最終確認)/ガイドライン本文(PDF)
- Royal Society. A year of iThenticate – a Royal Society Open Science perspective(2019年7月11日、編集コーディネーターによるブログ記事)
補足:COPE、MDPI、iThenticate Guides、Turnitinのページは、自動取得ツール(curl)では403が返る場合がありますが、ブラウザ相当の取得で内容を確認しました。Turnitinのヘルプの画面表示名は、バージョンや設定で変わることがあります。