メンデルランダム化解析とは|3つの前提と論文での書き方
メンデルランダム化(MR)解析とは、遺伝的変異を操作変数に使い、測定していない交絡に左右されにくい形で因果効果を推定する方法です。関連性・独立性・除外制約の3つの前提と、STROBE-MRに沿った報告が求められます。
この記事でわかること
- MR解析の考え方と、3つの操作変数の前提(第1〜2節)
- 一標本MRと二標本MR、IVW・MR-Egger・加重中央値の違い(第3〜4節)
- 弱い操作変数と「F>10」の目安、水平多面発現の確認方法(第5〜6節)
- Rの実データによる解析例と、図・表の読み方(第7節)
- 査読者に尋ねられやすい点と、STROBE-MRのMethods・Resultsのチェックリスト(第8〜9節)
- MRが向かない場合(第10節)
本記事が扱うのはMRに限ります。交絡とは何か、測定済みの交絡をどう調整するかは交絡因子とは|調整方法と論文での書き方を、観察研究の報告全般はSTROBE声明で観察研究を正しく報告する方法をご覧ください。数値は、公開されている論文・Rパッケージの同梱データ・PubMed検索の結果に基づきます。解析例は手順を示すための教材であり、特定の疾患や治療についての結論ではありません。
1. メンデルランダム化とは|やさしく言うと
観察研究で「Xが高い人はYになりやすい」と分かっても、XとYの両方に影響する別の要因(交絡)や、Yが先にあってXが変わる逆の因果が混ざると、Xを変えたときにYが変わるのかは分かりません。Davey SmithとEbrahim(2003)は、親から子へ遺伝子が偶然に割り振られる性質に着目しました。曝露と関連する遺伝的多型は、通常の観察研究を悩ませる交絡や逆の因果の影響を受けにくいため、その関連を使えば曝露の因果的な役割を評価できる、という考え方です。
STROBE-MRの解説論文(Explanation and Elaboration、BMJ 2021)は、これを次のように説明しています。遺伝的変異は受胎のときにほぼ無作為に親から子へ受け継がれるので、曝露とアウトカムの関連を交絡させる多くの要因は、遺伝的変異には影響しません。また、変異がアウトカムによって変わることもないので、逆の因果の影響も受けにくくなります。無作為化比較試験では、くじ引きのような無作為化が割り付けを決めます。MRはこれに似ていますが、割り付けられるのは薬ではなく遺伝的変異です。くじ引きに相当する部分が本当にそう働いているかは、後で述べる前提に左右されます。
| 用語 | 意味(この記事での使い方) |
|---|---|
| 曝露(exposure) | 原因として調べたい要因。例:LDLコレステロール(LDL-C) |
| 操作変数(instrumental variable) | 曝露と関連する変数。MRでは遺伝的変異(多くは一塩基多型、SNP)を使います |
| GWAS(ゲノムワイド関連解析) | 多数の変異と形質の関連を調べた研究。MRでは変異ごとの関連(回帰係数と標準誤差)を取り出して使います |
| 要約統計量(summary data) | GWASが公開している、変異ごとの回帰係数と標準誤差。個人のデータがなくてもMRを実行できます |
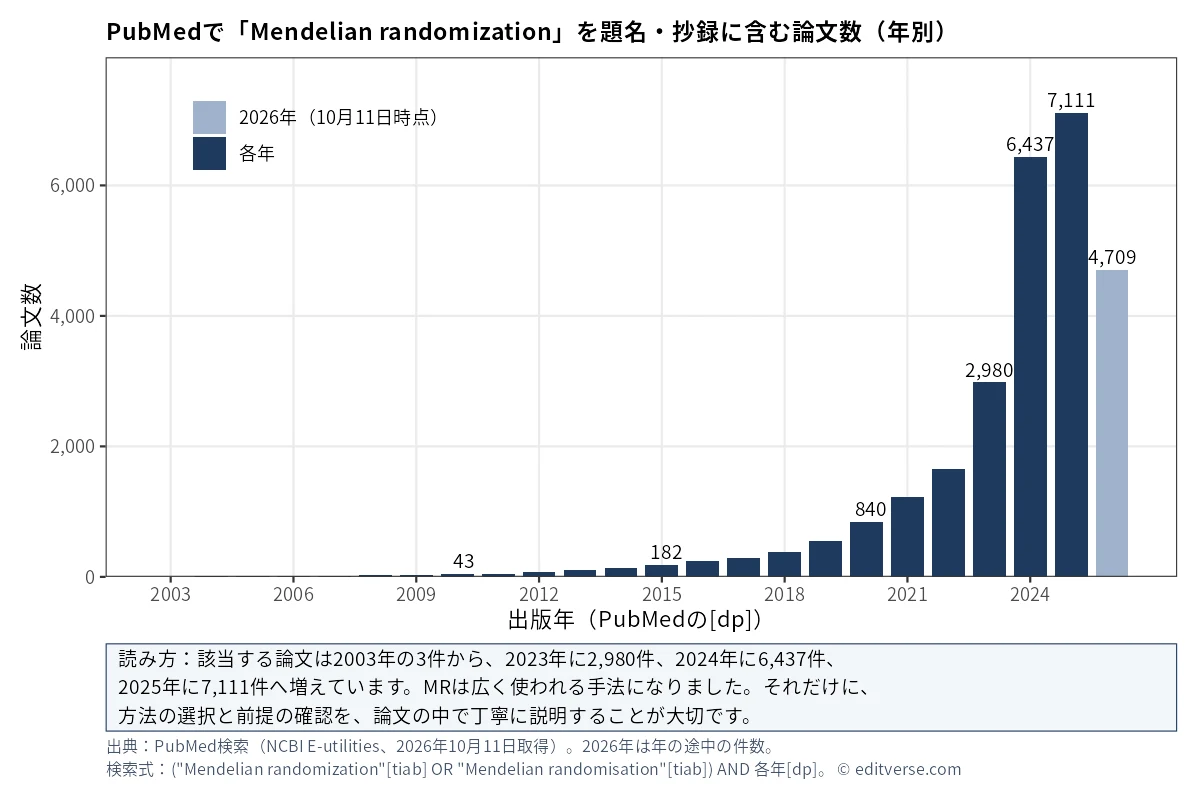
PubMedで「Mendelian randomization」を題名・抄録に含む論文は、2003年の3件から、2023年に2,980件、2024年に6,437件、2025年に7,111件と増えています(図1)。広く使われる手法になった分、前提や感度分析、報告の丁寧さが問われやすくなっていると考えられます(件数からの推測で、査読の実態を調べた結果ではありません)。
あわせて読みたい:交絡因子とは|調整方法と論文での書き方
2. MRが成り立つための3つの前提
遺伝的変異を操作変数として使うMRでは、次の3つの前提が必要です(STROBE-MRの解説論文の用語集による)。STROBE-MRの項目5は、これら3つを、少なくとも主解析について、Methodsに明記するよう求めています。
| 前提 | 意味 | データで確かめられるか |
|---|---|---|
| 関連性(relevance) | 遺伝的変異が、調べたい曝露と関連している | 確かめられます。F統計量やR²で関連の強さを示します(第5節) |
| 独立性(independence) | 遺伝的変異とアウトカムに、共通の(未測定を含む)原因がない | 直接は確かめられません。測定済みの交絡因子と変異の関連を示す、陰性対照を使う、といった方法で一部を評価できます |
| 除外制約(exclusion restriction) | 遺伝的変異は、曝露を通る経路以外ではアウトカムに影響しない(水平多面発現がない) | 直接は確かめられません。MR-Egger、加重中央値などで、成り立たない可能性を示す証拠が得られることがあります(第6節) |
解説論文は、「これらの前提は検証(verify)できないが、ときに反証(falsify)できる」という言い方をしています。結果が前提を満たすことの証明ではなく、前提が崩れていないかを複数の角度から確認する、という姿勢で書くのが誠実です。解説論文にはこのほか、効果が全員で同じであるという「均一性(homogeneity)」の仮定が、推定したい量によっては必要になることも書かれています。
3. 一標本MRと二標本MR|何が違うか
| 一標本MR | 二標本MR | |
|---|---|---|
| データ | 遺伝的変異・曝露・アウトカムを同じ標本で測定。全員の個人レベルのデータが必要 | 変異と曝露の関連、変異とアウトカムの関連を、別の標本で推定し、メタアナリシスの手法で統合。要約統計量でよく、個人レベルのデータは不要 |
| 弱い操作変数のバイアス | 観察研究で見える(交絡した)関連の方向に偏る | 標本に重なりがなければ偏りは小さく、あっても帰無(効果なし)の方向 |
| 注意点 | 変異の選択を、解析する標本での曝露との関連にもとづいて行うと、弱い操作変数バイアスが強まります(Burgessらのガイドライン、文献10) | 2つの標本で、変異と曝露の関連が同じと仮定します。祖先集団などが異なる場合は、その妥当性の説明が必要です |
標本の重なりについては、Burgessら(2016)が、公開されているGWASコンソーシアムの標本が部分的に重なる場合、バイアスの方向と大きさは不確かであること、連続アウトカムでは、バイアスが重なりの割合に比例することをシミュレーションで示しています。STROBE-MRの項目10dは、二標本MRでは、(1)曝露の標本とアウトカムの標本で変異と曝露の関連が似ていることの根拠と、(2)両方の標本に含まれる人数、を報告するよう求めています。項目4は、変異ごとの情報の出どころを表にして示すことを勧めています。
MR-Base(Hemaniら, 2018)のように、GWAS要約統計量を集めたプラットフォームもあります。手軽に実行できる分、方法の理解と報告の丁寧さが一層問われます(第10節)。
4. IVW・MR-Egger・加重中央値|何を仮定しているか
複数の遺伝的変異を使うとき、まず変異ごとに「アウトカムとの関連÷曝露との関連」(Wald比)を計算し、それを統合して1つの推定値にします。統合のしかたが、次の3つの方法の違いです。
| 方法 | やっていること | 成り立つ条件 | 注意 |
|---|---|---|---|
| IVW(逆分散加重法) | 変異ごとのWald比を、精度(逆分散)で重み付けして平均する(Burgessら, 2013) | すべての変異が妥当な操作変数であるときにだけ、一致推定量になる(Bowdenら, 2016a) | 1つでも除外制約を満たさない変異があると偏りうる。変異の間に連鎖不平衡による相関があると、精度を過大に見積もる(Burgessら, 2013) |
| MR-Egger | 変異ごとの結果を回帰し、切片を許す。多面発現による偏りは、メタアナリシスの小規模研究バイアスに似ており、切片が0からずれていれば、その偏りの示唆になる。傾きは因果効果の推定値(Bowdenら, 2015) | 変異と曝露の関連の大きさが、変異がアウトカムに直接与える効果と独立(InSIDE仮定) | 複数の独立した変異が必要。変異と曝露の関連の推定誤差が小さいこと(NOME仮定。I²GXが目安)が必要で、誤差が大きいと、推定値が0の方向に偏ります(Bowdenら, 2016b) |
| 加重中央値 | 変異ごとのWald比の、重み付き中央値をとる(Bowdenら, 2016a) | 情報(重み)の最大50%が無効な変異から来ていても、一致推定量になる(Bowdenら, 2016a) | 無効な変異が半分を超えると、この性質は保証されません |
3つの結果が似ていれば、結論に自信を持ちやすくなります。大きく食い違うときは、変異のすべてが妥当な操作変数ではない可能性があり、因果的な結論は信頼できないと考えるべきだ、とSTROBE-MRの解説論文は例を挙げて述べています(項目13a)。変異が1つだけのときは、Wald比そのものが推定値になります(項目6c)。
5. 弱い操作変数と「F>10」の目安
変異と曝露の関連が弱いと、推定値が偏ります(弱い操作変数バイアス)。関連の強さの指標がF統計量です。「Fが10未満なら弱い操作変数」という目安は広く使われていますが、これは慣習であり、厳密な境界ではありません。STROBE-MRの解説論文は、一標本の解析で偏りの目安としてF<10がよく使われること、10を超えていても弱い操作変数バイアスは起こりうること、この線引きはP=0.05で有意・非有意に分けるのと同じ意味で恣意的であることを述べています。
目安の背景を知っておくと、論文での書き方も変わります。Burgessら(2016)は、真の因果効果が0の場合に、一標本のIV推定値の相対バイアスが10%になるのが、Fが10のときに対応する、と説明しています。つまり「F=10」は「偏りがゼロ」ではなく、「偏りが約1割程度」の目安です。Burgessら(2013)は、シミュレーションから、変異ごとの曝露との関連のP値が1×10⁻⁵未満であれば、弱い操作変数バイアスは小さいと述べています。Fは要約統計量からも近似できます(解説論文のBox 3)。
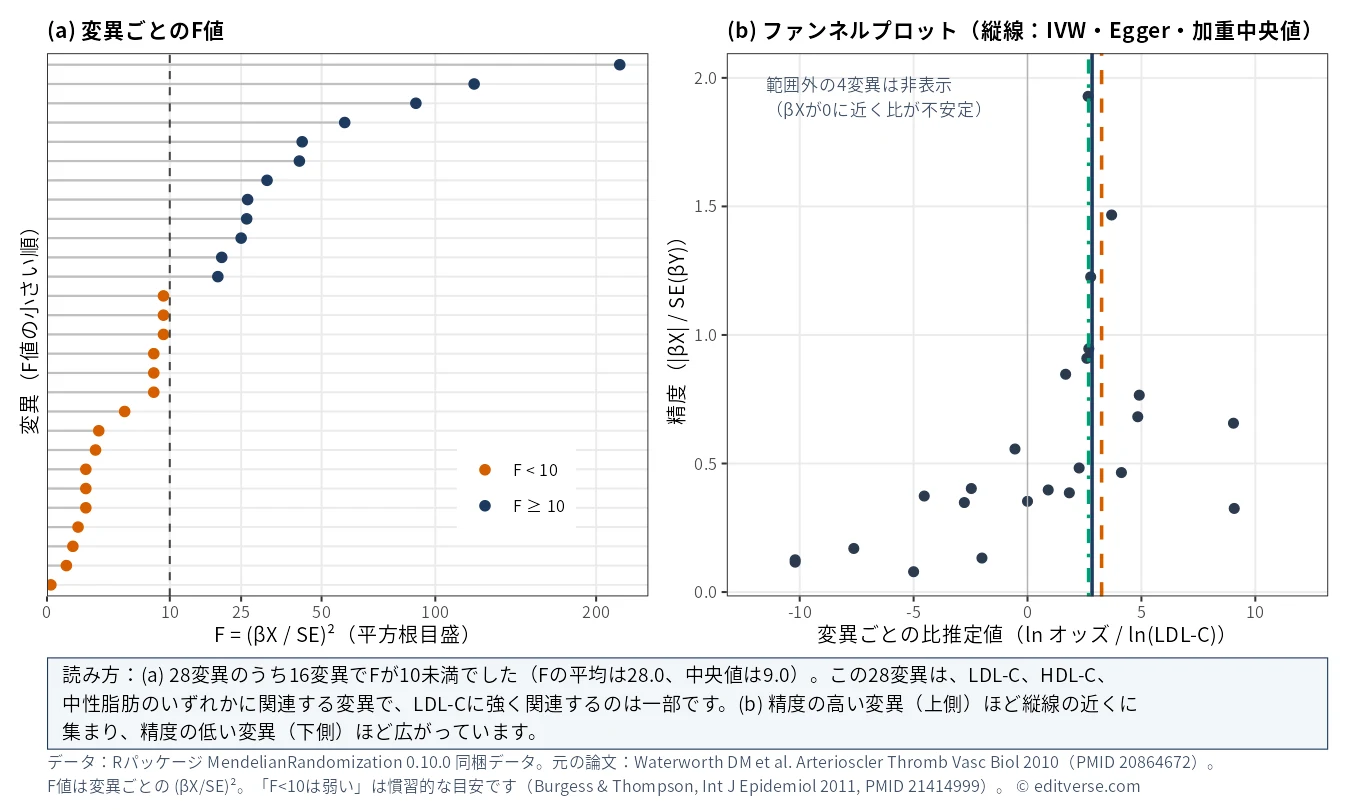
書き方としては、Fの値を示したうえで、操作変数が弱い可能性が残るなら、弱い操作変数に頑健な方法を使ったかどうかも書きます(解説論文のBox 3)。「Fが10を超えたので問題ない」の一文で終わらせないことが大切です。第7節の例では、変異ごとに計算すると、28変異のうち16変異でFが10未満でした。
6. 水平多面発現(プレイオトロピー)の確認
水平多面発現とは、遺伝的変異が、調べたい曝露を通らない経路でアウトカムに影響することで、除外制約の違反であり、MRの偏りの原因になります。一方、曝露と同じ因果経路上にある別の形質を通って影響する場合(垂直多面発現)は、推定値を偏らせないと、解説論文は例を挙げて述べています。確認の方法は1つではなく、組み合わせて報告します。
- 変異ごとの結果を図にする。曝露との関連に対するアウトカムとの関連の散布図、またはファンネルプロットを示します(項目11d。第7節の図2・図3)。
- 変異の間の異質性(Cochran’s Qなど)を見る。この検定は、除外制約だけでなく、独立性と均一性をまとめて検定しているので、「多面発現がない」ことの検定として解釈してはいけない、と解説論文は注意しています。
- MR-Eggerの切片を見る。切片が0からずれていれば、多面発現による偏りの示唆になります。InSIDE仮定と、複数の独立した変異が必要です(第4節)。
- 加重中央値や最頻値の推定値と比べる。IVWと大きく異なるときは、多面発現を疑う手がかりになります。
- その他の方法。解説論文は、leave-one-out解析やMR-PRESSOを使った報告例を挙げています。通常の観察研究の推定値との比較、陰性対照の結果、変異の既知の生物学的な働きも、判断材料になります(Box 3)。
どの方法も、前提が成り立つことを証明するものではありません。結果が一致しない場合の書き方も含め、第8節のチェックリストを使ってください。
7. Rによる実例|28変異のLDL-Cと冠動脈疾患
データ。RのパッケージMendelianRandomization(バージョン0.10.0)には、例示用のデータが同梱されています。ldlc、chdloddsなどは、Waterworthら(2010)が報告した28個の遺伝的変異について、LDL-C、HDL-C、中性脂肪、冠動脈疾患との関連(回帰係数と標準誤差)をまとめたもので、パッケージのヘルプに出典が書かれています。元の論文では、脂質は自然対数変換されており、28変異は3つの脂質のいずれかとの関連が最も強かった変異(元論文の表1)です。元の論文は、冠動脈疾患との関連を、最大9,633例の症例と38,684例の対照で報告しています。
ここでは、LDL-Cを曝露、冠動脈疾患をアウトカムとして、28変異をすべて使い、3つの方法を実行します。これは手順を示すための教材であり、LDL-Cと冠動脈疾患の関係についての新しい結論ではありません。28変異は、LDL-Cだけでなく、HDL-Cや中性脂肪との関連で選ばれた変異を含みます。そのため、LDL-Cの操作変数としては、関連性が弱い変異や、他の脂質を通る経路が混ざる変異を含みやすい設定です。実際の研究では、曝露に対する変異の選び方(P値の基準、連鎖不平衡の扱い、独立した標本での選択)を、事前に決めておく必要があります。
# R 4.3.3; MendelianRandomization 0.10.0
library(MendelianRandomization)

# パッケージ同梱データ:28変異の LDL-C・冠動脈疾患との関連(Waterworth et al. 2010)
# ldlc/ldlcse = 変異とLDL-C(自然対数)の関連とSE、chdlodds/chdloddsse = 変異と冠動脈疾患の対数オッズの関連とSE
x <- mr_input(bx = ldlc, bxse = ldlcse, by = chdlodds, byse = chdloddsse)

mr_ivw(x)                              # 逆分散加重法(乗法的ランダム効果)
mr_egger(x)                            # MR-Egger回帰
mr_median(x, weighting = "weighted")   # 加重中央値

# 変異ごとのF(簡易)= (bx / bxse)^2
Fk <- (ldlc / ldlcse)^2
round(c(mean = mean(Fk), median = median(Fk), n_lt10 = sum(Fk < 10)), 1)
出力(Rのセッションからコピー):
Inverse-variance weighted method
(variants uncorrelated, random-effect model)

Number of Variants : 28

------------------------------------------------------------------
 Method Estimate Std Error 95% CI       p-value
    IVW    2.834     0.530 1.796, 3.873   0.000
------------------------------------------------------------------
Residual standard error =  1.920
Heterogeneity test statistic (Cochran's Q) = 99.5304 on 27 degrees of freedom, (p-value = 0.0000). I^2 = 72.9%.
F statistic = 28.0.

MR-Egger method
(variants uncorrelated, random-effect model)

Number of Variants =  28

------------------------------------------------------------------
      Method Estimate Std Error  95% CI       p-value
    MR-Egger    3.253     0.770  1.743, 4.762   0.000
 (intercept)   -0.011     0.015 -0.041, 0.018   0.451
------------------------------------------------------------------
Residual Standard Error :  1.935
Heterogeneity test statistic = 97.3975 on 26 degrees of freedom, (p-value = 0.0000)
I^2_GX statistic: 91.9%

 Weighted median method

Number of Variants : 28
------------------------------------------------------------------
                 Method Estimate Std Error 95% CI       p-value
 Weighted median method    2.683     0.419 1.862, 3.504   0.000
------------------------------------------------------------------
  mean median n_lt10
    28      9     16
パッケージが出力する「F statistic = 28.0」は、この例では、28変異それぞれの(βX/SE)²の平均と一致します。出力のI²GX(91.9%)は、MR-Eggerの前提(NOME)がどの程度満たされるかの目安です(Bowdenら, 2016b)。0〜100%の値で、100%に近いほどMR-Eggerの推定値が0の方向に薄まる影響は小さく、低いほど強く薄まります。この例の91.9%は、多少の希釈がありうることを示します。
結果の表(3つの方法)
| 方法 | 推定値(ln オッズ/ln(LDL-C)の1単位) | 95%信頼区間 | LDL-Cが10%高いときのオッズ比* |
|---|---|---|---|
| IVW(乗法的ランダム効果) | 2.83 | 1.80〜3.87 | 1.31(1.19〜1.45) |
| MR-Egger | 3.25(切片 −0.011、95%信頼区間 −0.041〜0.018、P=0.45) | 1.74〜4.76 | 1.36(1.18〜1.57) |
| 加重中央値 | 2.68 | 1.86〜3.50 | 1.29(1.19〜1.40) |
*推定値は、LDL-Cの自然対数が1単位高いときの冠動脈疾患の対数オッズの差です。LDL-Cが10%高い(自然対数で ln 1.1 = 0.0953 高い)ときのオッズ比は、exp(推定値 × 0.0953)で換算しました。変異ごとの関連がLDL-Cの自然対数に対するものである、という元論文の記載に基づく換算です。P値は、IVWが8.8×10⁻⁸、MR-Eggerの傾きが2.4×10⁻⁵、加重中央値が1.5×10⁻¹⁰でした。
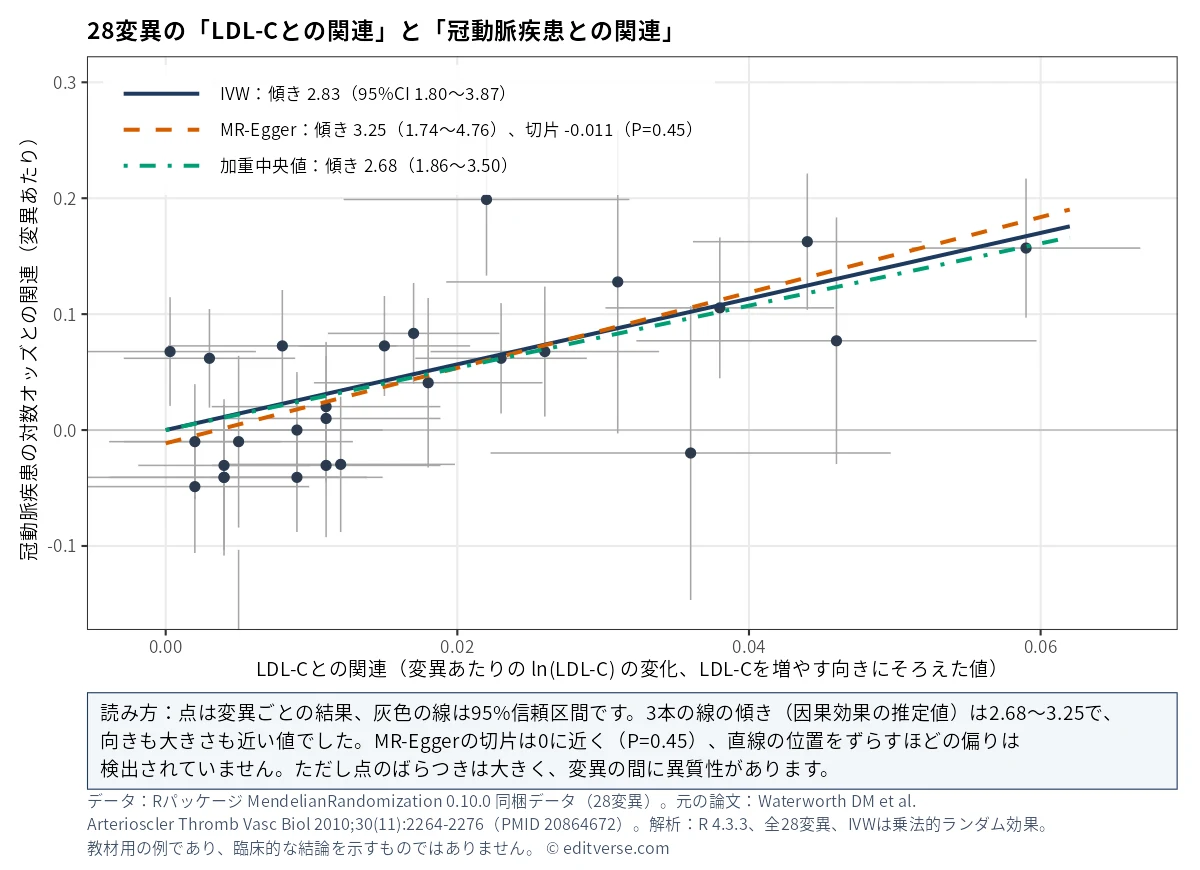
下の図2は、変異ごとの結果の散布図です。傾きが推定値で、IVWと加重中央値は原点を通り、MR-Eggerは切片を持ちます。
次の図3は、第5節で述べた変異ごとのFと、ファンネルプロットです。
結果の読み方
- 3つの方法が近い値を示しました。多面発現による偏りを示す手がかり(MR-Eggerの切片)は、このデータでは見つかりませんでした。ただし、切片の信頼区間は−0.041〜0.018で、小さな偏りを除外できるわけではありません。
- 異質性があります。IVWのCochran’s QはP<0.001でした。第6節のとおり、この検定は除外制約だけを調べるものではありませんが、変異の間で推定値がそろっていないことは、論文で説明する必要があります。
- 操作変数が弱い変異が多く含まれます。事後的な確認として、変異ごとのFが10以上の12変異だけで解析すると、IVWは3.16(95%信頼区間 2.28〜4.03)、加重中央値は2.69(1.87〜3.51)で、全変異の結果と近い値でした。一方、MR-Eggerは1.79(−0.09〜3.68、切片 0.047、P=0.12)となり、変異が少なくなって信頼区間が広がりました。変異を絞る基準は、結果を見る前に決めておくべきで、ここでは教材として結果が分かった状態で実行しています。
- 結論を言い切らない書き方が必要です。MRの推定値は、「遺伝的に予測される差」に基づく推定で、前提が成り立つときにだけ因果効果と解釈できます(項目16bは、因果的な表現に慎重であるよう求めています)。
あわせて読みたい:複数の曝露・アウトカムを同時に検討するときの有意水準は、多重比較補正|Bonferroni・Holm・FDRの選択と論文記述をご覧ください(STROBE-MRの項目6eが対象です)。
8. 査読者に尋ねられやすい点
どの点が尋ねられるかは、雑誌や分野、査読者によって異なります。以下は、STROBE-MRの解説論文、MR研究の実施・査読のためのガイドライン(Burgessら)、臨床家向けの手引き(Daviesら, 2018。抄録のみ確認)も参照して、確認される可能性が高い点を、原稿を準備する側の視点で整理したものです。
- 3つの前提を、研究の文脈に即した言葉で説明しているか。解説論文は、主解析の前提を、Methodsで具体的に書くことを勧めています(項目5)。
- 操作変数をどう選んだか。二標本なら、標本の類似性と重なり。選択基準(P値の閾値、連鎖不平衡の扱い)、どのGWASを使ったか、祖先集団、データの出どころの表(項目4、4c、10d。第3節)。
- 操作変数は十分に強いか。Fの値と、弱い可能性への対応(項目7、12a。第5節)。
- 多面発現と感度分析。複数の方法の結果、異質性、図(項目8、11d、13a。第4・6節)。結果が食い違うときは、その理由の説明。
- 効果の大きさの意味と、表現の慎重さ。単位(SD、対数変換、1 mmol/Lなど)、絶対リスクでの解釈(項目6a、11c)。前提が成り立つときにだけ、遺伝的に予測される差が因果効果と解釈できること(項目16)。
- 新しい方法を使うなら、その妥当性。Stenderら(2024)は、複雑な新しい方法は、適用する前に陽性・陰性対照を含めて厳密に検証されるべきだと述べています(著者らの意見)。
査読コメントへの回答の組み立て方は、査読で統計を指摘されたらもご覧ください。
9. STROBE-MRに沿った報告チェックリスト
STROBE-MRは、メンデルランダム化研究のための報告ガイドラインで、観察研究のSTROBE声明の拡張として作られました。声明(Skrivankovaら, JAMA 2021)と、各項目の意味と報告例を示した解説論文(BMJ 2021)が同時に発表されています。公式サイト(strobe-mr.org)には、チェックリスト(全20項目)が、通常版、記入可能版、Word版でダウンロードできます(確認日:2026年10月11日)。以下は、項目の内容を日本語で言い換えた要約です。投稿時は、必ず原文のチェックリストを使ってください。
STROBE声明そのものの使い方は、STROBE声明で観察研究を正しく報告する方法にまとめています。
Methodsに書くこと
| 項目 | 書くこと |
|---|---|
| 4(4a〜4e) | 一標本か二標本か、個人レベルか要約統計量か。データの出どころ(GWAS、対象者、時期)を表にして示す。変異の測定と品質管理、選択基準。倫理審査と同意 |
| 5 | 3つの前提と、感度分析で使う方法の前提(例:InSIDE仮定) |
| 6a | 量的変数の扱い(尺度、単位、モデル。例:標準偏差1あたり、対数変換) |
| 6b | 変異の扱い(アレルスコアか個別変異か、重みの出どころ) |
| 6c | MRの推定方法(Wald比、IVW、2段階最小二乗法など)、共変量、標準誤差の求め方。二標本では、両方の標本で同じ共変量を使ったか |
| 6d、6e | 欠測データの扱い。複数の曝露・アウトカムを検討したときの多重検定への対応 |
| 7 | 前提の確認方法(Fの計算、独立性・除外制約を確かめる方法、事前の知識) |
| 8 | 感度分析・追加の解析(方法間の比較、独立した再現、バイアスの解析、シミュレーションなど) |
| 9a、9b | ソフトウェアとバージョン、設定。プロトコルの事前登録の有無 |
Results・Discussionに書くこと
| 項目 | 書くこと |
|---|---|
| 10(10a〜10d) | 各段階の人数と除外の理由、変異の要約統計量。メタアナリシス由来のデータなら、異質性の評価。二標本では、標本の類似性の根拠と重なりの人数 |
| 11(11a〜11d) | 変異ごとの関連、MRの推定値(信頼区間つき)、必要に応じた絶対リスク、図(散布図、フォレストプロットなど) |
| 12(12a、12b) | 前提の検討結果(関連性ならFなど)、追加の統計量 |
| 13(13a〜13e) | 感度分析の結果、方向性の検討、通常の観察研究の推定値との比較、追加の図 |
| 14〜17 | 主な結果、限界(前提の妥当性、他のバイアス、精度。方向と大きさも)、解釈(意味、メカニズム、臨床的な意義)、一般化可能性 |
| 18〜20 | 資金、データ・コードの共有、利益相反 |
この表は、STROBE-MRの解説論文(BMJ 2021、CC BY 4.0)の項目見出しをもとに、当サイトが日本語で要約したものです。倫理審査や同意の要否は、研究計画ごとに異なります。最終的な判断は、所属機関の倫理審査委員会・研究支援部門にご確認ください(確認日:2026年10月11日)。審査が不要になりうる研究の考え方は、倫理審査が不要な研究とはをご覧ください。
Methodsの英文テンプレート([ ]は研究計画に合わせて記入)
We performed a [two-sample / one-sample] Mendelian randomization analysis of [exposure] and [outcome], reported according to the STROBE-MR statement. Genetic variants associated with [exposure] were selected from [GWAS source, ancestry, sample size] using [P-value threshold] and [linkage disequilibrium criterion]. Summary statistics for the outcome were obtained from [source, ancestry, sample size], and the number of overlapping participants was [number / not applicable]. The core assumptions (relevance, independence and exclusion restriction) are described in the Methods. Instrument strength was assessed with the F statistic. The primary analysis used the inverse-variance weighted method with [multiplicative random effects]. MR-Egger regression and the weighted median estimator were used as sensitivity analyses that rely on different assumptions about pleiotropy, and heterogeneity was assessed with Cochran’s Q. Analyses were performed in [software and version].
ご自身の事前の解析計画に合わせて調整してください。計画が異なる場合は、そのまま使わないでください。
Resultsの英文例(第7節の教材データの数値入り)
Using 28 genetic variants (mean per-variant F statistic 28.0; 16 variants with F < 10), the inverse-variance weighted estimate was 2.83 (95% CI 1.80 to 3.87) log odds of coronary artery disease per unit increase in natural-log-transformed LDL cholesterol, equivalent to an odds ratio of 1.31 (95% CI 1.19 to 1.45) per 10% higher LDL cholesterol. Estimates from MR-Egger regression (3.25, 95% CI 1.74 to 4.76) and the weighted median method (2.68, 95% CI 1.86 to 3.50) were similar in direction and magnitude. The MR-Egger intercept was −0.011 (95% CI −0.041 to 0.018; P = 0.45). There was heterogeneity among the variant-specific estimates (Cochran’s Q = 99.5 on 27 degrees of freedom; P < 0.001).
この例文は、教材用のデータ(第7節)の数値を入れたものです。ご自身の研究の結果に、そのまま使うことはできません。
10. MRが向かない場合
MRは、問いと条件が合うときに力を発揮する方法です。次のような場合は、別の方法を検討するか、慎重な書き方が必要です。
- 曝露と強く関連する遺伝的変異が見つからない。関連性の前提を満たせません。Davey SmithとEbrahim(2003)も、調べたい曝露に適した多型がないことを、この方法の限界として挙げています。
- 変異が、他の経路でアウトカムに影響していそう。除外制約が疑わしい場合は、感度分析でも解決しないことがあります。複数の方法の結果が食い違うときは、因果的な結論は信頼できないと考えるべきです(第4節)。
- 連鎖不平衡による交絡や、発達過程での緩衝(canalization)が疑われる。これらは、Davey SmithとEbrahim(2003)が挙げた限界です。
- 知りたいのが「ある時期の介入の効果」である。MRが示すのは遺伝的に予測される曝露の差の影響で、曝露の時期や量が異なる状況に当てはまるかは別の問題です(STROBE-MRの項目16b・17)。治療や介入を受けた人と受けなかった人を比べる問いなら、傾向スコアマッチングの方法などの観察研究の方法のほうが合う場合もあります。
- 公開GWASの二標本MRだけで、新規性を示そうとしている。Stenderら(2024)の論説(著者らの意見)は、追加の裏付けのない二標本MRのみの論文は、編集者に受理しないよう勧めています。投稿先の方針を確認してください。
- 目的が、関連の記述にとどまる。通常の観察研究として、STROBE声明に沿って報告するほうが適切です。なお、GWAS、シークエンシング、発現の研究そのものは、STROBE-MRの対象外です(解説論文のTable 1)。
まとめ
- MRは、遺伝的変異を操作変数に使い、交絡や逆の因果の影響を受けにくい形で因果効果を推定する方法です。関連性・独立性・除外制約の3つの前提が必要で、後ろ2つは直接確かめられません。
- IVW、MR-Egger、加重中央値は、依拠する前提が異なります。3つを並べて、一致するか、一致しないならなぜかを書くことが、感度分析の核になります。
- 「F>10」は慣習的な目安で、10を超えても偏りは生じえます。変異ごとのFと、弱い操作変数への対応も書いてください。
- Rパッケージの同梱データ(28変異)では、3つの方法の推定値は2.68〜3.25で近く、MR-Eggerの切片はP=0.45でしたが、Cochran’s QはP<0.001で、28変異のうち16変異で変異ごとのFが10未満でした。
- 報告はSTROBE-MR(全20項目)に沿い、因果的な表現は前提つきで慎重に書きます。
関連記事
- 統計解析サービス
- 交絡因子とは|調整方法と論文での書き方・査読で問われる点
- 【完全ガイド】STROBE声明で観察研究を正しく報告する方法
- 傾向スコアマッチングの方法|キャリパー・SMDと論文の書き方
- 【多重比較補正】Bonferroni・Holm・FDRの選択と論文記述
- 感度分析とは|論文での報告方法と欠測データ・E値の実例
- 多変量解析の変数選択
よくある質問
Q. メンデルランダム化解析と、通常の観察研究は何が違いますか?
通常の観察研究は、測定した交絡因子を調整して曝露とアウトカムの関連を調べます。メンデルランダム化解析は、曝露と関連する遺伝的変異を操作変数として使い、測定していない交絡や逆の因果の影響を受けにくい形で因果効果を推定しようとする方法です(Davey SmithとEbrahim, 2003)。ただし、3つの前提(関連性、独立性、除外制約)が成り立つことが条件で、独立性と除外制約は直接確かめられません。
Q. 3つの前提は、データで確認できますか?
関連性は、F統計量などで通常の方法により検定できます。独立性と除外制約は、検証して成り立つと示すことはできませんが、測定済みの交絡因子との関連の確認、MR-Egger、加重中央値、陰性対照などで、成り立たない可能性を示す証拠が得られることがあります(STROBE-MRの解説論文)。
Q. F統計量は10を超えていれば、弱い操作変数の心配はありませんか?
いいえ。「F<10は弱い」は慣習的な目安で、STROBE-MRの解説論文は、10を超えても弱い操作変数バイアスは生じうること、この線引きはP=0.05の二分法に似た恣意的なものであることを述べています。Fの値に加えて、弱い操作変数に頑健な方法を使ったかどうかも書くと、読み手に親切です。
Q. IVW、MR-Egger、加重中央値のうち、主解析はどれにすべきですか?
どれか1つが常に正しい、という決まりはありません。それぞれが依拠する前提が異なるため、STROBE-MRは複数の方法の結果を比べて頑健性を評価し、報告することを求めています。主解析は結果を見る前に決め、残りは感度分析として並べ、結果が一致するか、一致しないならなぜかを書いてください。
Q. 公開されているGWAS要約統計量だけの二標本MRで、論文になりますか?
雑誌や分野によって扱いは異なり、一律の基準はありません。Stenderらは2024年の論説(著者らの意見)で、公開GWAS要約統計量だけに基づく二標本MRの論文は新たな価値が乏しいことが多いとして、追加の裏付けのない二標本MRのみの論文は受理しないよう編集者に勧めています。投稿先の方針を確認し、別のデータでの再現、生物学的な根拠、通常の観察研究の推定値との比較など、追加の裏付けを検討してください。
メンデルランダム化を含む解析の計画や、査読者からの追加解析の依頼でお困りの方へ
Editverse Japanの医学統計解析サポート(定額 79,800円)は、統計手法の選択、解析の実施、MethodsとResultsの執筆支援までを、研究者の方と一緒に進めるサービスです。メンデルランダム化解析も、医学統計解析サポートの対象です。解析の考え方のご相談から、Methods・Resultsの執筆支援まで、研究者の方と一緒に進めます。採択まで追加料金なしでサポートを継続します(採択をお約束するものではなく、採否はジャーナルの編集者・査読者が判断します)。最終的な内容、結果の解釈、結論、投稿の判断は著者に帰属します。
参考文献・公式情報
確認日:2026年10月11日。文献の書誌情報(著者・年・雑誌・PMID/DOI)は、PubMed(NCBI E-utilities)とCrossrefで1件ずつ照合しました。全文を読んだものと、抄録のみを確認したものを区別して示します。
PubMed収載の文献
- [文献1]Davey Smith G, Ebrahim S. 'Mendelian randomization': can genetic epidemiology contribute to understanding environmental determinants of disease? Int J Epidemiol. 2003;32(1):1-22. doi:10.1093/ije/dyg070. PMID: 12689998(抄録を確認)。
- [文献2]Lawlor DA, Harbord RM, Sterne JAC, Timpson N, Davey Smith G. Mendelian randomization: using genes as instruments for making causal inferences in epidemiology. Stat Med. 2008;27(8):1133-1163. doi:10.1002/sim.3034. PMID: 17886233(書誌情報と抄録を確認。さらに学ぶための文献として掲載)。
- [文献3]Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665. doi:10.1002/gepi.21758. PMID: 24114802(抄録を確認)。
- [文献4]Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525. doi:10.1093/ije/dyv080. PMID: 26050253(抄録を確認)。
- [文献5]Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314. doi:10.1002/gepi.21965. PMID: 27061298(抄録を確認。本文では2016a)。
- [文献6]Burgess S, Thompson SG. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764. doi:10.1093/ije/dyr036. PMID: 21414999(抄録を確認)。
- [文献7]Burgess S, Davies NM, Thompson SG. Bias due to participant overlap in two-sample Mendelian randomization. Genet Epidemiol. 2016;40(7):597-608. doi:10.1002/gepi.21998. PMID: 27625185(抄録を確認)。
- [文献8]Skrivankova VW, Richmond RC, Woolf BAR, et al. Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization: The STROBE-MR Statement. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID: 34698778(抄録を確認。項目の内容は、全文を読んだ解説論文(文献9)で確認)。
- [文献9]Skrivankova VW, Richmond RC, Woolf BAR, et al. Strengthening the reporting of observational studies in epidemiology using mendelian randomisation (STROBE-MR): explanation and elaboration. BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233. PMID: 34702754(全文(PMC8546498、CC BY 4.0)を確認。項目見出し・用語集・Box 3を参照)。
- [文献10]Burgess S, Davey Smith G, Davies NM, et al. Guidelines for performing Mendelian randomization investigations: update for summer 2023. Wellcome Open Res. 4:186(改訂第3版、2023年8月4日公開)。 doi:10.12688/wellcomeopenres.15555.3. PMID: 32760811(全文(PMC7384151、CC BY 4.0)を確認。一標本・二標本の記述を参照)。
- [文献11]Davies NM, Holmes MV, Davey Smith G. Reading Mendelian randomisation studies: a guide, glossary, and checklist for clinicians. BMJ. 2018;362:k601. doi:10.1136/bmj.k601. PMID: 30002074(抄録を確認)。
- [文献12]Stender S, Gellert-Kristensen H, Davey Smith G. Reclaiming mendelian randomization from the deluge of papers and misleading findings. Lipids Health Dis. 2024;23(1):286. doi:10.1186/s12944-024-02284-w. PMID: 39244551(論説(Letter)。全文(PMC11380209)を確認。著者らの意見として引用)。
- [文献13]Waterworth DM, Ricketts SL, Song K, et al. Genetic variants influencing circulating lipid levels and risk of coronary artery disease. Arterioscler Thromb Vasc Biol. 2010;30(11):2264-2276. doi:10.1161/ATVBAHA.109.201020. PMID: 20864672(全文(PMC3891568)で、脂質の自然対数変換と28変異(表1)を確認。第7節の同梱データの出典)。
- [文献15]Bowden J, Del Greco M F, Minelli C, Davey Smith G, Sheehan NA, Thompson JR. Assessing the suitability of summary data for two-sample Mendelian randomization analyses using MR-Egger regression: the role of the I2 statistic. Int J Epidemiol. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220. PMID: 27616674(抄録を確認。本文では2016b。I²GXの定義と、NOME違反による希釈の記述を、PMC5446088の全文で確認)。
- [文献14]Hemani G, Zheng J, Elsworth B, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408. doi:10.7554/eLife.34408. PMID: 29846171(抄録を確認)。
公式情報・そのほかの資料
- [資料16]STROBE-MR公式サイト https://www.strobe-mr.org/(チェックリスト全20項目、通常版・記入可能版・Word版。2026年10月11日確認)。
- [資料17]EQUATOR Network「STROBE-MR」 https://www.equator-network.org/reporting-guidelines/strobe-mr/(2026年10月11日確認。声明の全文はJAMAのサイト、解説論文はBMJのサイトで公開されていると案内されています)。
- [資料18]Rパッケージ MendelianRandomization 0.10.0(Burgess S, Yavorska O)CRAN。同梱データ
ldlcのヘルプページ(出典はWaterworthら, 2010)を、本記事で使用したRセッション(R 4.3.3)で確認。 - [資料19]PubMed検索(NCBI E-utilities esearch):https://pubmed.ncbi.nlm.nih.gov/。検索式 ("Mendelian randomization"[tiab] OR "Mendelian randomisation"[tiab]) AND 各年[dp]。2026年10月11日取得(図1)。