感度分析とは|論文での報告方法と欠測データ・E値の実例
論文でいう感度分析(sensitivity analysis)とは、前提や解析の選び方を妥当な範囲で変えて同じ解析をやり直し、結論が変わるかどうかを確かめることです。欠測データの扱い、外れ値を残すかどうか、どの対象者を解析するか、未測定の交絡がどれほど強ければ結果が覆るか、といった選択に対して、主解析の結果がどれだけ頑健(robust)かを示します。本記事で扱うのはこの意味の感度分析です。検査の「感度」(感度・特異度の感度、真陽性率)とは別の概念で、そちらはROC曲線とAUCの見方で解説しています。以下では、実データ(survival::lung、228例、死亡165例)のCox回帰を6通りに解析します。ECOG performance status 1点あたりのハザード比は1.58から1.86の範囲に収まり、どの95%信頼区間も1を下回りませんでした。続いてE値を計算し、論文にそのまま使える記載例も示します。
1. 感度分析とは何か、何ではないか
Thabaneら(2013)[1]は、感度分析を、解析方法、アウトカムの定義、プロトコール逸脱、欠測データ、外れ値といった重要な前提や変動が、研究全体の結論に与える影響を評価する方法と説明しています。問いは常に同じです。「別の、しかし妥当な選択をしていたら、結論は変わっただろうか」。
| 疑問の出どころ | 代表的な感度分析 | 本記事での扱い |
|---|---|---|
| 欠測データ | 完全ケース解析と多重代入法の比較。「欠測値のほうが悪い値だったら」(デルタ調整) | 第3章 |
| 外れ値 | 外れ値を含める場合と除く場合の両方で解析(箱ひげ図の境界やz値など、事前に決めた基準で特定) | 第4章 |
| 誰を解析するか | ITT、per-protocol、as-treated(試験の場合)。早期のイベントを除くランドマーク解析 | 第4章 |
| 定義・カットオフ | 別のアウトカム定義やカットオフで解析し直す | 扱いません |
| 未測定交絡(観察データ) | E値などのバイアス解析 | 第5章 |
Thabaneら(2013)[1]から、次の3点を押さえておいてください。
- 目的は「最良の結果」を選ぶことではありません。結論は主解析に基づいて述べ、感度分析は、その結論にどれだけ自信があるかを示す材料として提示します。感度分析で主解析が頑健でないと分かった場合は、さらなる研究が必要だというサインであり、別の結論を選んでよいという意味ではありません。
- 有意水準の追加調整は不要です。感度分析は新しい仮説の検定ではなく、同じ問いの再解析だからです。
- 事前に計画します。プロトコールや統計解析計画書(SAP)に、データを解析する前に、それぞれの根拠とともに記載します。査読者の依頼などで後から追加したものは、事後的(post hoc)であることを明記してください。
なお、感度分析はサブグループ解析(効果が群ごとに違うかを調べる解析)や検出力計算とは別のものです。後者はサンプルサイズと検出力分析をご覧ください。
2. 実例の設定:進行肺がんの生存時間(survival::lung)
Rのsurvivalパッケージのlungデータは、North Central Cancer Treatment Group(Loprinziら、1994)[10]の進行肺がん患者228例のデータです(出典はRのヘルプページに記載されています)。追跡中に165例が死亡しました。年齢(age)、性別(sex)、医師が評価したECOG performance score(ph.ecog。0=無症状、1=症状はあるが完全に歩行可能、2=日中の50%未満を臥床、3=日中の50%超を臥床するが寝たきりではない)、過去6か月の体重減少(wt.loss、ポンド)、食事での摂取カロリー(meal.cal)の5つの共変量でCox回帰を行います。注目する推定値は、ECOGスコア1点あたりのハザード比(HR)です。この記事では、解析計画書がそう定めていると仮定して、欠測がランダムに起こる(MAR)という仮定の下での多重代入法を主解析とし、ほかの解析を感度分析とします。
このデータには欠測があります。
library(survival); library(mice); library(EValue)
d <- lung; d$status01 <- d$status - 1          # 1 = 死亡
colSums(is.na(d[, c("age","sex","ph.ecog","wt.loss","meal.cal")]))
#      age      sex  ph.ecog  wt.loss meal.cal
#        0        0        1       14       47
fm <- Surv(time, status01) ~ age + sex + ph.ecog + wt.loss + meal.cal
cc <- coxph(fm, data = d)
cat("complete cases:", cc$n, "of", nrow(d), " events:", cc$nevent, "of", sum(d$status01), "\n")
# complete cases: 170 of 228  events: 123 of 165
5つの共変量がすべてそろっているのは228例中170例(74.6%)だけです。完全ケース解析では、58例(25.4%)と、165例の死亡のうち42例が、気づかないうちに解析から外れます。欠測の大半はmeal.cal(47例)によるものです。最初の感度分析を欠測データにするのは、このためです。
3. 欠測データ:完全ケース解析、多重代入法、「欠測値のほうが悪かったら」
なぜ扱い方が重要なのか
Sterneら(2009)[2]は、完全ケースのみの解析はバイアスを生じ得ること、欠測は完全にランダムな欠測(MCAR)、ランダムな欠測(MAR)、ランダムでない欠測(MNAR)に分類されることを説明しています。MARだがMCARではない場合、完全ケース解析にはバイアスが生じ得ますが、多重代入法のような手法でそれを補正できます。ただし、観察されたデータだけではMARとMNARを区別できません。MNARによるバイアスに対応できるのは、欠測メカニズムについて異なる仮定を置いた場合の影響を調べる感度分析だけです[2]。Littleら(2012)[4]も臨床試験について同じ点を述べています。MARの仮定は主解析ではしばしば妥当ですが、観察データでその正しさを確かめることはできないため、感度分析が推奨されます。
Rでの多重代入法(mice)
Cox回帰の場合、White・Royston(2009)[3]は、代入モデルにイベント指標とNelson-Aalen推定による累積ハザードを含めることを勧めています。また、生存時間の対数を使うと共変量とアウトカムの関連が帰無仮説の方向に偏ることを示しています[3]。Sterneら(2009)[2]も、アウトカムを代入モデルに含める必要があること、代入データセット数は5より20以上のほうが望ましい場合があることを述べています(代入モデルの設定や代入回数の実務的な指針は、White、Royston、Wood(2011)[9]にあります)。これらに従って解析します。
d$H <- nelsonaalen(d, time, status01)                       # Nelson-Aalen累積ハザード
dd  <- d[, c("time","status01","H","age","sex","ph.ecog","wt.loss","meal.cal")]
pm  <- make.predictorMatrix(dd); pm[, "time"] <- 0          # timeそのものではなくH+イベント指標を使う
imp <- mice(dd, m = 20, method = "pmm", predictorMatrix = pm,
            maxit = 10, seed = 2026, printFlag = FALSE)
fit <- with(imp, coxph(Surv(time, status01) ~ age + sex + ph.ecog + wt.loss + meal.cal))
summary(pool(fit), conf.int = TRUE, exponentiate = TRUE)    # Rubinの規則で統合
統合結果(20回の代入、予測平均マッチング、seed 2026)は次のとおりです。
| 項目 | HR | 95%信頼区間 | p |
|---|---|---|---|
| age(1歳あたり) | 1.010 | 0.992〜1.029 | 0.28 |
| sex(女性、男性と比較) | 0.558 | 0.397〜0.782 | 0.00083 |
| ph.ecog(1点あたり) | 1.662 | 1.307〜2.113 | 0.000049 |
| wt.loss(1ポンドあたり) | 0.992 | 0.980〜1.005 | 0.24 |
| meal.cal(1カロリーあたり) | 1.000 | 1.000〜1.000 | 0.81 |
同じモデルの完全ケース解析(n = 170、死亡123例)では、ECOGのHRは1.674(95%信頼区間1.252〜2.238)でした。代入後の解析は228例すべてを使い、1.662(1.307〜2.113)となりました。推定値はほぼ同じで、区間は狭くなっています。追加された情報が実際に有用で、完全ケースが大きく偏った集団でないときに期待される結果です。
この実例についての注意点があります。ECOGスコア自体の欠測は1例だけでした。したがってECOGの推定値がほとんど動かなかったのは意外ではありません。代入の影響を受けやすいのは、14例が欠測している体重減少の係数です(完全ケースではHR 0.989、95%信頼区間0.974〜1.004、代入後は0.992、0.980〜1.005)。欠測が実際にどの係数に影響し得るのかを、常に確認してください。
デルタ調整:MNARを想定した簡単な感度分析
MARの下での代入は、観察された変数が同じなら、欠測のある人は欠測のない人と似ていると仮定します。デルタ調整は、この仮定を緩めます。制御付き多重代入法では、代入値にオフセットδを加え、観察されなかった対象者が観察された対象者よりも悪い(または良い)値だった場合の影響を評価します(Croら、2020)[5]。このチュートリアルは試験の欠測アウトカムを扱っており、ここでは同じ考え方を共変量に当てはめています(応用です)。δを段階的に大きくして解析をやり直し、結論が変わるまでにδがどれだけ必要か(「転換点」)を報告します。
体重減少が欠測している患者は、モデルの予測よりも体重が減っていたと仮定し、代入したwt.lossの値すべてに10ポンドまたは30ポンドを加えます。
post <- make.post(dd); post["wt.loss"] <- "imp[[j]][, i] <- imp[[j]][, i] + 10"   # または + 30
imp10 <- mice(dd, m = 20, method = "pmm", predictorMatrix = pm, post = post,
              maxit = 10, seed = 2026, printFlag = FALSE)
観察された体重減少の平均は9.83ポンド、代入値の平均は11.30ポンドでした。δ = +10ポンドではECOGのHRは1.637(95%信頼区間1.287〜2.082)、δ = +30ポンド(かなり極端な設定で、代入した体重減少の平均は約41.7ポンド)では1.584(1.244〜2.015)でした。結論は転換しませんでした。δの範囲の選び方は統計ではなく臨床的な判断です。範囲とその根拠を明記してください。
4. 外れ値と解析対象集団
外れ値
Thabaneら(2013)[1]は、z値や箱ひげ図で外れ値を特定し、外れ値を含めた場合と除いた場合の両方で解析することを、標準的な感度分析として挙げています。基準は事前に決めておく必要があります。ここでは、極端な値のあった2つの連続変数について、Tukeyの箱ひげ図の境界(四分位の外側に四分位範囲の1.5倍)を使います。
- wt.loss:境界は−23.6〜39.4ポンド。境界の外側は5例(60、−24、68、52、49ポンド)。
- meal.cal:境界は−137.5〜1922.5カロリー。境界の外側は5例(2600、2450、2450、2200、2350)。
該当者は合計9例でした(15行目の1例は両方の変数で境界の外側)。9例のうち8例は完全ケースに含まれていました。これらを除くとn = 162、死亡117例となり、ECOGのHRは1.692(95%信頼区間1.254〜2.283)で、含めた場合の1.674(1.252〜2.238)とほぼ同じでした。
解析対象集団:ランドマーク解析
試験では、解析対象集団の比較としてITT、per-protocol、as-treatedを比べるのが一般的です(Thabaneら、2013)[1]。このデータにはプロトコール逸脱がないので、別の集団の問いを使います。早期の死亡が結果を左右していないでしょうか。ランドマーク解析は、90日時点から追跡を始め、その時点で生存している患者だけを対象にします。228例のうち27例が90日までに死亡し、90日を超えて追跡された患者は201例で、そのうち149例が共変量の欠測なしでした。この149例(死亡102例)のモデルでは、ECOGのHRは1.856(95%信頼区間1.331〜2.589)でした。
6つの解析のなかで最も大きく動いたのがこれです(1.86に対し1.66)。区間はほかの解析と重なり、方向も結論も同じですが、数値を示さずに「変わらなかった」と書くのではなく、そのまま報告してください。
6つを並べて読む
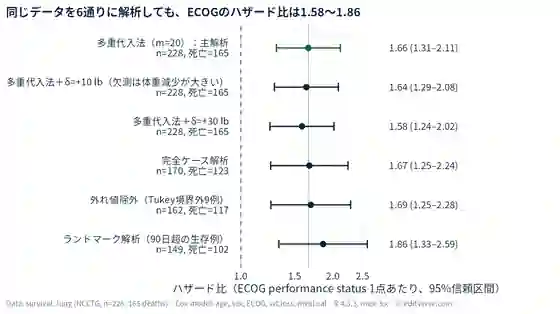
図1の読み方:6つの推定値はいずれも1.58〜1.86の間にあり、どの区間も1に達していません。「ECOGスコアが高いほど死亡のハザードが高い」という結論は、欠測データ、外れ値、早期死亡の扱い方に左右されませんでした。ここでいう頑健とはこの意味です。モデルが正しいかどうかや、交絡については何も示していません。交絡は次の章で扱います。
5. 未測定の交絡:E値
ここまでは測定されたデータに関する話でした。観察研究では、測定していない交絡因子が存在する可能性もあります。測定した交絡因子の調整は別の話題ですので、交絡因子の調整方法をご覧ください。ここでは繰り返しません。
VanderWeele・Ding(2017)[6]がE値を提案しました。E値は、測定された共変量で条件づけたうえで、特定の曝露とアウトカムの関連を完全に説明するために、未測定の交絡因子が曝露とアウトカムの両方との間に持たなければならない関連の強さの最小値を、リスク比の尺度で表したものです。E値が大きければ、かなり強い未測定交絡がなければ結果を説明できず、小さければ弱い未測定交絡でも説明できます。著者らは、観察された推定値と、信頼区間のうち帰無値に近いほうの限界値の両方についてE値を報告することを提案しています[6]。
リスク比RRが1より大きい場合、E値 = RR + √(RR × (RR − 1)) です。RRが1未満のときは、先に逆数をとります。同じ式は、追跡終了時にアウトカムがまれな場合のハザード比やオッズ比にも使えます。アウトカムが多い場合は、変換により近似的なE値を求めます(Mathurら、2018)[7]。今回のデータでは228例中165例(72%)が死亡しており、アウトカムは多いので、EValueパッケージの「アウトカムが多い場合」のオプションを使います。
pl <- summary(pool(fit), conf.int = TRUE, exponentiate = TRUE)   # 第3章の多重代入の統合結果
evalues.HR(est = pl$estimate[3], lo = pl$`2.5 %`[3], hi = pl$`97.5 %`[3], rare = FALSE)   # 3行目 = ph.ecog
#             point    lower    upper
# RR       1.420623 1.203843 1.674121
# E-values 2.193634 1.699217       NA
HR 1.66は近似的なRR 1.42(信頼区間の限界値は1.20)に変換されます。推定値に対するE値は2.19、信頼区間下限に対するE値は1.70です。言い換えると、測定された共変量を考慮したうえで、ECOGスコアと死亡の両方とのリスク比がそれぞれ約2.19の未測定交絡因子があれば、推定値を完全に説明できます。リスク比がどちらも1.70の交絡があれば、信頼区間の下限を1まで動かすのに十分な場合があります。それより弱い交絡では説明できません。
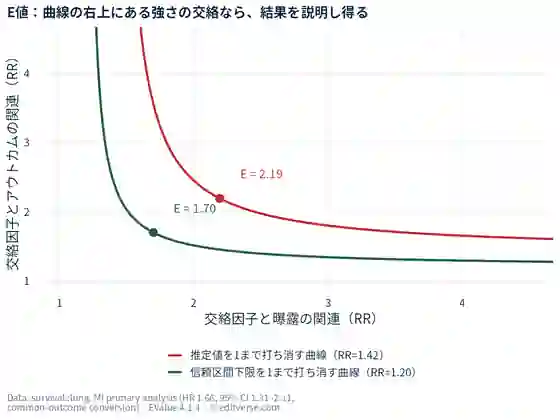
図2の読み方:曲線の右上の領域にあたる強さの交絡だけが、結果を説明し得ます。2.19が「大きい」かどうかは、その分野の知識に基づく判断です。非公式な目安として、測定された共変量と比べてみる方法があります。同じ代入モデルでsexのHRは0.558で、逆方向に換算すると1.79に相当します(方向づけのための大まかな比較です。ハザード比とE値のリスク比は同じ量ではありません)。
正直に述べておくべき限界が2つあります。第一に、E値は検定ではなく、交絡がないことの証明でもありません。どれほどの交絡が必要かを数値にするものです。第二に、この実例の「曝露」は患者の特性(全身状態)であり、治療ではありません。計算の仕組みを示すための例であり、ECOGスコアについて因果関係を主張するものではありません。VanderWeele・Ding(2017)[6]は、因果的なエビデンスを得ることを目的とする観察研究でE値を報告することを提案しています。EValueパッケージとウェブ計算機は、Mathurら(2018)[7]で紹介されています。
6. 論文での感度分析の報告方法
報告ガイドラインが求めること
- STROBE(観察研究)は、欠測データへの対処を説明すること(項目12c)、感度分析を記載すること(項目12e)、注目する変数ごとの欠測のある参加者数を示すこと(項目14b)を求めています(Vandenbrouckeら、2007)[8]。
- Sterneら(2009、Box 2)[2]は、欠測の影響を受け得るあらゆる解析で報告すべき事項を挙げています。変数ごとの欠測数、理由と欠測のために除外された人数、完全例と不完全例の違い、用いた方法とその仮定(例:MAR)、多重代入法ではソフトウェアと設定・代入データセット数・代入モデルに含めた変数・非正規分布やカテゴリ変数の扱い、比較のための完全ケースの結果(異なる場合はその説明)、可能であればMNARからの逸脱に対する頑健性です。
- 感度分析は、特に結果が異なる場合には、すべて報告します。結果が変わらない場合は、簡潔な記述で足りることがあります(Thabaneら、2013)[1]。
Methodsの記載例(英文テンプレート)
“The primary analysis used multiple imputation by chained equations (predictive mean matching, 20 imputed datasets, R package mice 3.16.0) under a missing-at-random assumption. The imputation model included the covariates, the event indicator and the Nelson-Aalen estimate of the cumulative hazard; estimates were pooled using Rubin’s rules. Pre-specified sensitivity analyses were (1) a complete-case analysis, (2) delta-adjusted imputation adding 10 and 30 lb to imputed weight loss, (3) exclusion of observations outside Tukey’s boxplot fences for weight loss and calorie intake, and (4) a landmark analysis at day 90. The E-value was calculated for the primary hazard ratio and its confidence limit nearest the null (R package EValue 4.1.4; common-outcome approximation).”
Resultsの記載例(実際の数値)
“Of 228 patients, 58 (25.4%) had missing data on at least one covariate (ECOG score 1, weight loss 14, calorie intake 47). The hazard ratio per 1-point ECOG score was 1.66 (95% CI 1.31 to 2.11) in the primary analysis. It was 1.67 (1.25 to 2.24) in complete cases, 1.64 (1.29 to 2.08) and 1.58 (1.24 to 2.02) with delta adjustments of +10 and +30 lb, 1.69 (1.25 to 2.28) after excluding 9 patients outside the boxplot fences, and 1.86 (1.33 to 2.59) in the day-90 landmark analysis. The E-value was 2.19 for the estimate and 1.70 for the lower confidence limit.”
6つの推定値は、補足表または図1のようなフォレストプロットにまとめ、結果が一致している場合は本文では1〜2文にとどめます。
結果が食い違ったとき
差を報告し、考えられる理由(例えば、完全ケースが別の集団になっていた、てこ比の大きい外れ値があった、など)を述べ、結論は事前に定めた主解析のものとします。Thabaneら(2013)[1]は、感度分析を使って別の結論を選ぶことはできないと明確に述べています。
7. よくある誤り
- 多数の解析を行い、好ましい結果だけを報告する。主解析と感度分析は事前に定めます。
- 単一代入(平均値の補完やLOCF)を「多重代入法」と書く。単一代入では標準誤差が小さくなりすぎるのが通常です(Sterneら、2009)[2]。
- アウトカムを代入モデルに含めない。アウトカムには欠測している説明変数についての情報があるため、含める必要があります(Sterneら、2009)[2]。
- 「頑健」を「正しい」と読み替える。頑健といえるのは、検討した前提に対してだけです。
- 欠測数を書かない(STROBE項目14b)。
- E値の計算方法を書かない(アウトカムの種類、まれか多いか、どの推定値か)。
- 感度分析を新しい知見として扱う。
査読者から指摘されやすい統計上の問題は、統計エラー10選と査読で統計を指摘されたらもご覧ください。
感度分析の計画や、査読者から求められた再解析でお困りの場合
Editverse Japanの医学統計解析サポート(定額79,800円)では、統計手法の選択、解析、MethodsとResultsの記載のご相談に対応し、解析コードと結果レポートをお渡しします。採択まで追加料金なしでサポートを継続します。研究デザイン、結果の解釈、結論は著者の皆様が決めるもの(ICMJEの基準)であり、採否はジャーナルが判断します。
査読者から再解析(たとえば「欠測データの扱いを変えてください」「外れ値を除いた結果も示してください」)を求められている場合は、査読対応・統計再解析(定額98,000円)をご覧ください。
まとめ
- 感度分析は、妥当な前提を変えて主解析をやり直し、結論が保たれるかを示すものです。事前に計画し、すべて報告し、好ましい答えを選ぶために使うことはしません。
- survival::lungでは228例中58例(25.4%)で共変量が欠測していました。ECOGのハザード比は多重代入法で1.66(95%信頼区間1.31〜2.11)、6通りの解析では1.58〜1.86で、どの区間も1に達しませんでした。
- MARはデータから検証できません。デルタ調整は、その仮定からの逸脱を調べる簡単な方法のひとつです。
- E値(今回は推定値で2.19、下限で1.70)は、未測定交絡がどれほど強ければ結果を説明できるかを示す数値で、交絡がないことの証明ではありません。
- 論文では、欠測データの扱い方を述べ、欠測数を示し、すべての感度分析に名前をつけて、すべて報告します。
公費・研究費でのお支払い
見積書・納品書・請求書の発行に対応しています。詳細は公費・研究費でのお支払いをご覧ください。ご相談・お見積もりはお問い合わせからどうぞ。
関連記事
- ROC曲線とAUCの見方|カットオフ値の決め方と論文の書き方(診断の感度・特異度)
- 交絡因子の調整方法
- 【完全ガイド】STROBE声明で観察研究を正しく報告する方法
- 【統計エラー10選】査読で指摘される前に確認すべき統計的問題
- 査読で統計を指摘されたら|よくある7つの指摘と回答のしかた
- ハブ:統計解析サービス
よくある質問
Q1. 「感度分析」と、検査の「感度」はどう違いますか。
別のものです。診断検査の感度は、その状態にある人のうち検査が検出できる割合で、特異度と合わせて報告します(ROC曲線の記事をご覧ください)。感度分析は、前提を変えて解析をやり直し、結果の頑健性を確かめる手法です。本記事は後者を扱っています。
Q2. 感度分析のためにP値や有意水準を補正する必要はありますか。
必要ありません。Thabaneら(2013)[1]は、感度分析は同じ問いの再解析であり、有意水準の基準を含めてほかはすべて一定に保つことで、変化を、変更した前提によるものと判断できるようにする、と述べています。
Q3. 感度分析の結果はすべて報告する必要がありますか。
はい。特に主解析と結果が異なる場合は必要です。結果が変わらなければ、簡潔な記述で足りることがあります(Thabaneら、2013)[1]。
Q4. 結果を見たあとで、たとえば査読者の依頼で感度分析を追加してもよいですか。
プロトコールや解析計画書で事前に定めておくことが望ましいとされています。後から必要になるものもあり、その場合も一つひとつに明確な根拠が必要です(Thabaneら、2013)[1]。事後的(post hoc)であることを明記し、主解析の結論を置き換えるために使うことはしません。
Q5. 代入データセットはいくつ作ればよいですか。
理論的には5つで十分とされてきましたが、代入に伴う標本変動を減らすには20以上が望ましい場合があります(Sterneら、2009)[2]。使用した数を報告してください。
Q6. E値が2であれば大きいといえますか。
普遍的な基準はありません。E値が大きければ推定値を説明するのにかなり強い未測定交絡が必要であり、小さければ弱い交絡でも足ります(VanderWeele・Ding、2017)[6]。その分野で考えられる交絡因子についての知識に照らして判断してください。
参考資料
- [1] Thabane L, Mbuagbaw L, Zhang S, et al. A tutorial on sensitivity analyses in clinical trials: the what, why, when and how. BMC Med Res Methodol. 2013;13:92. doi:10.1186/1471-2288-13-92. PMID: 23855337
- [2] Sterne JA, White IR, Carlin JB, et al. Multiple imputation for missing data in epidemiological and clinical research: potential and pitfalls. BMJ. 2009;338:b2393. doi:10.1136/bmj.b2393. PMID: 19564179
- [3] White IR, Royston P. Imputing missing covariate values for the Cox model. Stat Med. 2009;28(15):1982-1998. doi:10.1002/sim.3618. PMID: 19452569
- [4] Little RJ, D’Agostino R, Cohen ML, et al. The prevention and treatment of missing data in clinical trials. N Engl J Med. 2012;367(14):1355-1360. doi:10.1056/NEJMsr1203730. PMID: 23034025
- [5] Cro S, Morris TP, Kenward MG, Carpenter JR. Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: a practical guide. Stat Med. 2020;39(21):2815-2842. doi:10.1002/sim.8569. PMID: 32419182
- [6] VanderWeele TJ, Ding P. Sensitivity analysis in observational research: introducing the E-value. Ann Intern Med. 2017;167(4):268-274. doi:10.7326/M16-2607. PMID: 28693043(本記事ではアブストラクトの内容とMathurら[7]の記述に基づいています)
- [7] Mathur MB, Ding P, Riddell CA, VanderWeele TJ. Website and R package for computing E-values. Epidemiology. 2018;29(5):e45-e47. doi:10.1097/EDE.0000000000000864. PMID: 29912013
- [8] Vandenbroucke JP, von Elm E, Altman DG, et al. Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): explanation and elaboration. PLoS Med. 2007;4(10):e297. doi:10.1371/journal.pmed.0040297. PMID: 17941715
- [9] White IR, Royston P, Wood AM. Multiple imputation using chained equations: issues and guidance for practice. Stat Med. 2011;30(4):377-399. doi:10.1002/sim.4067. PMID: 21225900
- [10] Loprinzi CL, Laurie JA, Wieand HS, et al. Prospective evaluation of prognostic variables from patient-completed questionnaires. North Central Cancer Treatment Group. J Clin Oncol. 1994;12(3):601-607. doi:10.1200/JCO.1994.12.3.601. PMID: 8120560(Rのlungデータのヘルプページに記載されたデータの出典)
- [11] R Core Team. R 4.3.3。survivalパッケージ(lungデータ)、mice 3.16.0(
mice、make.post、nelsonaalen、pool)、EValue 4.1.4(evalues.HR)。