多変量解析の説明変数の選び方|変数選択と過剰適合を避ける
多変量解析の説明変数は、データを見る前に、研究の目的と臨床・因果の知識から決めるのが基本です。単変量P<0.05での絞り込みやステップワイズ法は、係数の過大推定や選ばれる変数の不安定さを招きやすく、避けることが勧められています[文献1〜4]。
この記事の範囲について
本記事は「どの変数を、何個、どんな根拠で入れるか」と、その書き方を扱います。回帰分析の種類の選び方は回帰分析の種類と選び方、交絡因子の調整の考え方は観察研究の交絡調整、ロジスティック回帰の結果の書き方はロジスティック回帰とオッズ比の報告をご覧ください。ここでは、それらと重ならないよう、変数の候補を絞る段階に焦点を当てます。
この記事でわかること
- 説明変数の選び方が、研究の目的(説明か予測か)で変わること
- 交絡因子・媒介因子・合流点の違いと、DAG(因果ダイアグラム)の使いどころ
- 単変量P<0.05での絞り込みやステップワイズ法が、なぜ問題とされるのか
- EPV(事象数/変数)の目安と、その限界
- 共線性(VIF)の見方、変数を何個入れられるか
- Rの実データで、選び方を変えるとオッズ比がどう動くか(フォレストプロットとブートストラップ)
- MethodsとResultsに書くこと、査読者に聞かれやすい点
入れる変数の数は、アウトカムの発生数(事象数)に見合うよう絞り、共線性は分散拡大係数(VIF)と係数の動きで確認し、選び方をMethodsに書いておきます。本記事では、Rの公開データ(Pima)で、選び方を変えるとBMIのオッズ比がどれだけ動くかを実際に確かめます。
1. 最初に決める:説明か、予測か
変数の選び方は、まず研究の目的で変わります。Heinze らは、変数選択の方法を、目的が「説明(ある因子の影響を調整して推定する)」か「予測(リスクを予測するモデルを作る)」かで分けて整理しています[文献1]。
| 目的 | 変数の決め方の中心 | 主な報告ガイドライン |
|---|---|---|
| 説明(曝露と結果の関連を、交絡を調整して推定する) | 臨床・因果の知識で、調整する変数を決める。曝露の係数が主役で、他の係数は主役ではない | STROBE[文献12] |
| 予測(リスクスコア、予後モデルなど) | 予測性能と、別のデータでの検証が中心。事象数に見合う候補の数が重要 | TRIPOD[文献13]、AIを使う場合はTRIPOD+AI[文献14] |
本記事は主に、前者(説明)を想定しています。予測モデルの作成は、サンプルサイズの考え方も含めて別の論点が多いため、第4節で触れるにとどめます。
2. 変数の「役割」を考える:交絡因子・媒介因子・合流点
調整する変数は、「関連がありそうだから」ではなく、曝露とアウトカムの間での役割で決めます。VanderWeele は、調整すべき変数の基本を、曝露またはアウトカムの原因になっている変数であると整理しています。一方、合流点(曝露とアウトカムの両方から影響を受ける変数)を調整すると、本来なかった関連が生じることがあります[文献9]。
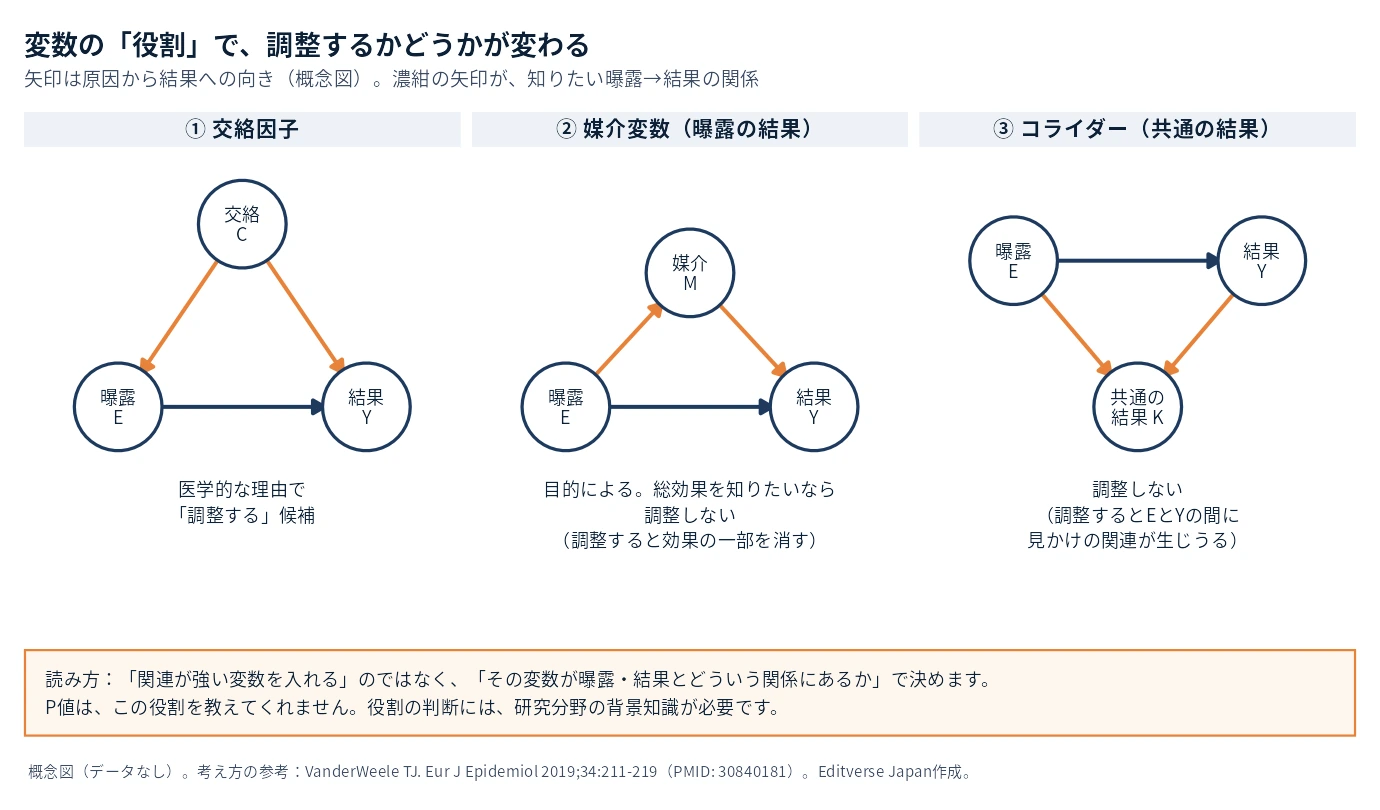
出典:VanderWeele TJ. Eur J Epidemiol 2019;34:211-219(PMID 30840181)の考え方をもとに、Editverse Japanが作図。
読み方:「関連が強い変数を入れる」のではなく、「その変数が曝露・結果とどういう関係にあるか」で調整するかどうかを決めます。P値は、この役割を教えてくれません。役割の判断には、研究分野の背景知識が必要です。 © editverse.com
この図は、データを含まない概念図です。実際の研究では、どの矢印が成り立つかは臨床の知識で決めます。特に次の2点は、統計だけでは決められません[文献9]。
- 交絡因子と媒介因子の区別。どちらも、データ上は「曝露ともアウトカムとも関連する変数」に見えます。媒介因子(曝露の結果として変わり、アウトカムに影響する変数)を調整すると、曝露の影響の一部を消してしまいます。
- 時間の前後。横断研究では、どちらが先かがデータからは分かりません。
もう一つの注意として、1つのモデルに入れた変数の係数を、すべて同じ意味で解釈してはいけません。曝露の係数のために選んだ調整変数の係数を、そのまま「その変数の効果」と読むことは、「Table 2 fallacy」として知られています[文献10]。調整変数の係数は、本来の関心事ではないことが多いため、表には曝露の推定値だけを示す方法もあります。
あわせて読みたい:観察研究の交絡調整|DAGと変数選択の考え方
3. 単変量P<0.05での絞り込みと、ステップワイズ法が問題になる理由
「単変量解析でP<0.05だった変数だけを多変量解析に入れる」絞り込みは、臨床論文で広く使われていますが、不適切であるとする指摘があり[文献2]、Heinze らも一般に避けるべきだとし、先行知識から候補変数の一覧を先に作ることを勧めています[文献1]。理由と、候補の決め方は、観察研究の交絡調整の第4節で詳しく扱っていますので、ここでは繰り返しません。
ステップワイズ法(P値やAICで自動的に変数を足し引きする方法)にも、次の問題が指摘されています。
- 係数が過大に推定されやすい。Steyerberg らは、小さなデータで、ステップワイズ選択による回帰係数の偏り(選択バイアス)をロジスティック回帰で示しています[文献3]。
- 選ばれる変数が不安定。Austin と Tu は、29個の候補変数から、ブートストラップ1,000回で940通りの異なるモデルが選ばれ、半数以上の変数が、半数未満のサンプルでしか選ばれなかったと報告しています[文献4]。
- 選ぶ過程の不確かさが、区間に反映されない。最終モデルの信頼区間は、「どの変数を残すか」を選んだ不確かさを含まずに計算されます(第6節で実例を示します)。
どうしても変数選択を行う場合、Heinze らは、通常のP<0.05よりも緩い基準(AICに相当する基準、P値で約0.157)を使うことや、ブートストラップで各変数が選ばれた割合を確認することを勧めています[文献1]。ステップワイズ法が一律に禁止されているわけではありませんが、使う場合は、探索的な位置づけであること、限界を結果とともに書いておくことが望ましいでしょう。
4. 何個まで入れられるか:EPVの目安と限界
EPV(events per variable)は、アウトカムの発生数を、モデルの候補変数の数で割った値です。「EPV 10以上」という目安の由来と、ロジスティック回帰での考え方は、ロジスティック回帰とオッズ比の報告の第6節で扱っていますので、ここでは、目安の限界と数え方に絞ります[文献5、6]。
- 目安は絶対的な基準ではありません。EPV 10は条件によっては保守的すぎる一方[文献6]、Cox回帰では、頻度の低い二値の変数を多く入れる場合などで、EPV 20以上で偏りがおおむね解消したという報告もあります[文献7]。
- 予測モデルの作成では、固定のEPVではなく、過剰適合の程度(縮小係数)などから最小のサンプルサイズを求める方法が提案されています[文献8]。
数え方にも注意が必要です。Heinze らは、変数選択で数えるのは、最終的に残った変数ではなく、候補に入れたすべての変数(と、その変換)の数であると述べています[文献1]。非線形の項や交互作用項も、自由度を増やします。たとえば、事象が68件で、候補が7変数なら、EPVは約9.7です(次節の例)。
あわせて読みたい:サンプルサイズと検出力分析、Cox回帰の場合は生存時間解析(Kaplan-Meier・Cox回帰)の報告
5. 共線性:VIFの見方
説明変数どうしが強く相関していると(多重共線性)、係数の推定が不安定になり、標準誤差が大きくなります。確認にはVIF(分散拡大係数)が使われ、5以上、または10以上を問題の目安とする文献が多いものの、普遍的な合意はありません。また、VIFが小さくても問題が起きていないとは限らないため、変数を足し引きしたときの係数と標準誤差の動きも見ることが勧められています[文献11]。
実際の対処は、次のように考えます。
- 相関の高い変数が、同じ概念の別の測定(例:BMIと皮脂厚)なら、どちらか1つにする。
- 曝露の係数が主役の場合は、曝露と強く相関する変数を入れると、曝露の区間が広がることを承知しておく。
- VIFの値だけで、機械的に変数を除かない。
予測を目的とするモデルの作成や、候補を減らせない場合は、第7節の最後に述べる統計の専門家への相談も一案です。
6. 実例:選び方を変えると、BMIのオッズ比はどれだけ動くか
6-1. データと設問
Rの MASS パッケージに入っているPimaのデータを使います。アリゾナ州のピマ族の21歳以上の女性で、WHOの基準で糖尿病かどうかが判定されています。Pima.tr(200名、糖尿病68名)とPima.te(別の332名、糖尿病109名)は、同じ集団から無作為に分けられた2つのデータです[文献16]。欠測のある症例は、あらかじめ除かれています(MASSのヘルプによる)。ここでは、「BMIが5 kg/m2高いと、糖尿病のオッズ比はいくつか」を、変数の選び方を変えながら推定します。この例は、手順の違いを見るための教材であり、糖尿病の因果関係を主張するものではありません。
候補は7変数(BMI、妊娠歴、血糖、拡張期血圧、皮脂厚、家系指標、年齢)です。家系指標は、MASS のヘルプでは「diabetes pedigree function」と呼ばれる指標です(算出方法は、本記事では確認していません)。
6-2. 変数の役割を、データを見る前に決める
次の表は、データを見る前に、第2節の考え方で決めた、本記事の仮定です(専門家の間で一致した因果構造ではなく、例示のための想定です)。
| 変数 | 扱い | 理由(本記事の想定) |
|---|---|---|
| 年齢、家系指標 | 主解析で調整 | BMIにもアウトカムにも先行しうる(交絡因子の候補) |
| 妊娠歴、皮脂厚 | 感度分析で追加 | 妊娠歴は年齢と関連する。皮脂厚はBMIと同じ「体格」の別の測定で、共線性が出やすい |
| 血糖(OGTT) | 入れない | 糖尿病の診断基準が血糖値に基づく(WHO基準[文献15])ため、アウトカムの定義そのものに近い |
| 拡張期血圧 | 入れない | BMIの結果として変わる可能性があり、媒介因子の候補 |
6-3. Rのコード
library(MASS); library(car)
d <- Pima.tr
d$y    <- as.integer(d$type == "Yes")
d$bmi5 <- d$bmi / 5                      # BMI 5 kg/m2 あたり
or <- function(m) round(exp(c(coef(m)["bmi5"], confint.default(m)["bmi5", ])), 2)

m_pre  <- glm(y ~ bmi5 + age + ped, data = d, family = binomial)    # 事前指定
m_full <- glm(y ~ bmi5 + npreg + glu + bp + skin + ped + age,
              data = d, family = binomial)                           # 全変数
m_aic  <- step(m_full, trace = 0)                                    # 後退ステップワイズ(AIC)
sapply(list(事前指定 = m_pre, 全変数 = m_full, AIC = m_aic), or)
vif(m_full)

# ブートストラップ:各変数が選ばれた割合
# set.seed は1回だけ。Pima.tr、Pima.teの順に、同じセッションで実行
set.seed(20261011)
sel <- replicate(1000, {
  b  <- d[sample(nrow(d), replace = TRUE), ]
  fb <- glm(formula(m_full), data = b, family = binomial)
  names(coef(step(fb, trace = 0)))[-1]
})Pima.teには、d <- Pima.te に置き換えて同じ手順を実行しています(乱数の種は続けて使います)。環境:R 4.3.3、MASS 7.3-60.0.1、car 3.1.2。信頼区間はWald法です。
6-4. 結果1:BMIのオッズ比は、選び方でどれだけ動いたか
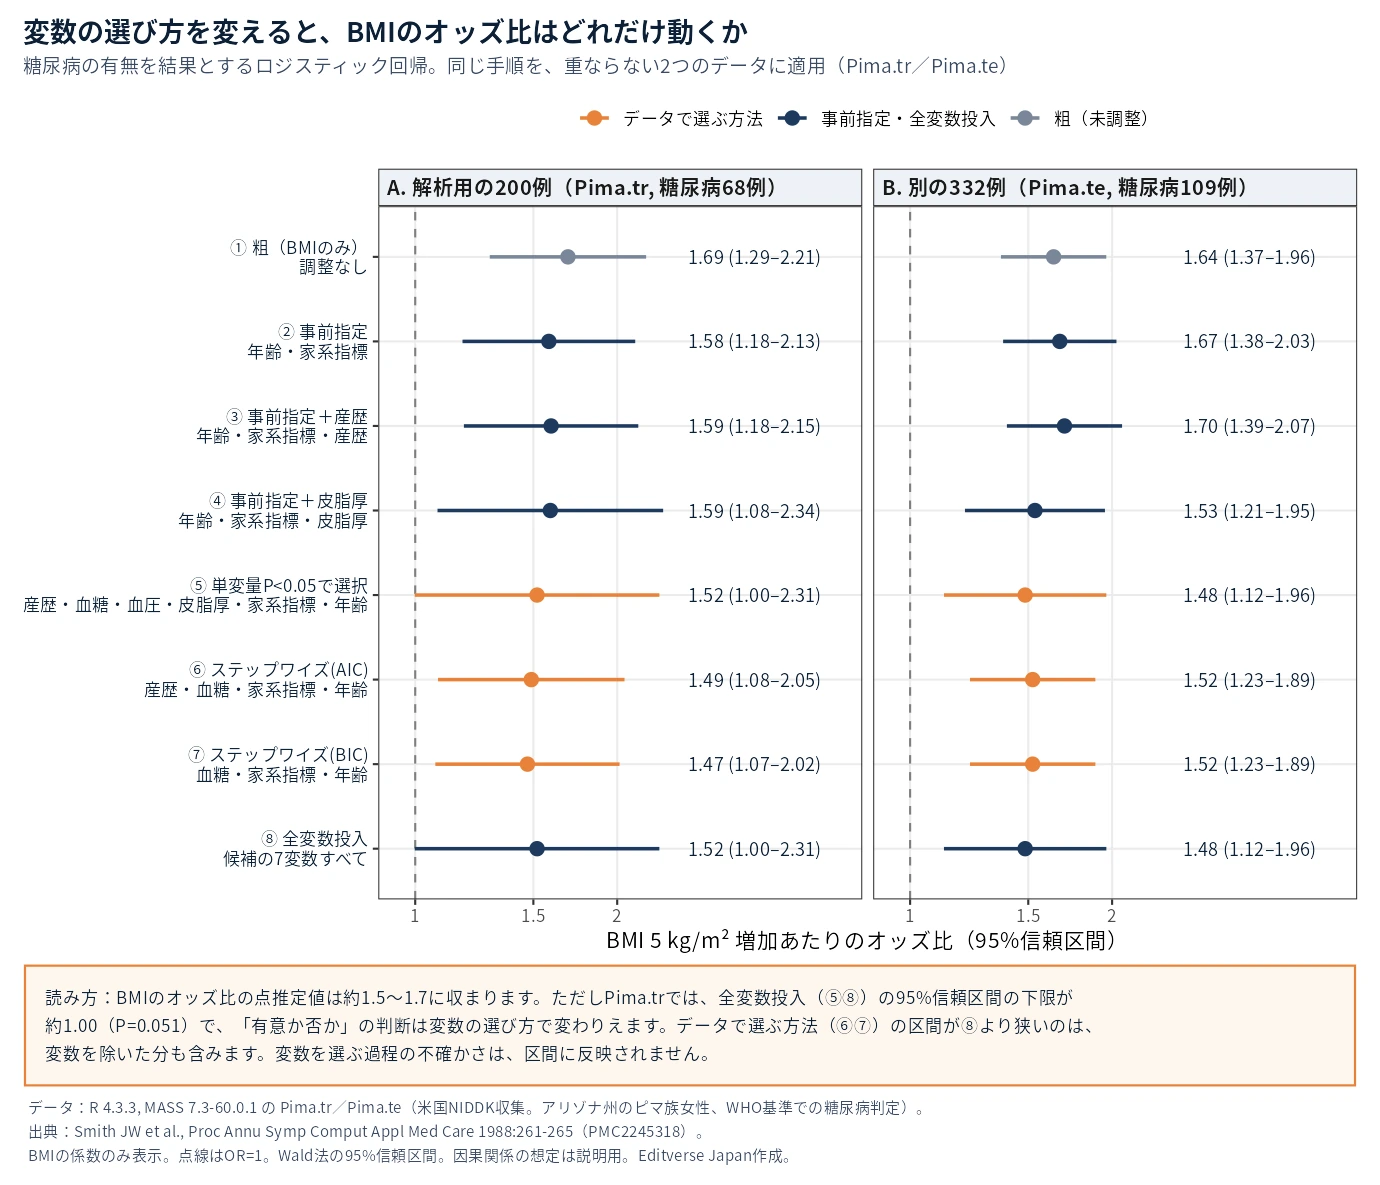
データ・出典:MASS::Pima.tr(n=200)、Pima.te(n=332)、アウトカムは糖尿病。Smith JW et al. 1988(PMC2245318)。R 4.3.3・MASS 7.3-60.0.1、Wald法の95%信頼区間。Editverse Japan作成。
読み方:BMIのオッズ比の点推定値は約1.5〜1.7に収まります。ただしPima.trでは、全変数投入(⑤⑧)の95%信頼区間の下限が約1.00(P=0.051)で、「有意か否か」の判断は変数の選び方で変わりえます。データで選ぶ方法(⑥⑦)の区間が⑧より狭いのは、変数を除いた分も含みます。変数を選ぶ過程の不確かさは、区間に反映されません。 © editverse.com
| 変数の選び方 | Pima.tr(200名) | Pima.te(332名) |
|---|---|---|
| 粗(BMIのみ、調整なし) | 1.69(1.29〜2.21) | 1.64(1.37〜1.96) |
| 事前指定(年齢+家系指標) | 1.58(1.18〜2.13) | 1.67(1.38〜2.03) |
| 事前指定+妊娠歴 | 1.59(1.18〜2.15) | 1.70(1.39〜2.07) |
| 事前指定+皮脂厚 | 1.59(1.08〜2.34) | 1.53(1.21〜1.95) |
| 単変量P<0.05で選択(結果的に全変数) | 1.52(1.00〜2.31) | 1.48(1.12〜1.96) |
| ステップワイズ(AIC) | 1.49(1.08〜2.05) | 1.52(1.23〜1.89) |
| ステップワイズ(BIC) | 1.47(1.07〜2.02) | 1.52(1.23〜1.89) |
| 全変数投入 | 1.52(1.00〜2.31) | 1.48(1.12〜1.96) |
オッズ比はBMI 5 kg/m2あたり、括弧内は95%信頼区間です。
この例から、次のことが読み取れます。
- BMIのオッズ比の点推定値は、約1.5〜1.7に収まった。ただしPima.trでは、全変数投入(単変量P<0.05での絞り込みも同じ結果)の95%信頼区間の下限が0.998(P=0.051)で、「有意か否か」の判断は変数の選び方で変わりえます。Pima.teでは、どの方法でも区間は1を含みませんでした。
- 単変量P<0.05の絞り込みは、何も除かなかった。7変数すべてが単変量でP<0.05だったため、結果は全変数投入と同じになりました。その一方で、全変数のモデルでは、拡張期血圧(P=0.80)と皮脂厚(P=0.93)は有意ではありませんでした(Pima.tr)。単変量の有意性は、多変量での寄与を教えてくれません。
- ステップワイズの区間は、全変数より狭かった。Pima.trでは、全変数の1.00〜2.31に対し、AICで1.08〜2.05です。これは、血圧と皮脂厚を除いた分でもあります。一方、どの変数を残すかを選んだ過程の不確かさは、この区間には反映されません。
- 変数を足すと区間が広がった。皮脂厚(BMIとの相関r=0.66)を加えると、Pima.trのBMIの区間は、1.18〜2.13から1.08〜2.34へ広がりました。全変数モデルのVIFは、Pima.trで最大1.76、Pima.teで最大1.93と、いずれも目安の5を大きく下回りますが、それでも区間は動きます。
6-5. 結果2:選ばれる変数は、データの揺れで入れ替わる
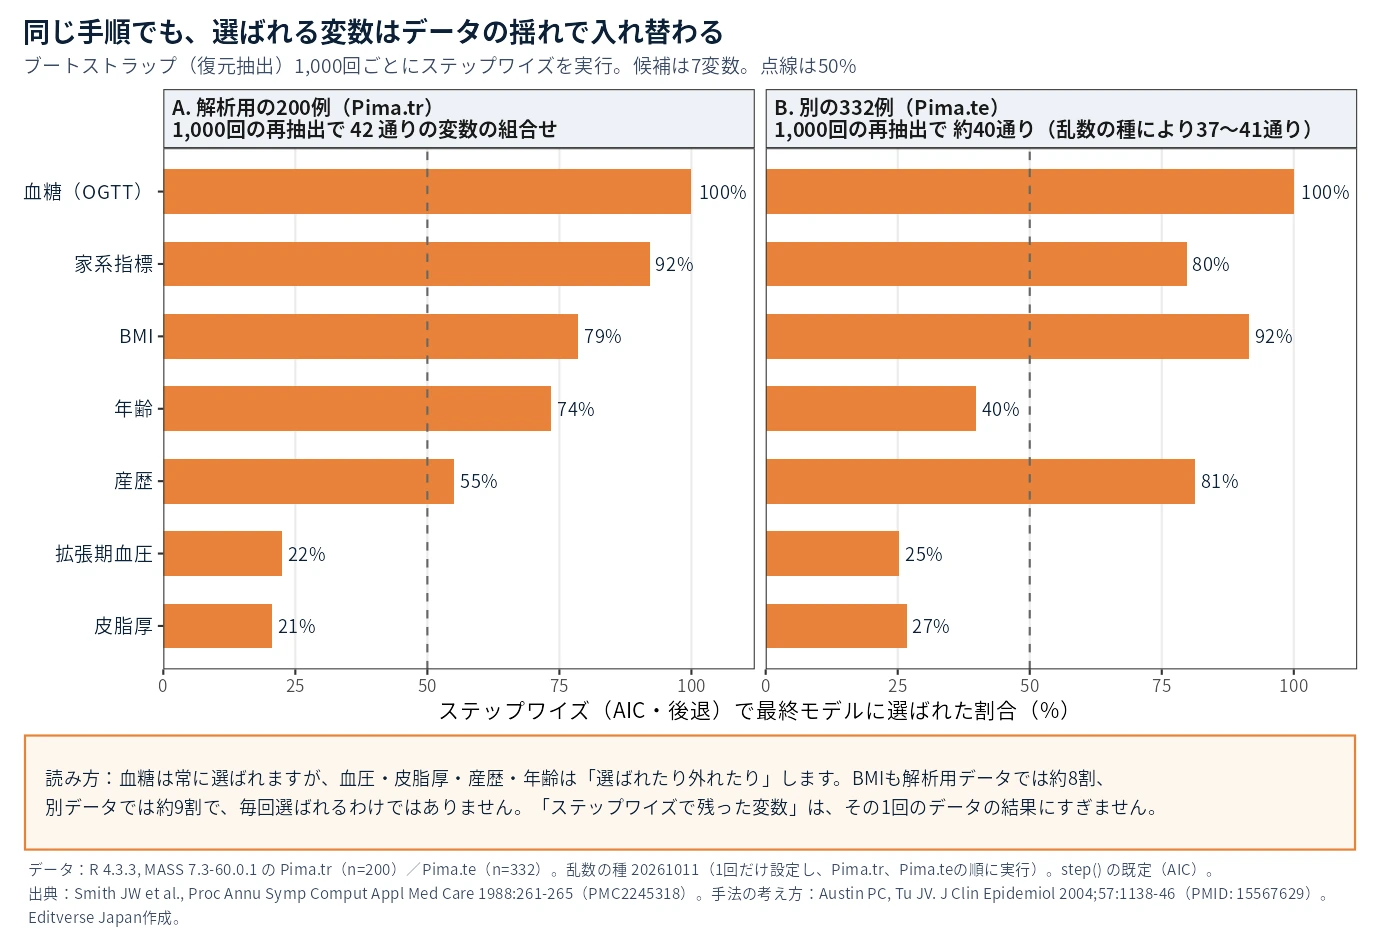
データ・出典:MASS::Pima.tr/Pima.te。乱数の種20261011(1回だけ設定し、Pima.tr、Pima.teの順に実行)。手法の考え方:Austin PC, Tu JV. J Clin Epidemiol 2004;57:1138-46(PMID 15567629)。R 4.3.3。Editverse Japan作成。
読み方:血糖は常に選ばれますが、血圧・皮脂厚・産歴・年齢は「選ばれたり外れたり」します。BMIも解析用データでは約8割、別データでは約9割で、毎回選ばれるわけではありません。「ステップワイズで残った変数」は、その1回のデータの結果にすぎません。 © editverse.com
同じ手順(AICによる後退ステップワイズ)をブートストラップ1,000回で繰り返すと、Pima.trでは42通り、Pima.teでは約40通り(乱数の種により37〜41通り)の変数の組合せが選ばれました。血糖は100%選ばれましたが、年齢は、Pima.trで74%、Pima.teでは約40%でした。妊娠歴は55%と約80%、血圧と皮脂厚は2〜3割程度でした(Pima.teの値は、乱数の種により数%動きます)。つまり、「ステップワイズで残った変数」は、そのデータでの1回の結果にすぎません。Pima.trで年齢が選ばれ、Pima.teで外れたことが、その例です。
選ばれたときのBMIのオッズ比の中央値は、Pima.trで1.58(全変数モデルは1.52)、Pima.teで1.56(同1.52)と、わずかに大きめでした。選択バイアスが小さいながらも見えています[文献3]。
6-6. この例の限界
- 候補が7変数と少ない例です。変数が多いほど不安定になります(第3節の29変数の例[文献4])。EPVは、Pima.trで約9.7(68件/7変数)、Pima.teで約15.6(109件/7変数)です。
- 2つのデータは、同じ集団から無作為に分けたものです。別の集団での外的な検証ではありません。
- ブートストラップの結果は、乱数の種で少し動きます(特にPima.te)。
- 横断データで、時間の前後は分かりません。第6-2節の役割の表は、本記事の仮定です。
- 家系指標の定義、および血糖がアウトカムの定義に近いという点は、データの説明とWHO基準[文献15]からの推測です。
7. MethodsとResultsには、何を書くか
7-1. Methodsの書き方(例)
次の文例は、本記事の例に合わせたものです。ご自身の研究では、分野の慣習と、共著者・指導教員との合意に合わせて調整してください。
| 日本語 | English |
|---|---|
| 調整変数は、解析前に、先行知見と因果関係の想定(補足図S1)に基づいて選んだ。年齢と家系指標を交絡因子として調整し、拡張期血圧はBMIの影響を受けうる(媒介因子の候補)ため、主解析では調整しなかった。P値に基づく変数選択(単変量スクリーニング、ステップワイズ法)は行わなかった。モデルの変数の数は、アウトカムの発生数(68件)に照らして決めた。多重共線性は分散拡大係数(VIF)で確認した(最大1.76)。妊娠歴と皮脂厚を加えた感度分析を行った。 | Covariates were selected before the analysis, based on prior knowledge and an assumed causal diagram (Supplementary Figure S1), not on P values. Age and diabetes pedigree function were adjusted for as confounders; diastolic blood pressure was not adjusted for in the primary analysis because it may lie on the causal pathway from BMI. No P value-based selection (univariable screening or stepwise regression) was used. The number of covariates was determined with reference to the number of outcome events (n = 68). Multicollinearity was assessed with variance inflation factors (maximum 1.76). Sensitivity analyses added parity and skinfold thickness. |
7-2. Resultsの書き方
- 曝露の推定値を、粗の値と調整後の値の両方で、95%信頼区間とともに示す(例:粗1.69、1.29〜2.21/調整後1.58、1.18〜2.13)。
- 感度分析(変数を足した場合)の結果を、1行でも書く。主な結論が変わるかどうかが、査読者の知りたい点です。
- 調整変数の係数は、曝露の係数と同じ意味では解釈しない[文献10]。
- ステップワイズ法など、データで選ぶ手順を使った場合は、それを探索的な解析として明記し、結果の不安定さを限界に書く。
あわせて読みたい:STROBE声明|観察研究の報告で書くこと
7-3. 査読者に聞かれやすいこと
| 査読者の質問 | 備えておくと良いこと |
|---|---|
| なぜこの変数を調整したのか | 役割(交絡因子か)を、先行知見とともに1文で説明できるようにする。DAGを補足図にするのも一案 |
| ステップワイズ法で選んだのか | 選んでいないと書く。選んだ場合は、探索的である旨と、ブートストラップなどでの確認 |
| 事象数に対して、変数が多くないか | EPVまたは同等の根拠。候補をどう絞ったか |
| 共線性の確認は | VIFの最大値と、変数を足し引きしたときの係数の動き |
| 調整の有無で、結論は変わるか | 粗と調整後、感度分析の結果 |
| 血圧や検査値など、結果の途中にある変数を調整していないか | 媒介因子の候補を調整した場合の影響 |
7-4. チェックリスト
- 目的(説明か予測か)を最初に決めたか
- データを見る前に、先行知識から候補変数を決めたか
- 各変数の役割(交絡因子・媒介因子・合流点)を考えたか
- 候補の数(変換・交互作用を含む)を、事象数に照らして確認したか
- 単変量P<0.05での絞り込みをしていないか
- 共線性を、VIFと係数の動きで確認したか
- 感度分析(変数を足し引きした結果)を示せるか
- 選び方を、Methodsに書いたか
解析方針は、研究の目的や分野によって異なります。最終的な判断は、研究者ご自身と共著者、指導教員で行ってください。共線性や変数の数でお悩みの場合は、研究デザインの段階で統計の専門家に相談しておくと、後からの手戻りを減らせます。
変数の選び方も含めて、解析計画からご相談いただけます
医学統計解析サポートでは、研究目的に合わせた解析計画(変数の選び方を含む)のご相談、解析コードと結果レポートの納品、MethodsとResultsの執筆サポートを、定額でご提供しています。採択まで追加料金なしでサポートを続けます(採否はジャーナルが判断します。研究デザインやデータの変更を伴う場合は、別途お見積りです)。
関連記事
統計解析サービス全体については、統計解析のページをご覧ください。
よくある質問
単変量解析でP<0.05だった変数だけを、多変量解析に入れてもよいですか。
避けることが勧められています。単変量での絞り込みは不適切とする指摘があり[文献2]、Heinzeらも、一般に避けるべきだとしています[文献1]。変数は、データを見る前に、先行知識と因果の想定から決めるのが基本です(詳しくは観察研究の交絡調整の第4節)。本記事の実例(Pima)では7変数すべてが単変量でP<0.05だったため、絞り込みは何も除かず、全変数投入と同じ結果になりました。
ステップワイズ法は、論文で使ってはいけませんか。
一律に禁止されているわけではありません。ただし、係数が過大になりやすく[文献3]、選ばれる変数がデータごとに変わりやすい[文献4]ことが知られています。使う場合は、探索的な解析であることを明記し、ブートストラップなどで選ばれる割合を確認し、限界を書くことが望ましいでしょう。
EPV(事象数/変数)10という目安は、守らなければいけませんか。
絶対的な基準ではありません。EPV 10以上では大きな問題が見られなかったというシミュレーション[文献5]が由来ですが、条件によっては保守的すぎる[文献6]、あるいは10では足りない[文献7]場合もあります。数えるのは、最終モデルではなく、候補に入れたすべての変数(変換・交互作用を含む)です[文献1]。
VIFはいくつ以下なら問題ありませんか。
5以上、または10以上を目安とする文献が多いものの、普遍的な合意はなく、VIFが小さくても問題がないとは限りません[文献11]。変数を足し引きしたときの係数と標準誤差の動きも、あわせて確認してください。
多変量解析で有意でなかった変数は、モデルから除いてよいですか。
P値だけを理由に調整変数を除くと、単変量での絞り込みやステップワイズ法と同じ問題が生じます。調整は、変数の役割(交絡因子か)で決めるのが基本です。有意でなかった変数やサブグループの結果の書き方と、査読への返答の例は、有意でなかった変数・サブグループの書き方をご覧ください。
参考文献
確認日:2026年10月11日(PubMed・CrossRefで書誌を確認し、本文の記述は、それぞれの要旨または全文で確認しました)
- Heinze G, Wallisch C, Dunkler D. Variable selection – a review and recommendations for the practicing statistician. Biom J. 2018;60(3):431-449. PMID 29292533. doi:10.1002/bimj.201700067
- Sun GW, Shook TL, Kay GL. Inappropriate use of bivariable analysis to screen risk factors for use in multivariable analysis. J Clin Epidemiol. 1996;49(8):907-916. PMID 8699212. doi:10.1016/0895-4356(96)00025-x
- Steyerberg EW, Eijkemans MJ, Habbema JD. Stepwise selection in small data sets: a simulation study of bias in logistic regression analysis. J Clin Epidemiol. 1999;52(10):935-942. PMID 10513756. doi:10.1016/s0895-4356(99)00103-1
- Austin PC, Tu JV. Automated variable selection methods for logistic regression produced unstable models for predicting acute myocardial infarction mortality. J Clin Epidemiol. 2004;57(11):1138-1146. PMID 15567629. doi:10.1016/j.jclinepi.2004.04.003
- Peduzzi P, Concato J, Kemper E, Holford TR, Feinstein AR. A simulation study of the number of events per variable in logistic regression analysis. J Clin Epidemiol. 1996;49(12):1373-1379. PMID 8970487. doi:10.1016/s0895-4356(96)00236-3
- Vittinghoff E, McCulloch CE. Relaxing the rule of ten events per variable in logistic and Cox regression. Am J Epidemiol. 2007;165(6):710-718. PMID 17182981. doi:10.1093/aje/kwk052
- Ogundimu EO, Altman DG, Collins GS. Adequate sample size for developing prediction models is not simply related to events per variable. J Clin Epidemiol. 2016;76:175-182. PMID 26964707. doi:10.1016/j.jclinepi.2016.02.031
- Riley RD, Snell KIE, Ensor J, et al. Minimum sample size for developing a multivariable prediction model: Part II – binary and time-to-event outcomes. Stat Med. 2019;38(7):1276-1296. PMID 30357870. doi:10.1002/sim.7992
- VanderWeele TJ. Principles of confounder selection. Eur J Epidemiol. 2019;34(3):211-219. PMID 30840181. doi:10.1007/s10654-019-00494-6
- Westreich D, Greenland S. The table 2 fallacy: presenting and interpreting confounder and modifier coefficients. Am J Epidemiol. 2013;177(4):292-298. PMID 23371353. doi:10.1093/aje/kws412
- Vatcheva KP, Lee M, McCormick JB, Rahbar MH. Multicollinearity in regression analyses conducted in epidemiologic studies. Epidemiology (Sunnyvale). 2016;6(2):227. PMID 27274911. doi:10.4172/2161-1165.1000227
- Vandenbroucke JP, von Elm E, Altman DG, et al. Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): explanation and elaboration. PLoS Med. 2007;4(10):e297. PMID 17941715. doi:10.1371/journal.pmed.0040297
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis (TRIPOD): the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63. PMID 25560714. doi:10.7326/M14-0697
- Collins GS, Moons KGM, Dhiman P, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385:e078378. PMID 38626948. doi:10.1136/bmj-2023-078378
- Alberti KGMM, Zimmet PZ. Definition, diagnosis and classification of diabetes mellitus and its complications. Part 1: diagnosis and classification of diabetes mellitus. Diabet Med. 1998;15(7):539-553. PMID 9686693. doi:10.1002/(SICI)1096-9136(199807)15:7<539::AID-DIA668>3.0.CO;2-S
- Smith JW, Everhart JE, Dickson WC, Knowler WC, Johannes RS. Using the ADAP learning algorithm to forecast the onset of diabetes mellitus. Proc Annu Symp Comput Appl Med Care. 1988:261-265. PMC2245318(Pima.tr/Pima.teの出典。MASSパッケージのヘルプによる)
- 解析環境:R 4.3.3、MASS 7.3-60.0.1、car 3.1.2。データ:MASS::Pima.tr(200名)、MASS::Pima.te(332名)。図とコードはEditverse Japanが作成しました。