傾向スコアマッチングの方法|キャリパー・SMDと論文の書き方
傾向スコアマッチング(propensity score matching、PSM)は、治療や曝露を受ける確率(傾向スコア)が近い人どうしを、受けた群と受けなかった群からペアにして、測定済みの背景因子がそろった比較群をつくる方法です。論文では、4つの点を報告できる必要があります。傾向スコアのモデルにどの共変量を入れたか、マッチングをどう行ったか(アルゴリズム、キャリパー、復元抽出の有無)、バランスが取れたか(標準化差、SMDが0.1未満を目安とする)、そしてどの集団でどんな効果が推定されたか、です。本記事では、Rの実データでこの流れをすべて実行し、バランスが一部しか取れなかった例を示したうえで、逆確率重み付け(IPTW)との違い、そしてPSMにできないこと(測定していない交絡は調整できません)を整理します。
本記事が扱うのは傾向スコア法だけです。交絡とは何か、調整する変数をどう選ぶかは、交絡因子とは|調整方法と論文での書き方をご覧ください。
1. 傾向スコアとは何か、何を保証するのか
傾向スコアとは、測定された背景因子(共変量)が与えられたときに、その人が治療を受ける確率のことです(Rosenbaum と Rubin, 1983)。Austin(2011)は、考え方を次のようにまとめています。測定済みの共変量のもとで治療の割り当てが「強く無視可能(strongly ignorable)」であれば、傾向スコアで条件づけることで、平均的な治療効果の不偏な推定値が得られます。強い無視可能性には2つの部分があります。測定されていない交絡がないこと(治療の割り当てと結果の両方に影響するすべての変数が測定されていること)と、すべての人が、どちらの治療も受ける確率がゼロではないことです。前者がこの方法の決定的な前提であり、方法そのものがこの前提をつくり出すわけではありません。
文献から、設計上の要点が2つ導かれます。
- 結果を見る前に設計する。Stuart(2010)は、マッチングを観察研究の「設計段階」の作業と位置づけ、結果の値に触れずに行うべきだと述べています。結果の解析は、設計が終わってから始めます。実際の研究では、共変量、アルゴリズム、キャリパーを、結果を見る前に決めてください。
- 何を推定したいかを決める。治療を受けた人での効果(ATT)と、集団全体での効果(ATE)は、別の問いに答えます(Austin, 2011)。どちらを知りたいかで方法が決まります。第5節で、この違いが結果にどう効くかを示します。
2. 手順と、報告すべき選択
| ステップ | やること | 報告すること |
|---|---|---|
| 1. 共変量を選ぶ | 治療の前に測定された、治療と結果の両方に影響しうる変数。治療後に測定された変数は入れない | 共変量の全リスト。がん領域の研究を対象とした系統的レビューでは、傾向スコアの推定に使った変数が明確でなかったものが12.1%(がん研究)と8.8%(がん外科研究)、治療後の変数を誤って含めていたものが3.4%と9.3%ありました(Yaoら, 2017) |
| 2. スコアを推定する | 通常は、治療を共変量で説明するロジスティック回帰 | モデルの形(交互作用、多項式の有無)。c統計量はバランスの確認にはなりません。Austin(2009)は、c統計量では重要な交絡因子の入れ忘れが分からないことを示しています |
| 3. マッチングする | 最近傍法、1対1、キャリパーあり、復元抽出なしが一般的な既定 | アルゴリズム、比率、キャリパーの幅とその尺度、復元抽出の有無、マッチした数としなかった数。同じレビューで、マッチングのアルゴリズムを報告していなかった研究は19.0%と36.1%でした(Yaoら, 2017) |
| 4. バランスを確認する | すべての共変量について、マッチング前後のSMDを見る | SMD付きの表1(前後)、0.1を超えた共変量の数 |
| 5. 効果を推定する | マッチング後のサンプルで結果を比較する。分散の推定はペアを考慮する | 推定値、95%信頼区間、マッチしたn、推定値がどの集団に当てはまるか |
| 6. 限界を確かめる | 測定されていない交絡と、解析上の選択への感度分析 | 少なくとも1つ |
キャリパー
キャリパーなしの最近傍マッチングは、どれだけ遠くても、その時点で最も近い対照を治療群の各人に割り当てます。キャリパーは許容する距離の上限を決める仕組みで、範囲内に対照がいない治療群の人は、マッチされずに除外されます(Austin, 2011)。広く合意された幅はありません。Austin(2011, Pharmaceutical Statistics)は、連続変数の結果とリスク差についてシミュレーションを行い、傾向スコアのロジットの標準偏差の0.2倍の幅で、ロジット上でマッチングすることを推奨しています。この幅(またはそれに近い値)は、推定された効果の平均二乗誤差を最小にし、彼のシナリオでは、粗い推定量のバイアスの98%以上を除きました。ソフトによって、どの標準偏差を使うかが違うため、「0.2 SD」だけでなく、実際の幅も書いてください。
SMDと0.1の目安
標準化差(standardized mean difference、SMD)は、群間の平均の差を、プールした標準偏差で割ったものです。(治療群の平均 − 対照群の平均) / sqrt((治療群の分散 + 対照群の分散) / 2) で計算し、二値変数では平均を割合に置き換えます(Austin, 2011)。標本サイズに依存しません。Austin(2011)は、重要な不均衡を示す閾値について、広く合意された基準はなく、0.1未満であれば差は無視できるとみなされてきた、と述べています。バランスをP値で判断してはいけません。マッチングでサンプルが小さくなるため、マッチング後に有意でなくなっても、バランスが良くなったのではなく、検出力が下がっただけかもしれないからです(Austin, 2009。Imaiらの議論を引用)。ソフトによって分母が異なる場合があります。MatchItとcobaltは、既定ではマッチング前のサンプルの治療群の標準偏差で割ります。本記事の数値は上の式を使っています。どちらを使ったかを書いてください。
あわせて読みたい:共変量の選び方と過剰適合:Rの実例と書き方
3. Rによる実例|職業訓練プログラムと1978年の収入
データ。MatchIt::lalonde(MatchIt 4.7.2)は614人の男性のデータです。National Supported Work Demonstrationという職業訓練プログラムに参加した185人(治療群)と、Population Survey of Income Dynamics(PSID)の比較対象429人からなります(Rのヘルプページ。Lalonde, 1986、Dehejia と Wahba, 1999で分析)。結果は1978年の収入(re78、米ドル)です。共変量は、年齢、教育年数、人種、既婚、高校卒業資格なし、1974年と1975年の収入です。2群は背景が大きく異なり、手法にとって厳しい試験になるデータです。これは手順を示すための教材であり、このプログラムの効果についての結論ではありません。
# R 4.3.3; MatchIt 4.7.2; WeightIt 1.7.0
library(MatchIt); library(WeightIt); library(sandwich); library(lmtest)
data(lalonde, package = "MatchIt")
f <- treat ~ age + educ + race + married + nodegree + re74 + re75

# 1. 傾向スコアのモデルと、1対1キャリパーマッチング(ロジットPSのSDの0.2倍)
m <- matchit(f, data = lalonde, method = "nearest", distance = "glm",
             link = "linear.logit", caliper = 0.2)
m
summary(m)$nn

# 2. SMD(Austin 2011): (mean_t - mean_c) / sqrt((var_t + var_c) / 2)
wvar <- function(x, w) { mu <- sum(w * x) / sum(w); sum(w * (x - mu)^2) / (sum(w) - sum(w^2) / sum(w)) }
smd <- function(X, z, w = rep(1, length(z))) apply(X, 2, function(x) {
  mt <- sum(w[z == 1] * x[z == 1]) / sum(w[z == 1]); mc <- sum(w[z == 0] * x[z == 0]) / sum(w[z == 0])
  (mt - mc) / sqrt((wvar(x[z == 1], w[z == 1]) + wvar(x[z == 0], w[z == 0])) / 2) })
X <- with(lalonde, cbind(age, educ, black = race == "black", hispan = race == "hispan",
                         white = race == "white", married, nodegree, re74, re75))
md  <- match.data(m, data = lalonde)
idx <- match(rownames(md), rownames(lalonde))
round(cbind(before  = smd(X, lalonde$treat),
            matched = smd(X[idx, ], lalonde$treat[idx])), 3)

# 3. マッチング後のサンプルでの効果(ペアごとのクラスタ頑健SE)
fit <- lm(re78 ~ treat, data = md, weights = weights)
coeftest(fit, vcov. = vcovCL, cluster = ~subclass)["treat", ]
出力(Rのセッションからコピー):
A `matchit` object
 - method: 1:1 nearest neighbor matching without replacement
 - distance: Propensity score [caliper]
             - estimated with logistic regression and linearized
 - caliper: <distance> (0.361)
 - number of obs.: 614 (original), 234 (matched)
 - target estimand: ATT

              Control Treated
All               429     185
Matched           117     117
Unmatched         312      68

         before matched
age      -0.242  -0.036
educ      0.045   0.029
black     1.668   0.039
hispan   -0.277  -0.029
white    -1.406  -0.023
married  -0.719  -0.267
nodegree  0.235   0.257
re74     -0.596   0.010
re75     -0.287   0.016

estimate       se    lower    upper        p
1770.603  924.234  -40.863 3582.069    0.057
全サンプルでの傾向スコアのロジットの標準偏差は1.805なので、0.2 SDのキャリパーはロジット単位で0.361です。傾向スコアモデルのc統計量は0.874です(記述のみ。ステップ2を参照)。マッチング前の1978年の平均収入は、治療群185人で6,349ドル、比較対象429人で6,984ドルでした(調整前の差 −635、95%信頼区間 −1,926〜655)。
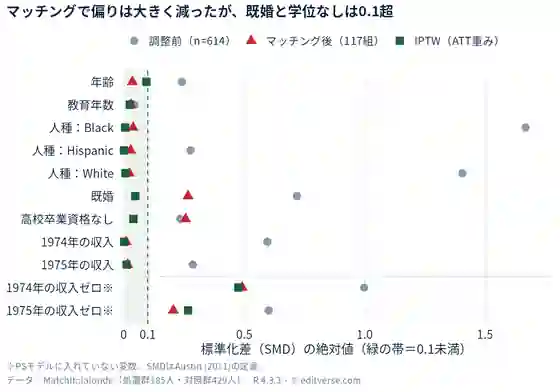
図の読み方:マッチングにより、SMDは最大1.67から多くが0.05未満まで下がりました。しかし、「既婚」(−0.267)と「高校卒業資格なし」(0.257)は0.1を大きく上回ったままで、バランスは一部しか取れていません。
論文用の表1(実データの平均)
| 共変量 | 治療群・前(n = 185) | 対照群・前(n = 429) | SMD・前 | 治療群・後(n = 117) | 対照群・後(n = 117) | SMD・後 |
|---|---|---|---|---|---|---|
| 年齢(歳) | 25.82 | 28.03 | −0.242 | 26.08 | 26.41 | −0.036 |
| 教育年数 | 10.35 | 10.24 | 0.045 | 10.50 | 10.43 | 0.029 |
| Black(%) | 84.3 | 20.3 | 1.668 | 75.2 | 73.5 | 0.039 |
| Hispanic(%) | 5.9 | 14.2 | −0.277 | 9.4 | 10.3 | −0.029 |
| White(%) | 9.7 | 65.5 | −1.406 | 15.4 | 16.2 | −0.023 |
| 既婚(%) | 18.9 | 51.3 | −0.719 | 17.1 | 28.2 | −0.267 |
| 高校卒業資格なし(%) | 70.8 | 59.7 | 0.235 | 73.5 | 61.5 | 0.257 |
| 1974年の収入(ドル) | 2,096 | 5,619 | −0.596 | 2,800 | 2,744 | 0.010 |
| 1975年の収入(ドル) | 1,532 | 2,466 | −0.287 | 1,971 | 1,915 | 0.016 |
結果の読み方
- モデルに入れた変数のバランスは、すべてのバランスではありません。1974年の収入ゼロ(モデルに入れた変数に関連する量ですが、モデルには入っていません)のSMDは、マッチング前0.998、マッチング後0.492でした。1975年の収入ゼロは0.602から0.206です。平均収入のバランスはほぼ完全(0.010と0.016)でしたが、収入がまったくない人の割合は取れていません。入れた変数だけでなく、変換や交互作用でもバランスを確認してください。
- マッチングによって、研究している集団が変わりました。治療群185人のうち68人は、キャリパーの範囲内に対照が見つからず除外されました(マッチしたのは185人中117人)。この68人はすべてBlackで、1975年の平均収入は777ドルでした(マッチした治療群117人では1,971ドル)。MatchItのドキュメントによれば、キャリパーによって治療群の一部が除かれた場合、目標とする推定対象(estimand)は、全治療群のATTではなく、マッチしたサンプルでの治療効果になります。この結果は、マッチした治療群117人に当てはまります。
- 重なり(オーバーラップ)が理由です。傾向スコアが0.5を超えたのは、治療群185人中143人に対し、対照群429人中では66人だけでした。スコアが0.05未満の対照は155人いた一方、治療群は3人だけです。治療群の多くに似た対照が少なく、復元抽出なしの1対1マッチングでは、適切な相手が足りなくなります。
- 推定は精度が高くありません。マッチした117組での1978年の平均収入は、治療群6,626ドル、対照群4,855ドルで、差は1,771ドル(95%信頼区間 −41〜3,582、ペアごとのクラスタ頑健SE 924)でした。区間はかろうじて0を含みます。ペアごとのクラスタ頑健分散はよく使われる選択肢の1つです。どれを使ったにせよ、名前を書いてください。
4. 選択でどれだけ変わるか|感度分析の表
同じデータを、ほかの妥当な設定で解析すると、答えにはばらつきが出ます。ここでは教材として、結果が分かっている状態で全データに対してすべての設定を実行しました。実際の研究では、設計上の選択は事前に決めておくべきです(Stuart, 2010)。以下の表は、事前に規定した感度分析をどう示せるかの例です。
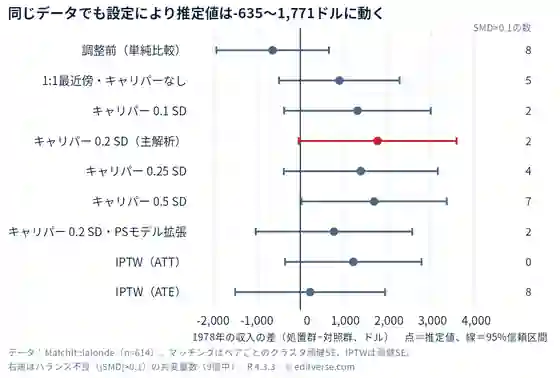
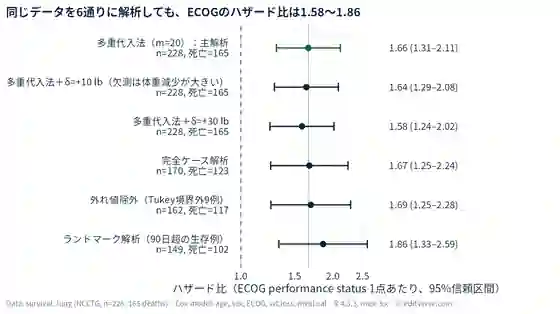
図の読み方:設定によって、推定値は −635 ドルから 1,771 ドルまで動きます。赤が、本記事で示した主解析(キャリパー0.2 SD)です。
| 設定 | 使用した治療群 / 対照群 | 推定値(ドル) | 95%信頼区間 | |SMD| > 0.1の共変量(9個中) |
|---|---|---|---|---|
| 調整前 | 185 / 429 | −635 | −1,926〜655 | 8 |
| 1対1最近傍、キャリパーなし | 185 / 185 | 894 | −488〜2,277 | 5 |
| キャリパー 0.1 SD | 112 / 112 | 1,310 | −372〜2,991 | 2 |
| キャリパー 0.2 SD(上記の解析) | 117 / 117 | 1,771 | −41〜3,582 | 2 |
| キャリパー 0.25 SD | 118 / 118 | 1,386 | −378〜3,150 | 4 |
| キャリパー 0.5 SD | 128 / 128 | 1,693 | 27〜3,358 | 7 |
| キャリパー 0.2 SD、PSモデル拡張* | 103 / 103 | 771 | −1,023〜2,565 | 2 |
| IPTW、ATT重み | 185 / 429(重み付き) | 1,214 | −350〜2,778 | 0 |
| IPTW、ATE重み | 185 / 429(重み付き) | 225 | −1,493〜1,942 | 8 |
*拡張したモデルは、年齢、1974年の収入、1975年の収入の2乗項と、各年の収入ゼロの指標を加えたものです。
目立つ点が3つあります。第一に、ここでは0.2 SDのキャリパーでも「バランスの取れた」データにはなりません。キャリパーを0.5 SDまで緩めると、0.1を超える共変量は7つ残ります。第二に、マッチングの設定によって推定値は771ドルから1,771ドルの間を動き、0.5 SDのキャリパーを除くすべてで、95%信頼区間は0を含みます(0.5 SDのキャリパーでは、バランス不良の共変量が7つ残っています)。第三に、バランスはキャリパーの幅に対して単調ではありません(0.25 SDは0.2 SDより悪い)。思い込まず、設定ごとに確認してください。1つの設定と1つのP値だけを報告する論文は、このばらつきを隠してしまいます。主解析を示し、それが計画どおりだったことを書き、近隣の設定も示してください。
バランスが取れない場合の選択肢は、傾向スコアのモデルを見直すこと(上で実施しましたが、ここでは2つの共変量が改善せず、治療群が14人減りました)、重要な共変量で完全一致させること、マッチング後のサンプルで回帰調整を併用することです(Austin, 2011が可能だと述べています)。誠実な報告では、どの共変量が0.1を超えたままかを書きます。
5. マッチングとIPTWの違い
IPTWは、データを捨てずに、重みをつけ直す方法です。ATT重みでは治療群の全員に重み1を与え、対照群の各人にはe/(1 − e)(eは傾向スコア)を与えます。ATE重みでは、治療群は1/e、対照群は1/(1 − e)です(Austin と Stuart, 2015)。
| 傾向スコアマッチング | IPTW | |
|---|---|---|
| サンプルの扱い | マッチしなかった人は除外される | 全員を残し、重みをつける |
| 推定対象 | マッチしたサンプルでの効果(治療群が1人も除外されなければATT) | 重みによりATTまたはATE |
| 主な弱点 | 捨てられるデータ、アルゴリズムとキャリパーへの依存 | 極端な重みで推定が不安定になる(Austin と Stuart, 2015) |
| 分散 | ペアを考慮する(ここではペアごとのクラスタ頑健SE) | 重みを推定しているため、頑健(サンドイッチ型)分散を使う(Austin と Stuart, 2015) |
| バランスの確認 | マッチしたサンプルでのSMD | 重み付けしたサンプルでのSMD |
この例では、ATT重みのIPTWは、モデルに入れた9つの共変量すべてのバランスを取り(最大の|SMD|は0.094、図1参照)、614人全員を残して、1,214ドル(95%信頼区間 −350〜2,778)という推定値になりました。重みは中程度(最大3.74)で、対照群の有効サンプルサイズは429から99.8に下がりました。1974年と1975年の収入ゼロの不均衡は、マッチングと同様に残りました(SMD 0.476と0.267)。ATE重みでは様子が違います。最大の重みは40.08、9つの共変量のうち8つが0.1を超えたままで、推定値は225ドル(95%信頼区間 −1,493〜1,942)でした。2つのIPTWの推定値が違うのは、どちらかが優れているからというより、問いが違うためでもあります(治療群での効果と、対照群全員を含む集団での効果)。Austin と Stuart(2015)は、極端な重みへの対処として安定化重みと切り捨て重みを論じていますが、ここではどちらも実行していません。
どちらの方法が一般に優れている、ということはありません。知りたい問い(ATTかATEか)、重なりの程度、そして結果を見る前に説明できる選択かどうかで選んでください。
6. 傾向スコアにできないこと
- 測定されていない交絡。スコアが取るバランスは、測定済みの共変量だけです。Austin(2011)は、「測定されていない交絡がないこと」を傾向スコア分析の決定的な前提と呼んでいます。図1のバランスは、データにない変数については何も教えてくれません。
- 定量的に確かめる方法。E値は、測定された共変量で条件づけたうえで、測定されていない交絡因子が、治療と結果の両方とリスク比の尺度でどれだけ強く関連していれば、推定値を説明し去れるかの最小値です。VanderWeeleとDing(2017)は、推定値と、信頼区間のうち帰無値に近いほうの限界の両方についてE値を報告することを提案しています。上のマッチング後の推定値(標準化平均差 1,771 / 7,248 = 0.24、マッチしたサンプルでの1978年の収入のプールSDは7,248ドル)に
EValue::evalues.MD()を使うと、点推定値のE値は1.81、信頼区間の限界のE値は1.00です。区間がすでに0を含んでいるため、「効果なし」と両立するのに、交絡は一切必要ありません。 - 重なりの不足。治療群に比較できる対照がいない場合(ここでは、最も高い対照のスコア0.789を上回る治療群が8人いました)、どんな重み付けやマッチングでも、比較データをつくり出すことはできません。
- 因果的な表現。測定された変数でバランスが完全でも、研究デザインが裏づけない限り、「関連している」と書きます。報告すべき内容はSTROBEを参照してください。
あわせて読みたい:遺伝的変異を操作変数に使うメンデルランダム化解析
7. 論文でPSMをどう報告するか
報告の実態から分かること
2014〜2015年に主要な医学・がん雑誌に掲載された33件のがん研究と、2015年11月までに発表された306件のがん外科研究を対象とした系統的レビューでは、背景因子の比較を省いていたものがそれぞれ21.9%と15.6%あり、レビューの著者らは傾向スコア分析の報告ガイドラインを提案しています(Yaoら, 2017)。以下の項目は、読者がマッチングの良し悪しを判断するために必要な情報です。
報告チェックリスト
- 傾向スコアのモデルに入れた共変量。各変数を入れた理由と、すべて治療前に測定されたものであること。
- モデルの形(ロジスティック回帰など。交互作用や多項式の有無)。
- マッチングのアルゴリズム、比率、キャリパー(実際の幅と定義)、復元抽出の有無。
- マッチング前後の治療群と対照群の人数、マッチしなかった人数、除外された人の特徴。
- 前後の表1とSMD。0.1を超えた共変量の数とその名前。
- 推定対象(ATT、ATE、またはマッチしたサンプルでの効果)。
- マッチング後のサンプルでの結果の解析と、分散の推定方法。
- 感度分析(ほかのキャリパーやモデル、IPTW、E値)。
- ソフトウェアとパッケージのバージョン。
- 限界:測定されていない交絡、残った不均衡、一般化可能性の制限。
Methodsの英文テンプレート
Propensity scores were estimated by logistic regression of treatment status on age, education, race, marital status, absence of a high school degree and earnings in 1974 and 1975. Treated participants were matched 1:1 to controls by nearest neighbour matching without replacement on the logit of the propensity score within a caliper of 0.2 standard deviations (0.361 on the logit scale). Covariate balance was assessed with standardized mean differences, and a value below 0.1 was taken to indicate adequate balance. The treatment effect in the matched sample was estimated by a weighted linear regression with pair-clustered robust standard errors. Sensitivity analyses varied the caliper and the propensity score model and used inverse probability of treatment weighting. Analyses were performed in R 4.3.3 with MatchIt 4.7.2 and WeightIt 1.7.0.
ご自身の事前の解析計画に合わせて調整してください。計画が異なる場合は、そのまま使わないでください。
Resultsの英文例(実データの数値入り)
Of 185 treated and 429 comparison participants, 117 treated participants were matched to 117 controls; 68 treated participants had no control within the caliper and were excluded. Standardized mean differences fell below 0.05 for age, education, race and earnings, but remained above 0.1 for marital status (−0.267) and absence of a high school degree (0.257). In the matched sample, mean 1978 earnings were 6,626 dollars in the treated group and 4,855 dollars in the controls (difference 1,771 dollars, 95% CI −41 to 3,582). Estimates in the sensitivity analyses ranged from 225 to 1,693 dollars, and all but one of the 95% confidence intervals included zero.
この書き方では、マッチしたn、残った不均衡、信頼区間つきの効果が示され、因果効果を断定していません。例外は0.5 SDのキャリパーの解析(27〜3,358)で、第4節の表のとおり、この解析ではバランス不良の共変量が7つ残っています。
8. よくある誤り
- 傾向スコアを、交絡がないことの証明とみなす。バランスが取れるのは、測定済みの共変量だけです。
- P値やc統計量でバランスを判断する(Austin, 2009)。
- 除外した人を報告しない。マッチしなかった人がいれば、推定対象が変わります。
- 治療後の変数をスコアに入れる(Yaoら, 2017)。
- 結果を見てからキャリパーやモデルを選ぶ(Stuart, 2010)。
- 近隣の設定で大きく結果が変わるのに、1つの設定だけ報告する(第4節)。
- 推定対象が違うのに、PSMとIPTWの推定値を同じ問いへの答えとして比べる。
統計に関する査読コメント全般は査読で統計を指摘されたらを、二値の結果を扱うロジスティック回帰はロジスティック回帰とオッズ比の報告をご覧ください。
9. Editverse Japanがお手伝いできること
傾向スコア解析の計画や、査読者から求められた追加解析でお困りの方へ
Editverse Japanの医学統計解析サポート(定額 79,800円)は、統計手法の選択、記述統計・推測統計の実施、MethodsとResultsの執筆支援までを、研究者の方と一緒に進めるサービスです。解析コードと結果レポートを納品し、R・SPSS・Stata・SASに、投稿先ジャーナルの要件に合わせて対応します。納期の目安は解析内容により5〜14営業日です。採択まで追加料金なしでサポートを継続します(採否はジャーナルの編集者・査読者が判断し、採択を保証するものではありません)。最終的な内容、結果の解釈、結論、投稿の判断は著者に帰属します(ICMJE・COPE準拠。統計支援は正当な貢献であり、研究デザイン・解釈・結論は研究者のものです)。
すでに査読者からマッチングやバランス、交絡の調整について指摘を受けている場合は、査読対応・統計再解析(定額 98,000円)をご覧ください。再解析、再現可能なRスクリプトと出力ログ、統計コメントへのポイントごとの回答まで対応します。
まとめ
- 傾向スコアは、測定された背景因子が与えられたときに治療を受ける確率です。それでマッチングすれば測定済みの共変量のバランスは取れますが、測定していない変数のバランスは取れません。
- 報告するのは、共変量、アルゴリズム、キャリパー(実際の幅)、マッチしたn、前後のSMD(通常は0.1未満が目標)、推定対象、分散の推定方法です。
MatchIt::lalondeでは、0.2 SDのキャリパーによる1対1マッチングで、治療群185人のうち117人が残りました。SMDの多くは0.05未満になりましたが、既婚(−0.267)と高校卒業資格なし(0.257)は0.1を超えたままでした。マッチング後の推定値は1,771ドル(95%信頼区間 −41〜3,582)です。- ほかのマッチング設定では771〜1,693ドル、IPTWではATT重みで1,214、ATE重みで225ドルでした。感度分析を報告してください。
- マッチング後の推定値のE値は、点推定値で1.81、信頼区間の限界で1.00でした。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 交絡因子とは|調整方法と論文での書き方・査読で問われる点
- 回帰分析の種類と選び方
- ロジスティック回帰とオッズ比の報告
- 【完全ガイド】STROBE声明で観察研究を正しく報告する方法
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 感度分析とは|論文での報告方法と欠測データ・E値の実例
よくある質問
Q. キャリパー0.2とは、何を意味しますか?
治療群の人の傾向スコアと対照群の人の傾向スコアの距離の許容上限を、傾向スコアのロジットの標準偏差の0.2倍で表したものです。Austin(2011, Pharmaceutical Statistics)は、連続変数の結果とリスク差についてこの幅を推奨しています。例では、ロジット単位で0.361でした。
Q. SMDは0.1未満でなければなりませんか?
いいえ。Austin(2011)は、広く合意された閾値はなく、0.1未満は無視できる不均衡とみなされてきた、と述べています。例では、マッチング後に2つの共変量が0.1を超えており、論文にはそのことを書く必要があります。
Q. マッチング後に、背景因子の差をP値で検定してもよいですか?
Austin(2009)は、マッチングでサンプルと検出力が減り、バランスは標本の性質であることから、バランスの有意性検定は適切でないと述べています。SMDを使ってください。
Q. PSMとIPTWは、どちらを使うべきですか?
一般にどちらが優れているということはありません。マッチングはマッチしなかった人を除外します(対象集団が変わります)。IPTWは全員を残しますが、極端な重みが出ることがあります(Austin と Stuart, 2015)。例では、ATT重みは9つの共変量すべてのバランスを取りましたが、ATE重みは取れませんでした(最大の重み40.08)。
Q. 傾向スコアマッチングは、測定されていない交絡を調整しますか?
いいえ。調整されるのは、測定済みの共変量だけです。E値(VanderWeele と Ding, 2017)は、測定されていない交絡がどれだけ強ければよいかを定量化する方法の1つです。マッチング後の推定値では、点推定値で1.81、信頼区間の限界で1.00でした。
参考資料
PubMed収載(各文献はNCBI E-utilitiesのesummaryで2026-10-07に確認)
- [文献1]Austin PC. An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studies. Multivariate Behav Res. 2011;46(3):399-424. doi:10.1080/00273171.2011.568786. PMID: 21818162. PMC3144483.
- [文献2]Austin PC. Optimal caliper widths for propensity-score matching when estimating differences in means and differences in proportions in observational studies. Pharm Stat. 2011;10(2):150-161. doi:10.1002/pst.433. PMID: 20925139. PMC3120982.
- [文献3]Austin PC. Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Stat Med. 2009;28(25):3083-3107. doi:10.1002/sim.3697. PMID: 19757444. PMC3472075.
- [文献4]Stuart EA. Matching methods for causal inference: A review and a look forward. Stat Sci. 2010;25(1):1-21. doi:10.1214/09-STS313. PMID: 20871802. PMC2943670.
- [文献5]Austin PC, Stuart EA. Moving towards best practice when using inverse probability of treatment weighting (IPTW) using the propensity score to estimate causal treatment effects in observational studies. Stat Med. 2015;34(28):3661-3679. doi:10.1002/sim.6607. PMID: 26238958. PMC4626409.
- [文献6]Yao XI, Wang X, Speicher PJ, Hwang ES, Cheng P, Harpole DH, Berry MF, Schrag D, Pang HH. Reporting and Guidelines in Propensity Score Analysis: A Systematic Review of Cancer and Cancer Surgical Studies. J Natl Cancer Inst. 2017;109(8):djw323. doi:10.1093/jnci/djw323. PMID: 28376195. PMC6059208(抄録を使用)。
- [文献7]VanderWeele TJ, Ding P. Sensitivity Analysis in Observational Research: Introducing the E-Value. Ann Intern Med. 2017;167(4):268-274. doi:10.7326/M16-2607. PMID: 28693043(抄録を確認)。
そのほかの資料
- [文献8]Rosenbaum PR, Rubin DB. The central role of the propensity score in observational studies for causal effects. Biometrika. 1983;70(1):41-55. doi:10.1093/biomet/70.1.41(PubMed非収載。書誌情報はCrossrefで確認。傾向スコアの定義は、これを引用しているAustin 2011に拠る)。
- [文献9]
MatchIt::matchitとMatchIt::lalondeのRドキュメント(MatchIt 4.7.2、本記事で使用したRセッションで確認)。lalondeは、National Supported Work DemonstrationとPSIDのデータの一部で、Lalonde(1986)とDehejia と Wahba(1999)が分析したものと説明されています。 - [文献10]Rパッケージ MatchIt 4.7.2、WeightIt 1.7.0、sandwich 3.1.1、lmtest 0.9.40、EValue(関数
evalues.MD)。本記事で使用したRセッションにインストールされていたもの。