リッカート尺度の分析|平均か中央値か・検定の選び方と書き方
リッカート項目を1つだけ分析するときは、回答の分布全体を示したうえで、中央値と四分位範囲を報告します。平均値を添えるかどうかは任意です。複数の項目を合計または平均した尺度得点では、項目がまとまっていることをクロンバックのα(Cronbach’s alpha)などで示したうえで、平均値と標準偏差を報告するのが一般的です。2群を比べるときは、Welchのt検定(平均値の差と信頼区間)とWilcoxon-Mann-Whitney検定のどちらも妥当で、どちらを主解析にすべきかは文献でも意見が分かれています。あらかじめ一方を主解析に定め、その理由をMethodsに書き、効果量を添えてください。本記事では、2,800人分の実データ1つ(Rの出力つき)を使ってこれらを順に確認し、論文で使う文例まで示します。
本記事が扱うのは、リッカート項目と、リッカート型尺度の得点を独立した2群で比べる場合に限ります。検定の全体像は統計検定の選び方を、正規性や等分散性の確認は統計的仮定の確認をご覧ください。なお、回答の段階数(5段階か7段階か)、中間の選択肢を置くかどうか、質問項目の作り方は、本記事の対象外です。
1. 項目か尺度得点か|何を分析しているのか
まず基本的な定義です。Sullivan & Artino(2013)[文献1]によると、リッカート尺度は1932年にRensis Likertが態度を測るために開発したもので、典型的には、ある意見にどの程度同意するかを答える5段階または7段階の順序尺度です。本記事の後半で使うデータは6段階で、中間(どちらでもない)の選択肢がありません。
「リッカート尺度」という言葉は、次の2つの両方を指して使われがちです。どちらを扱っているかで、適した要約方法と検定が変わります。
| 単一のリッカート項目 | 複数項目からなる尺度得点 | |
|---|---|---|
| 内容 | 順序のある選択肢をもつ1つの記述文。例:1 = まったくそう思わない 〜 5 = 非常にそう思う | 1つの概念を測る複数の項目を、合計または平均して1つの得点にしたもの |
| 測定水準 | 順序尺度。回答に順位はつけられるが、「いつも」「よく」「ときどき」の間隔が等しいとは限らない | 順序尺度の項目の合計または平均。連続量として扱う研究者も、そうしない研究者もいる(第2節) |
| 通常の記述統計 | 回答カテゴリごとの度数(%)。中央値と四分位範囲 | 平均値(標準偏差)。分布が歪んでいれば中央値(四分位範囲)も。分布の図 |
| 併せて報告する項目 | 項目の文言と回答の選択肢 | 自分の標本でのクロンバックのα(または別の信頼性の指標)と、逆転項目の扱い |
表の根拠です。単一の回答が順序尺度であること、および複数のリッカート型項目を合計点や平均点でまとめて「サーベイ尺度」として扱う実務は、Sullivan & Artino(2013)[文献1]が述べています。同論文は、まとめた項目が背後の変数を測っていることの根拠として、クロンバックのαや因子分析を示すことを勧めています。Bishop & Herron(2015)[文献6]は、CarifioとPerlaの見解として、真のリッカート尺度とは合計得点を持つ複数の質問からなるものであり、したがって分析は個々の回答ではなく合計得点に対して行うべきだと要約しています。同論文は、この見解では最低6項目が必要だと述べています。つまり定義は文献によって異なり、Sullivan & Artinoは「複数」の項目と述べる一方、6項目という下限はCarifioとPerlaに帰されています。本記事の後半で使う5項目の得点は、後者の定義では短い尺度にあたります。ただし、この例の目的は分析の進め方を示すことであり、呼び方を論じることではありません。
尺度得点については、2つの注意があります。
- αは「お墨付き」ではありません。Tavakol & Dennick(2011)[文献7]は、αは内的整合性の指標で0から1の値をとり、項目数が多いほど、また項目間の相関が高いほど大きくなること、特定の標本での得点の性質であるため、尺度を使うたびに算出すべきことを説明しています。また、αは項目が単一の概念を測っていることを前提としており、質問紙が複数の概念を扱う場合は、質問紙全体ではなく概念ごとにαを算出すべきだと述べています。同論文が検討した文献で受け入れられている値は0.70から0.95の範囲で、αが非常に高い場合は項目が重複している可能性があります。
- 逆転項目は、合計する前に得点を逆転させます。後の例で使うデータのpsychパッケージ付属の採点キーでは、A1、C4、C5、E1、E2、O2、O5などの項目が逆転項目として扱われます。本記事で使う神経症傾向の項目(N1〜N5)は、すべて同じ方向の文言で、逆転は不要です。
2. 平均値か中央値か|文献が示す考え方
この問題には長い論争があります。覚えておくべきなのは1つの決まりではなく、各文献の立場です。
| 文献 | 主張の要点 |
|---|---|
| Sullivan & Artino(2013)[文献1]J Grad Med Educ | 順序尺度では回答間の距離を測れないため、リッカート回答の平均値や標準偏差は意味が不明確です。回答が両極端に集まっていても、平均値は「中立」に見えることがあります。そのため専門家の一部は、中央値と、度数、分割表、カイ二乗検定、スピアマンの相関、マン・ホイットニーのU検定を用いるべきだと主張してきました。一方で、標本サイズが十分(各群で少なくとも5〜10観測)で、データがほぼ正規分布していれば、パラメトリック検定を使えるとする専門家もいます。同論文の結論は、リッカート尺度の回答の分析にパラメトリック検定を使うことはできるが、データを記述する目的では、データが正規分布に従わない限り平均値の価値はしばしば限られ、回答の度数分布のほうが有用なことが多い、というものです。平均値を小数点以下の多くの桁まで報告することは勧めず、記述と分析の方法は計画段階で決めて、その選択をMethodsまたはカバーレターで説明するよう助言しています。 |
| Norman(2010)[文献2]Adv Health Sci Educ(抄録) | パラメトリック統計は、小標本、非正規性、リッカート(順序)データという前提の違反に対して頑健であることが、1930年代にさかのぼる多くの研究で示されています。パラメトリック法は「誤った答えを得る」ことを心配せずに使えるとしています。 |
| Bishop & Herron(2015)[文献6]Int J Exerc Sci | リッカート型の回答は一般に順序尺度とみなされ、正規分布を前提とする分析の条件を満たしません。平均値だけを報告する危険を、表(Clason and Dormodyによる)で示しています。一方の群は5つのカテゴリに20%ずつ、もう一方の群は最初と最後のカテゴリに50%ずつ分布していますが、平均値はどちらも3で、分布は大きく異なります。また、リッカート尺度を間隔尺度として扱うことの強い支持者でも、ピアソンの相関に基づく分析は順序データへの耐性が高くないと認めており、F検定は一般に頑健だと述べています。新しい測定道具を設計する場合の代替として、ビジュアルアナログスケールを提案しています。 |
| SAMPLガイドライン、Lang & Altman(2015)[文献8] | ほぼ正規分布するデータは平均値(標準偏差)で要約します。正規分布しないデータは、中央値とパーセンタイル間範囲(interpercentile range)、範囲、またはその両方で要約します。 |
論文でどうするか
以下は上記の文献をもとにしたEditverseの実務的な読み方であり、特定の文献に書かれた規則ではありません。
- 単一項目:回答の分布(発散型積み上げ棒グラフが見やすい。図1を参照)を示し、中央値(四分位範囲)を報告します。整数の中央値は粗い指標なので、分布が異なっていても2群の中央値が同じになることがあります。第4節に、実データでの例(項目N3)があります。
- 尺度得点:平均値(標準偏差)を報告するのが通常で、中央値(四分位範囲)を併記しても1行増えるだけです。読者が平均値で十分に代表できているかを自分で判断できるよう、分布を示します。
- 事前に規定する:要約の方法と主解析の検定は、データが手元に来る前に決め、その理由をMethodsに書きます(Sullivan & Artino[文献1]の勧めのとおり)。どちらの検定でP < 0.05になるかを見てから選ぶのは、選択的報告です(関連する多重性の問題は多重比較補正をご覧ください)。
- 桁数を適切にする:1〜6点の得点の平均値なら、小数点以下は1〜2桁で十分です。それ以上の桁は情報を増やしません。
3. 2群の比較|Welchのt検定かWilcoxon-Mann-Whitney検定か
この2つの検定は答えている問いが異なり、その違いはResultsを書くときに影響します。以下、Wilcoxon-Mann-Whitney検定(ウィルコクソンの順位和検定、マン・ホイットニーのU検定とも呼ばれます)をWMW検定と略します。
| Welchのt検定 | WMW検定 | |
|---|---|---|
| 帰無仮説 | 2つの母集団の平均値が等しい | 2つの分布が位置のずれだけで異なる場合は、中央値が等しいこと。それ以外のすべての状況では、Prob(X < Y) = 0.5(X、Yは2群からそれぞれ無作為に取り出した値)(Fagerland, 2012[文献3])。同点の多い順序データでは、同点を半分として数えた Prob(X < Y) + 0.5 × Prob(X = Y) = 0.5 と読みます |
| 検出するもの | 平均値の差 | 位置、形状、ばらつきのいずれかの差。Hart(2001)[文献5]は、位置と形状の両方についての検定であり、「中央値の検定だけではない」と述べています |
| 自然な効果量 | 平均値の差と95%信頼区間 | 一方の群から無作為に選んだ1人が、もう一方の群から無作為に選んだ1人より高い得点をとる確率(同点は半分として数える)。確率的優越性(probability of superiority)と呼ばれます |
| Rの関数 | t.test()(既定はWelch版) |
wilcox.test()。同順位(タイ)があるときは、Rは正規近似を使います(Rのドキュメント) |
| 標本サイズに関する文献の記述 | 非正規性に対して比較的頑健で、標本が大きいほどその傾向が強まります。標本サイズ200では、強く歪んだ分布に対しても頑健です(Fagerland, 2012[文献3]) | ノンパラメトリック検定は、t検定の代替として使う場合、小規模な研究で最も有用です。大規模な研究でt検定の代わりに使うと、意図した問いとは別の問いに答えていることがあります。一方、Fagerlandは、WMW検定は順序データの分析に最も有用だとも述べています(Fagerland, 2012[文献3]) |
以下の3点は、いずれも上記の文献に基づきます。
- WMW検定は、自動的に「中央値の検定」になるわけではありません。Hart(2001)[文献5]は、BMJの論文の例を使って、中央値の差にはしばしばばらつきや形状の差が伴うことを示しています。Fagerland(2012)[文献3]は、シミュレーションにより、歪んだデータで2群の平均値と中央値が等しくてもばらつきがわずかに異なる場合、WMW検定が高い割合で帰無仮説を棄却しうること、その棄却率はProb(X < Y)が0.5と異なることを検出する検出力として読むべきであることを示しています。
- WMW検定の大標本での近似は、形状の違いに敏感です。Fagerland & Sandvik(2009)[文献4]は、分散のわずかな違いと中程度の歪みが、名目上の第1種の過誤率から大きく外れる原因になりうると報告し、実務では、結果を解釈する前に、順位をつけた標本が対称性と分散の等質性をおおむね満たしているかを確認するよう助言しています。この点でBrunner-Munzel検定は、標準的なWMW検定より一般に性能がよいとしています。Fagerland(2012)[文献3]は、Brunner-Munzel検定は多くのソフトウェアで広く使えるわけではないと付け加えています。
- Rの「位置の差」は、中央値の差ではありません。
wilcox.test()で信頼区間(conf.int = TRUE)を求めると、Hodges-Lehmann推定量が返ります。Rのドキュメントは、これが「中央値の差を推定するものではなく(よくある誤解)、xからの標本とyからの標本の差の中央値」であると述べています。リッカート型データの論文では、確率的優越性と平均値のほうが説明しやすくなります。
対応のあるデータ(同じ人の前後比較など)では、対応のある検定が必要です。SAMPLは、対応のあるデータは対応のある検定で分析したことを明記するよう求めています。3群以上の比較、相関、リッカート型アウトカムの回帰は別のテーマです。スピアマンの相関は相関係数とは、検定の全体像は統計検定の選び方をご覧ください。
4. Rによる実例|神経症傾向の5項目、女性と男性の比較
データ。psych::bfiは、国際パーソナリティ項目プール(IPIP)の25の自己報告項目に、SAPAのウェブベースのプロジェクトを通じて2,800人が回答したデータで、性別、学歴、年齢も含みます(Rのbfiのヘルプ)。回答は6段階で、1 = very inaccurate(全く当てはまらない)、2 = moderately inaccurate(かなり当てはまらない)、3 = slightly inaccurate(やや当てはまらない)、4 = slightly accurate(やや当てはまる)、5 = moderately accurate(かなり当てはまる)、6 = very accurate(非常に当てはまる)です。中間の選択肢はありません。(psychパッケージのヘルプはbfiを非推奨と表示していますが、本記事で使ったpsych 2.4.1ではデータを引き続き使えます。新しいバージョンのpsychではpsychTools::bfiが必要になる場合があります。)性別は、データ上では1 = 男性、2 = 女性とコードされています(男性919人、女性1,881人)。神経症傾向の5項目N1〜N5を使います。図表の日本語の項目名と選択肢名はEditverseによる仮訳であり、妥当性が検証された日本語版尺度ではありません。これは方法を学ぶための例です。回答者はオンラインのプロジェクトのボランティアであって確率標本ではなく、項目も健康上のアウトカムではなく、ここに示すことは男女一般についての知見ではありません。
項目レベル|度数、中央値、WMW検定
# R 4.3.3; psych 2.4.1
library(psych)
dat <- bfi
dat$sex <- factor(dat$gender, 1:2, c("Men", "Women"))   # dataset variable "gender": 1 = male, 2 = female

table(dat$sex, dat$N5)                                  # N5 = "Panic easily"
tapply(dat$N5, dat$sex, median, na.rm = TRUE)
wilcox.test(N5 ~ sex, data = dat)
1 2 3 4 5 6
Men 310 244 112 130 76 37
Women 344 416 270 377 251 204
Men Women
2 3
Wilcoxon rank sum test with continuity correction
data: N5 by sex
W = 628243, p-value < 2.2e-16
alternative hypothesis: true location shift is not equal to 0(度数の表と中央値は、table()とtapply()の出力です。上の出力は見やすさのために簡略化して並べています。N5に回答しなかった人は29人でした。)
同じ手順を5項目すべてで繰り返し、確率的優越性A(女性が男性より高い確率。同点は半分として数える)を 1 − W / (n1 × n2) で計算し、5つのP値にHolm法による調整(p.adjust(p, "holm"))を行いました。
| 項目(データセットの原文) | 男性:中央値 [Q1, Q3] | 女性:中央値 [Q1, Q3] | 男性の平均 | 女性の平均 | A(女性>男性) | WMW検定のP | Holm調整後のP |
|---|---|---|---|---|---|---|---|
| N1 すぐ怒る(Get angry easily) | 3 [1, 4] | 3 [2, 4] | 2.83 | 2.98 | 0.526 | 0.024 | 0.049 |
| N2 すぐいらいらする(Get irritated easily) | 3 [2, 4] | 4 [2, 5] | 3.30 | 3.61 | 0.558 | < 0.001 | < 0.001 |
| N3 気分の浮き沈みが激しい(Have frequent mood swings) | 3 [2, 4] | 3 [2, 5] | 2.94 | 3.35 | 0.572 | < 0.001 | < 0.001 |
| N4 よく気分が落ち込む(Often feel blue) | 3 [2, 4] | 3 [2, 4] | 3.19 | 3.18 | 0.499 | 0.959 | 0.959 |
| N5 すぐパニックになる(Panic easily) | 2 [1, 4] | 3 [2, 4] | 2.48 | 3.21 | 0.629 | < 0.001 | < 0.001 |
集計には、R 4.3.3のstats::wilcox.test、stats::quantile(Rの既定のtype 7)、stats::p.adjustを使いました。一部の回答者が項目を飛ばしたため、項目ごとの群の大きさは、男性が909〜917人、女性が1,854〜1,872人です。正確なP値は、0.0244、4.86e-07、2.88e-10、0.959、2.57e-29です(Holm調整後は0.0487、1.46e-06、1.15e-09、0.959、1.29e-28)。

読み方:「すぐパニックになる」では女性の回答が明らかに右側(中央値3対2)に寄っており、「よく気分が落ち込む」では2本の棒がほぼ同じで、「気分の浮き沈みが激しい」では2群の中央値はどちらも3なのに、分布と平均値は異なります。
表の読み方です。
- 中央値だけでは、N3の差を見逃します。どちらの群も中央値は3ですが、5または6と答えた人は女性で28%、男性で19%でした(図1から読み取り:17% + 11%対14% + 5%)。平均値は3.35と2.94で、WMW検定とA = 0.57も差を示しています。回答の分布全体を示す実務上の理由は、ここにあります(Sullivan & Artino[文献1])。
- Aには直接的な意味があります。N5のA = 0.63は、女性1人と男性1人を無作為に選んだとき、女性のN5の回答が高い確率が、同点を半分として数えて約63%であることを意味します。A = 0.50(N4)は、どちらの方向にも傾向がないことを意味します。
- 多重性。5項目を検定したので、表にはHolm法で調整したP値も示しました。N1(P = 0.024)は、調整後(0.049)には境界的です。多重比較補正をご覧ください。
尺度レベル|5項目の得点、信頼性、Welchのt検定とWMW検定
# R 4.3.3; psych 2.4.1; effsize 0.8.1; brunnermunzel 2.0
N  <- dat[, paste0("N", 1:5)]
ok <- complete.cases(N)                                  # 2,694 of 2,800 respondents
sc <- data.frame(sex = dat$sex[ok], score = rowMeans(N[ok, ]))   # 5-item mean, range 1 to 6

a <- alpha(N[ok, ], check.keys = FALSE)
round(a$total[, c("raw_alpha", "average_r")], 3)
round(unlist(a$feldt)[1:3], 3)                           # Feldt 95% CI for alpha
aggregate(score ~ sex, sc, function(v) c(n = length(v), mean = mean(v), sd = sd(v), median = median(v)))
t.test(score ~ sex, data = sc)                           # Welch (R default)
wilcox.test(score ~ sex, data = sc)

sc$sex <- relevel(sc$sex, "Women")                       # so that effect sizes are women vs men
effsize::cohen.d(score ~ sex, data = sc)
effsize::VD.A(score ~ sex, data = sc)                    # probability of superiority A
brunnermunzel::brunnermunzel.test(score ~ sex, data = sc)
raw_alpha average_r
0.813 0.467
lower.ci.raw_alpha alpha.raw_alpha upper.ci.raw_alpha
0.802 0.813 0.824
sex score.n score.mean score.sd score.median
1 Men 889.000000 2.947582 1.143409 2.800000
2 Women 1805.000000 3.270471 1.205603 3.200000
Welch Two Sample t-test
data: score by sex
t = -6.7683, df = 1853.2, p-value = 1.743e-11
95 percent confidence interval:
-0.4164528 -0.2293260
sample estimates:
mean in group Men mean in group Women
2.947582 3.270471
Wilcoxon rank sum test with continuity correction
data: score by sex
W = 682070, p-value = 2.269e-10
Cohen's d
d estimate: 0.2723775 (small)
95 percent confidence interval:
lower upper
0.1917048 0.3530501
Vargha and Delaney A
A estimate: 0.5749406 (small)
Brunner-Munzel Test
Brunner-Munzel Test Statistic = -6.4705, df = 1819.5, p-value = 1.252e-10
95 percent confidence interval:
0.4023444 0.4477745
sample estimates:
P(X<Y)+.5*P(X=Y)
0.4250594(出力は、繰り返される「data:」と「alternative hypothesis」の行を除いて短くしています。Brunner-Munzel検定の出力は、最初の因子水準である女性をXとしたものです。そのため表示された0.425は女性が男性より低い得点をとる確率で、女性が男性より高いことを表すAは 1 − 0.425 = 0.575(95%信頼区間 0.552〜0.598)です。)
各値とその出所です。
| 項目 | 値 | 関数 |
|---|---|---|
| 5項目すべてに回答した人 | 2,694人(男性889人、女性1,805人) | complete.cases |
| クロンバックのα(5項目) | 0.81(Feldtの95%信頼区間 0.80〜0.82)。項目間相関の平均 0.47 | psych::alpha |
| 得点(男性) | 平均 2.95(標準偏差 1.14)。中央値 2.8(Q1 2.0、Q3 3.8) | base R |
| 得点(女性) | 平均 3.27(標準偏差 1.21)。中央値 3.2(Q1 2.4、Q3 4.2) | base R |
| 平均値の差(女性 − 男性) | 0.32点(95%信頼区間 0.23〜0.42)。Welchのt = 6.77、df = 1853、P < 0.001 | stats::t.test |
| Cohenのd(プールした標準偏差) | 0.27(95%信頼区間 0.19〜0.35) | effsize::cohen.d |
| WMW検定 | W = 682,070、P = 2.3e-10 | stats::wilcox.test |
| 確率的優越性A(女性>男性) | 0.575(Brunner-Munzel検定の95%信頼区間 0.552〜0.598。Brunner-Munzel検定のP = 1.3e-10) | effsize::VD.A、brunnermunzel::brunnermunzel.test |
| 得点の歪度 | 0.27(男性)、0.18(女性) | psych::skew |
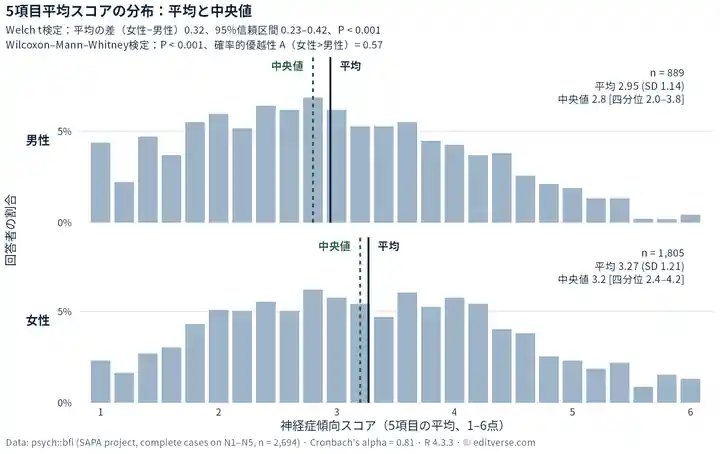
読み方:得点の分布はほぼ左右対称で歪みは軽く、平均値と中央値は各群で0.15点以内に収まり、t検定と順位に基づく検定は一致しています。女性の平均値は0.32点高い(95%信頼区間 0.23〜0.42)という結果です。
この結果の読み方です。
- 2つの検定は同じ結論ですが、報告する内容は異なります。t検定は平均値の差(1〜6点の尺度で0.32点)を信頼区間とともに示します(95%信頼区間の正しい読み方は信頼区間の解釈をご覧ください)。WMW検定とBrunner-Munzel検定は、確率A = 0.575を示します。主解析に対応するほうを報告し、もう一方は感度分析として言及します。
- 有意であることと、差の大きさは別です。2,694人という大きな標本では、P値が1e-11のように極めて小さくなることも珍しくありません。実際の効果は小さいものです(d = 0.27。A = 0.575で、0.50は差なしを意味します)。詳しくはP値の正しい解釈と効果量の計算をご覧ください。
- WMW検定の結果を「中央値の差」と書かないでください。ここで中央値は2.8と3.2ですが、検定が比べているのは分布全体です(Hart, 2001[文献5];Fagerland, 2012[文献3])。「得点は女性のほうが高い傾向にあった」と書きます。
- 信頼性は、この標本の性質です。α = 0.81は、Tavakol & Dennick[文献7]が一般に引用される範囲と述べる0.70〜0.95の中にありますが、αは5項目が単一の概念を測っている証明にはなりません。
検定の選び方で答えは変わるか|この実データでのリサンプリング確認
以下はEditverseが実施した確認で、公表された結果ではなく、当社独自のシミュレーションです。実際の回答者から小さな無作為標本を繰り返し抽出し(各標本内では非復元抽出、群ごとに独立に抽出、5,000回、set.seed(2026))、各回で2つの検定を行い、それぞれがP < 0.05になった割合を数えました。「同じ群対同じ群」の行は第1種の過誤の確認です。両方の標本が同じプールから来ているため、棄却はすべて偽陽性です。(2回の抽出は独立なので、同じ回答者が両方の標本に入ることがあります。)
set.seed(2026); B <- 5000
sim <- function(a, b, n) {
  p <- replicate(B, { x <- sample(a, n); y <- sample(b, n)
    c(t = t.test(x, y)$p.value, wmw = suppressWarnings(wilcox.test(x, y)$p.value)) })
  round(100 * rowMeans(p < 0.05), 1)      # % of samples with P < 0.05
}
# men, wom: 5-item scores of the 889 men and 1,805 women; n5m, n5w: all non-missing N5 responses
rbind(`scale, men vs women, n=20`    = sim(men, wom, 20),
      `scale, men vs women, n=50`    = sim(men, wom, 50),
      `scale, women vs women, n=20`  = sim(wom, wom, 20),
      `scale, men vs men, n=20`      = sim(men, men, 20),
      `item N5, men vs women, n=20`  = sim(n5m, n5w, 20),
`item N5, women vs women, n=20`= sim(n5w, n5w, 20))| シナリオ(群あたりの標本サイズ) | Welchのt検定:P < 0.05になった割合(%) | WMW検定:P < 0.05になった割合(%) |
|---|---|---|
| 尺度得点、男性対女性、n = 20 | 13.0 | 11.8 |
| 尺度得点、男性対女性、n = 50 | 26.5 | 24.1 |
| 尺度得点、女性対女性、n = 20(第1種の過誤の確認) | 4.4 | 4.1 |
| 尺度得点、男性対男性、n = 20(第1種の過誤の確認) | 4.9 | 4.7 |
| 項目N5、男性対女性、n = 20 | 29.4 | 28.4 |
| 項目N5、女性対女性、n = 20(第1種の過誤の確認) | 4.6 | 4.2 |
このデータでは、6段階の単一項目でn = 20(群あたり)の場合でも、2つの検定の検出力はほぼ同じで、どちらも名目の5%の偽陽性率を超えていません。これは、パラメトリック検定はリッカート型データに頑健だとするNorman(2010)[文献2]の結論と整合します。ただし、すべてのリッカート型データについて同じことが言えるとは限りません。確認したのは1つのデータ、1つの効果量、1種類の差(位置のずれ)だけで、Fagerland & Sandvik(2009)[文献4]は、群の間で形状や分散が異なるときには順位に基づく検定が違う振る舞いをすることを示しています。実務上の教訓は、2つの検定のどちらを選ぶかよりも、何を事前に規定し、結果をどう記述するかのほうが重要だということです。
5. 論文での書き方|Methods・Results・表・報告チェックリスト
報告ガイドラインが求めること
SAMPLガイドライン(Lang & Altman, 2015[文献8]。EQUATOR Networkが公開)は、各解析にどの方法を使ったかを明確にすること、検定が片側か両側かを示すこと(片側検定を使う場合はその理由も)、統計パッケージの名前を示すこと、対応のあるデータは対応のある検定で分析したことを示すこと、可能なら信頼区間で結果を定量化すること、数値は適切な精度に丸めることを求めています。P値については、報告する場合は可能な限り等号で示し(例:P < 0.05ではなくP = 0.03)、小数点以下1〜2桁で示すとしています。同じガイドラインは、報告が必要な最小のP値はP < 0.001であるとも述べています。下の文例では、非常に小さい値にこの表記を使い、それ以外は正確な値を示しています。投稿先ジャーナルの投稿規程もご確認ください。
Methodsの文例(テンプレート)
論文は英語で書くため、文例は英語のまま掲載します。個別項目は度数と中央値(四分位範囲)で示してWMW検定で比較し、尺度得点は平均値(標準偏差)と中央値(四分位範囲)で示してWelchのt検定を主解析、WMW検定を感度分析とし、5つの項目レベルの比較にはHolm法を使った、という流れです。
Responses to the individual items (6-point scale: 1 = very inaccurate, 6 = very accurate) are presented as frequencies and as medians with interquartile ranges, and were compared between men and women with the Wilcoxon-Mann-Whitney test (two-sided; normal approximation with continuity correction because of ties). The five-item neuroticism score was calculated as the mean of items N1 to N5 (possible range 1 to 6); its internal consistency was assessed with Cronbach’s alpha. The score is presented as mean (SD) and median (IQR) and was compared between groups with Welch’s t-test (mean difference, 95% CI; Cohen’s d); the Wilcoxon-Mann-Whitney test, with the probability of superiority, was used as a sensitivity analysis. P values for the five item-level comparisons were adjusted with the Holm method. Analyses were performed in R version 4.3.3 (stats; psych 2.4.1; effsize 0.8.1; brunnermunzel 2.0).
ご自身の計画に合わせて調整してください。計画で順位に基づく検定を主解析と定めている場合は、役割を入れ替え、文の順序はそのままにします。
Resultsの文例(実際の数値を使用)
Of 2,800 respondents (919 men, 1,881 women), 2,694 (889 men, 1,805 women) answered all five neuroticism items; Cronbach’s alpha was 0.81. The mean score was 3.27 (SD 1.21) in women and 2.95 (SD 1.14) in men (mean difference, women minus men, 0.32, 95% CI 0.23 to 0.42; Welch t-test P < 0.001; Cohen’s d = 0.27, 95% CI 0.19 to 0.35). The Wilcoxon-Mann-Whitney test gave the same conclusion (P < 0.001); the probability that a randomly chosen woman scored higher than a randomly chosen man was 0.57 (ties counted as half; Brunner-Munzel 95% CI 0.55 to 0.60). At item level, women’s responses were higher on four of the five items (Holm-adjusted P < 0.05); the difference was largest for “Panic easily” (median 3 [IQR 2 to 4] versus 2 [IQR 1 to 4]; A = 0.63; Holm-adjusted P < 0.001) and absent for “Often feel blue” (A = 0.50; P = 0.96).
この書き方がよい理由は、分母、信頼性、元の尺度での効果と区間、標準化した効果量、順位に基づく検定に対応する確率の効果量を示し、順位に基づく検定を中央値の比較と呼んでいないからです。
項目レベルの結果の表の形式
| Item | Men (n = 909 to 917), median [Q1, Q3] | Women (n = 1,854 to 1,872), median [Q1, Q3] | A (women > men) | Holm-adjusted P |
|---|---|---|---|---|
| N5 Panic easily | 2 [1, 4] | 3 [2, 4] | 0.63 | < 0.001 |
| N4 Often feel blue | 3 [2, 4] | 3 [2, 4] | 0.50 | 0.96 |
論文の表は英語で作るため、見出しは英語のままにしています。表の下の注記の文例(英語)は次のとおりです。
A = probability that a randomly chosen woman responds higher than a randomly chosen man, ties counted as half (Wilcoxon-Mann-Whitney statistic). P values from two-sided Wilcoxon-Mann-Whitney tests, Holm-adjusted across five items. Data: psych::bfi, R 4.3.3.
表のレイアウトは研究論文のテーブル(表)作成完全ガイド、図の凡例は図の凡例と表の脚注の書き方をご覧ください。
報告チェックリスト
- 項目の正確な文言、回答の選択肢、段階数(中間の選択肢が中立かどうかも)。
- 単一項目、尺度得点、またはその両方のどれを分析したか、およびその理由。
- 尺度得点では、どの項目を使ったか、逆転項目をどう扱ったか、自分の標本でのクロンバックのα。
- 回答の分布(度数、または発散型の棒グラフ)。平均値だけにしない。
- 項目では中央値(四分位範囲)、得点では平均値(標準偏差)。歪んでいれば中央値も。
- 各検定の名前、片側か両側か、ソフトウェアとそのバージョン。
- 信頼区間つきの効果量(平均値の差、Cohenのd、または確率的優越性)。
- 複数の項目やアウトカムの扱い(多重比較補正をご覧ください)。
6. よくある誤り
- 単一項目で平均値だけを報告する。まったく異なる回答パターンでも、平均値は同じになりえます(Bishop & Herron, 2015[文献6])。分布を示します。
- WMW検定を「中央値の比較」と呼ぶ。位置、形状、ばらつきをまとめて検定しています(Hart, 2001[文献5];Fagerland, 2012[文献3])。
- Rの「位置の差」を中央値の差として報告する。これはHodges-Lehmann推定量です(Rのドキュメント)。
- 複数の概念を扱う質問紙全体、または単一項目に対してαを算出する(Tavakol & Dennick, 2011[文献7])。
- 平均する前に、否定的な文言の項目の得点を逆転させ忘れる。
- 順序のある回答の平均値を、必要以上に多くの小数点以下の桁まで報告する(Sullivan & Artino, 2013[文献1])。
- P値を見てから検定を選ぶ。事前に規定し、頑健性を示したいなら感度分析を報告します。
- 大標本での極めて小さいP値を、大きな効果として扱う。区間つきで効果量を報告します。
- 同じ人の前後の回答に、対応のない検定を使う(SAMPL)。
- 単一のリッカート項目にピアソンの相関を、説明なしに使う。Bishop & Herron(2015)[文献6]は、CarifioとPerlaでさえ、ピアソンの相関に基づく分析は順序データへの耐性が高くないと認めていると述べています。代替のスピアマンの相関は相関係数とはをご覧ください。
査読者が指摘するそのほかの統計上の問題は、統計エラー10選と査読で統計を指摘されたらをご覧ください。
Editverse Japanがお手伝いできること
質問紙調査を計画中で、Methodsにどの要約方法と検定を書くか迷っている方へ
Editverse Japanの医学統計解析サポート(定額79,800円)では、研究デザインに合った統計手法の提案、記述統計と推測統計の解析、結果の読み取りと報告の支援、MethodsとResultsの記述の支援を行います。ジャーナルの要件に応じて、R、Stata、SPSS、SASに対応し、解析コードと結果報告書をお渡しします。納期の目安は、解析内容により5〜14営業日です。料金は原稿1本あたりで、修正の回数に上限はなく、不採択になった場合も、再投稿まで追加料金なしでサポートを継続します。最終的な内容と投稿の判断は著者の方にあります(ICMJE・COPEに準拠)。採択を保証するものではなく、採否はジャーナルが判断します。
回答の分布図など、ジャーナルの仕様に合わせた図の作成が必要な場合は、論文図表作成(14,800円。1図あたり3営業日。TIFF、EPS、PNG、PDFに対応。解像度・サイズ・カラーモードはジャーナルの指定に従います)をご覧ください。見積もりのご依頼時に、必要なグラフの種類をお知らせください。
まとめ
- 単一のリッカート項目は順序尺度です。回答の分布を示し、中央値(四分位範囲)を報告します。複数項目の得点は、通常は平均値(標準偏差)で報告し、自分の標本でのクロンバックのαを添え、分布が歪んでいれば中央値も示します。
- リッカート型データにパラメトリック検定を使ってよいかは、文献で意見が分かれています(Sullivan & Artino:使える、Norman:頑健、Bishop & Herron:慎重)。主解析をあらかじめ定め、その選択をMethodsで説明し、もう一方の系統の検定による感度分析も検討してください。
- WMW検定が比べるのは分布であり、中央値だけではありません。確率的優越性、または信頼区間つきの平均値の差と、効果量を報告します。
psych::bfiの2,694人では、5項目の神経症傾向の得点は女性3.27(標準偏差1.21)、男性2.95(標準偏差1.14)でした(差0.32、95%信頼区間 0.23〜0.42。Cohenのd = 0.27。A = 0.575)。t検定と順位に基づく検定は一致し、リサンプリング確認では、このデータでの2つの検定の検出力はほぼ同じでした。- 論文では、項目の文言と回答の選択肢、α、分布、各検定と片側・両側の別、信頼区間つきの効果量、多重性の扱い、Rのバージョンを書きます。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- 【統計的仮定の確認】正規性・等分散性の検証と論文記述
- 相関係数とは|求め方・ピアソンとスピアマンの違いと論文での書き方
- 【統計の書き方】論文における統計解析結果の報告方法
- 【多重比較補正】Bonferroni・Holm・FDRの選択と論文記述
- カイ二乗検定とFisher正確検定|論文での使い分けと報告例文
- ROC曲線とAUCの見方|カットオフ値の決め方と論文の書き方
- 有意差なしの書き方
- 因子分析の論文での書き方(因子数・因子負荷量・CFAの適合度)
- 連続データ・対応のあるデータ・3群以上の順位検定はノンパラメトリック検定の選び方
よくある質問
Q. リッカート尺度のデータは、平均値と中央値のどちらで報告しますか?
単一のリッカート項目では、回答の分布と、中央値および四分位範囲を報告します。平均値だけでは、まったく異なる回答パターンが隠れることがあります(Bishop and Herron, 2015)。複数項目から作った得点では、平均値と標準偏差が一般的ですが、Sullivan and Artino(2013)は、データが正規分布に近くない限り平均値の価値は限られると述べているため、分布も併せて示してください。事前に決め、その選択をMethodsで説明します。
Q. リッカート尺度のデータにt検定を使ってよいですか?
使えるとする方法論の専門家は多くいます。Norman(2010)は、1930年代にさかのぼる研究から、パラメトリック統計はリッカート型データに頑健だと結論づけ、Sullivan and Artino(2013)も、リッカート尺度の回答の分析にパラメトリック検定を使うことはできると結論づけています。一方、Bishop and Herron(2015)のように、特に単一項目やピアソン型の分析では慎重さを求める立場もあります。1つの検定を主解析に事前に定め、もう一方を感度分析として実施する方法が妥当です。本文の実例では、どちらもPが0.001未満でした。
Q. 単一のリッカート項目を2群で比べるには、どの検定を使いますか?
独立した2群の順序データの比較には、Wilcoxon-Mann-Whitney検定(マン・ホイットニーのU検定)がよく使われ、Fagerland(2012)は順序データの分析に最も有用な検定だと述べています。Sullivan and Artino(2013)によれば、順序データにはこの検定を使うべきだと主張してきた専門家がいる一方、パラメトリック検定を使えるとする専門家もいます。結果は、中央値の差ではなく分布の比較として、確率的優越性とともに報告してください。2群が位置のずれだけで異なると説明できる場合を除き、「中央値の差」とは書きません(Hart, 2001)。
Q. クロンバックのαは必要ですか?
複数の項目を合計または平均して1つの得点にする場合、項目が十分に相関し、同じ概念を測っていることの根拠として、クロンバックのαや因子分析を示すよう専門家は勧めており(Sullivan and Artino, 2013)、査読者から求められることもあります。αは自分の標本で、概念ごとに別々に算出し、αが高くても単一の概念を測っている証明にはならない点に注意してください(Tavakol and Dennick, 2011)。
Q. 標本サイズが小さい場合はどうしますか?
ノンパラメトリック検定は、t検定の代替として使う場合、小規模な研究で最も有用です(Fagerland, 2012)。Sullivan and Artino(2013)は、データがほぼ正規分布していれば、群あたり少なくとも5〜10観測でパラメトリック検定を認める専門家もいると述べています。本文の実データでのリサンプリング確認(群あたりn = 20)では、t検定とWilcoxon-Mann-Whitney検定の検出力と誤り率は非常に近い値でしたが、この確認は1つのデータだけが対象です。標本が非常に小さい場合は、データを集める前に統計の専門家と検定の選択を相談してください。
参考資料
PubMed収載の文献(題名・著者・雑誌・年・巻・ページ・DOIは、2026年10月6日にNCBI E-utilitiesのesummaryで確認)
- Sullivan GM, Artino AR Jr. Analyzing and interpreting data from Likert-type scales. J Grad Med Educ. 2013 Dec;5(4):541-542. doi: 10.4300/JGME-5-4-18. PMID: 24454995.(全文:PMC3886444)
- Norman G. Likert scales, levels of measurement and the “laws” of statistics. Adv Health Sci Educ Theory Pract. 2010 Dec;15(5):625-632. doi: 10.1007/s10459-010-9222-y. PMID: 20146096.(抄録のみ確認。本文での記述は抄録の範囲にとどめています)
- Fagerland MW. t-tests, non-parametric tests, and large studies–a paradox of statistical practice? BMC Med Res Methodol. 2012 Jun 14;12:78. doi: 10.1186/1471-2288-12-78. PMID: 22697476.(全文:PMC3445820)
- Fagerland MW, Sandvik L. The Wilcoxon-Mann-Whitney test under scrutiny. Stat Med. 2009 May 1;28(10):1487-1497. doi: 10.1002/sim.3561. PMID: 19247980.(抄録のみ確認。本文での記述は抄録の範囲にとどめています)
- Hart A. Mann-Whitney test is not just a test of medians: differences in spread can be important. BMJ. 2001 Aug 18;323(7309):391-393. doi: 10.1136/bmj.323.7309.391. PMID: 11509435.(全文:PMC1120984)
- Bishop PA, Herron RL. Use and misuse of the Likert item responses and other ordinal measures. Int J Exerc Sci. 2015;8(3):297-302. doi: 10.70252/LANZ1453. PMID: 27182418.(全文:PMC4833473)
- Tavakol M, Dennick R. Making sense of Cronbach’s alpha. Int J Med Educ. 2011 Jun 27;2:53-55. doi: 10.5116/ijme.4dfb.8dfd. PMID: 28029643.(全文:PMC4205511)
- Lang TA, Altman DG. Basic statistical reporting for articles published in biomedical journals: the “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. Int J Nurs Stud. 2015 Jan;52(1):5-9. doi: 10.1016/j.ijnurstu.2014.09.006. PMID: 25441757.(SAMPLの文言は、下記のEQUATOR Network掲載版から引用)
ガイドライン・ソフトウェア・データ
- EQUATOR Network. SAMPL Guidelines(Lang and Altman):EQUATOR Network: SAMPL Guidelines (PDF)
- R Core Team.
stats::wilcox.testのRドキュメント(R 4.3.3):同順位があるときの挙動、位置のずれという帰無仮説、Hodges-Lehmann推定量について - Revelle W.
psychパッケージ(2.4.1)のbfi(データの説明、回答の尺度、採点キー)とalphaのヘルプ brunnermunzelパッケージ(2.0)のドキュメント:2標本の確率的等価性の検定effsizeパッケージ(0.8.1)のドキュメント:cohen.d、VD.A- データとコードは、R 4.3.3(stats、psych 2.4.1、effsize 0.8.1、brunnermunzel 2.0、ggplot2 4.0.3、ragg 1.5.2)で計算・作図