ファンネルプロットとは?出版バイアスとEgger検定を実例解説
ファンネルプロット(funnel plot)は、メタアナリシスに含まれる各研究の効果推定値を横軸に、その精度(通常は標準誤差)を縦軸にとった散布図です。小規模な研究は図の下部に大きく散らばり、大規模な研究は上部に集まるため、漏斗(ファンネル)のような形になります。点の分布が左右非対称な場合、たとえば小規模な研究が大きな効果ばかりを示している場合は、小規模研究効果(small-study effects)を疑うサインです。ただし、出版バイアス(publication bias)はその原因の一つにすぎません。本記事では、BCGワクチン13試験の実データを使ってファンネルプロットを順を追って読み解き、RでEgger検定とtrim-and-fill法を実行し、論文での報告のしかたまでを解説します。
用語について:日本の公衆衛生分野では、「ファンネルプロット」は施設ごとの指標を分母の大きさと比べる別の図を指すこともあります(例:国立がん研究センターが公開しているがん検診のプロセス指標のファンネルプロット)。本記事で扱うのは、メタアナリシスのファンネルプロットです。
ファンネルプロットとは?何を示し、なぜ漏斗の形になるのか
メタアナリシスの各研究は、リスク比、オッズ比、平均差など同じ量を、それぞれ異なる精度で推定しています。大規模な試験は標準誤差が小さいため、推定値は真の効果の近くに集まります。小規模な試験は標準誤差が大きいため、偶然だけでも推定値が広く散らばります。効果量を横軸に、標準誤差を縦軸に(最も精度の高い研究が上に来るよう軸を反転して)とると、点は統合推定値を中心に、左右対称の逆さまの漏斗を形作るはずです。
| 図の要素 | 意味 | 確認するポイント |
|---|---|---|
| 横軸 | 効果推定値。比の指標(RR、OR、HR)では効果量(リスク比・オッズ比)を対数目盛で示し、RR 0.5とRR 2が1から等距離になるようにする | 軸は対数目盛か。RRを線形目盛で描くとファンネルがゆがむ |
| 縦軸 | 標準誤差(反転し、0が上)。ソフトウェアによっては精度(1/SE)や標本サイズを使う | 最も一般的なのはSE(metaforの既定)。軸によって形が変わるため、どれを使っているかを確認する |
| 縦線 | 統合推定値 | 固定効果モデルと変量効果モデルのどちらによる値か |
| 斜めの線 | 擬似95%信頼限界(pseudo 95% limits):統合推定値 ± 1.96 × SE | 異質性がない場合、約95%の研究がこの内側に入る |
| 点の集まり | 1点が1研究 | 縦線を中心に左右対称か。下側の片隅に空白がないか |
ファンネルプロットとフォレストプロットの違いを、それぞれ1行で示します(フォレストプロットの読み方はメタアナリシスの手順とフォレストプロットの読み方で解説しています)。
| 図 | 答える問い |
|---|---|
| フォレストプロット | 各研究は何を示し、統合した効果はどれくらいか |
| ファンネルプロット | 小規模な(精度の低い)研究は、大規模な研究と系統的に異なる効果を示していないか |
検索上位の日本語解説のいくつかでは触れられていない、実務上の重要点が2つあります。
- ファンネルプロットは、研究数が十分にあって初めて機能します。Cochrane Handbookの目安では、ファンネルプロットの非対称性の検定は、メタアナリシスに10研究以上が含まれる場合に限って用いるべきとされています(第13章、13.3.4.4)。5〜6研究では、「対称」「非対称」という見た目はほとんどノイズです。
- 非対称性は診断ではありません。Cochrane Handbook(表13.3.b)は、ファンネルプロットが非対称になる理由を5つのグループに整理しています。出版バイアスを含む非報告バイアス(non-reporting biases)、小規模研究の方法論的な質の低さによる効果の過大評価、真の異質性、見かけ上の原因(一部の効果指標では推定値と標準誤差が数学的に相関する)、そして偶然です。方法論の専門家が「小規模研究効果」という中立的な用語を好むのはこのためです。
出版バイアスと小規模研究効果
出版バイアスは、研究が出版されるかどうか(あるいは出版の速さ、掲載先、形式)がその結果に左右されるときに生じます。結果が無効あるいは不利な小規模研究が「お蔵入り」になり、目立つ結果を示した小規模研究だけが出版されると、出版された小規模研究は大きな効果の側に偏ります。その結果、ファンネルの「効果なし」側の下隅が空白になります。GRADEワーキンググループは、出版バイアスをエビデンスの確実性を下げる理由の一つに挙げています。そのうえで、ファンネルプロットはその検討に最もよく使われる方法である一方、こうした方法はいずれも「大きな限界がある(have substantial limitations)」と述べています(Guyatt et al., 2011)。
PRISMA 2020の報告項目では、この評価が独立した項目になっています。項目14は「統合における欠測結果によるバイアスリスク(報告バイアスに起因するもの)を評価するために用いた方法を記述する」こと、項目21は「評価した各統合について、欠測結果によるバイアスリスクの評価を示す」ことを求めています(Page et al., 2021。日本語訳は当サイトによる)。
実例:BCGワクチン13試験のファンネルプロットをRで解析する
Rパッケージmetaforに付属するデータセットdat.bcgを使います。結核に対するBCGワクチン接種の臨床試験13件(1948〜1980年に発表、参加者は合計357,347人)の2×2表を収録したもので、Colditzら(JAMA, 1994)のメタアナリシスに基づいています。結果がよく知られており、誰でも再現できるため、教育用の標準的なデータセットとして使われています。
1. メタアナリシスを実行する
library(metafor)   # バージョン 5.0-1、R 4.3.3
dat <- escalc(measure = "RR", ai = tpos, bi = tneg,
              ci = cpos, di = cneg, data = dat.bcg)   # 対数リスク比
res <- rma(yi, vi, data = dat, method = "REML")     # 変量効果モデル
predict(res, transf = exp)                          # リスク比の尺度に戻す
実際の出力(丸めた値)は次のとおりです。
| 項目 | 値 |
|---|---|
| 研究数(k) | 13 |
| 統合リスク比(変量効果、REML) | 0.49(95% CI 0.34–0.70)、p < 0.0001 |
| 95%予測区間 | 0.16–1.55 |
| τ² / I² | 0.313 / 92.2% |
| CochranのQ | 152.23(df = 12)、p < 0.0001 |
BCGワクチン接種は、平均すると結核のリスクをおよそ半分にします。しかし異質性(heterogeneity)は極めて大きく、95%予測区間(prediction interval)は強い予防効果から効果なしまで広がっています(信頼区間と予測区間の違いは95%信頼区間の読み方を参照)。この点はファンネルプロットの読み方に関わるので、覚えておいてください。
2. 等高線付きファンネルプロットを描く
通常のファンネルプロットが示すのは対称性だけです。等高線付きファンネルプロット(contour-enhanced funnel plot)は、個々の研究が統計的に有意になる領域(p < 0.01、0.01–0.05、0.05–0.10)と、有意でない領域(p ≥ 0.10)を濃淡で塗り分けます。Petersら(2008)がこの図を提案したのは、「欠けている」ように見える研究がどこに位置するはずかを読者が判断できるようにするためです。空白が有意でない(白い)領域にあれば出版バイアスの可能性が高まり、有意性の高い領域にあれば、非対称性の他の原因が考えやすくなります。
funnel(res, level = c(90, 95, 99), shade = c("white", "gray55", "gray75"),
       refline = 0, legend = TRUE, atransf = exp)   # metafor組み込みの等高線付きファンネルプロット。atransfで軸をRR表示にする
(図1は、読みやすさのために同じ値をggplot2で描き直したものです。上のmetaforのコードでも、同等のベースRの図が得られます。)
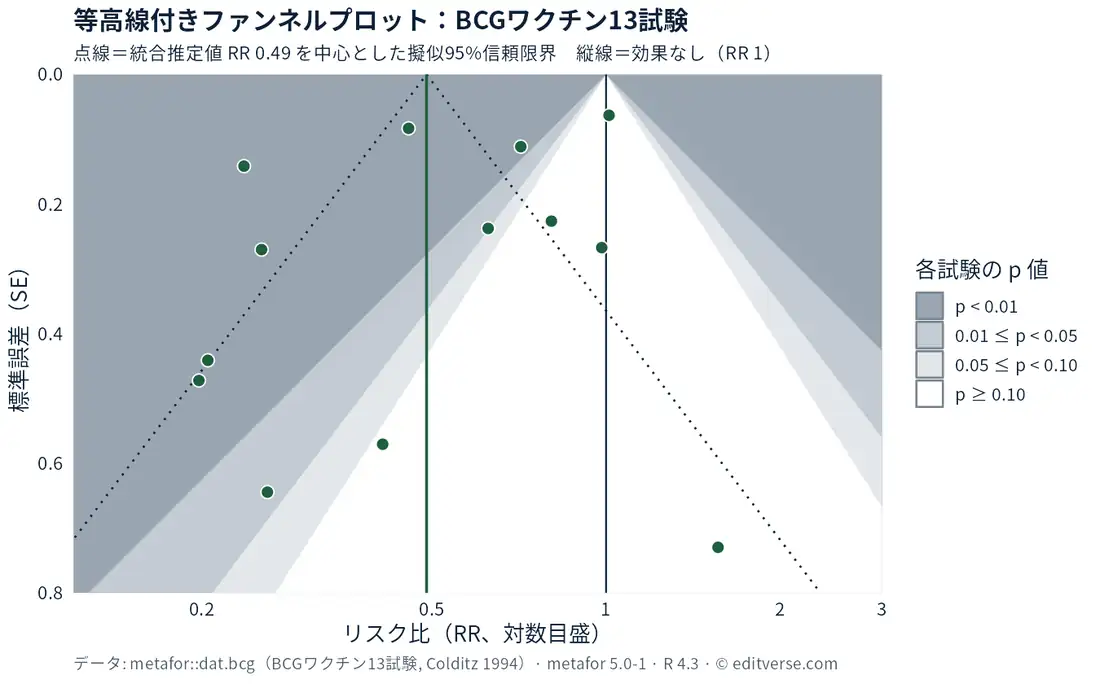
読み方:白い「有意でない」領域は空ではなく、最大の試験を含む13試験中5試験がそこにあります。典型的な「お蔵入り(file drawer)」のパターンには見えません。
図1は、次の3つの手順で読みます。
- 領域ごとに点を数える。p < 0.01が6試験、0.01 ≤ p < 0.05が2試験、0.05 ≤ p < 0.10は0試験、p ≥ 0.10が5試験です(各試験の対数RRとSEから算出)。
- 大規模な試験の位置を確認する。最も精度の高い試験(TPT Madras、SE 0.063)は、有意でない領域の、ほぼRR 1の線上にあります。出版バイアスが隠しがちなのは、まさに大規模で効果のなかった試験です。ここでは、その試験が存在しています。
- 対称性だけでなく、広がりを確認する。多くの点が、左右両側で点線の擬似95%信頼限界の外にあります。I² = 92%は、ファンネルプロット上ではこのように見えます。散らばりは標本誤差だけで生じる範囲よりはるかに広く、これほど異質な研究に基づくファンネルでは、非対称性を読み取ること自体が困難です。
3. Egger検定を実行する
Eggerら(1997)は、各研究の標準化した効果を精度に回帰し、切片が0から大きく離れていれば非対称性を示すという方法で、ファンネルの非対称性を測ることを提案しました(Egger検定、Egger’s regression test)。metaforでは、古典的なEgger検定は重み付き回帰版(model = "lm")です。パッケージの既定は、SEを予測変数とする混合効果メタ回帰です。どちらを使ったかを必ず報告してください。
regtest(res, model = "lm")                          # 古典的なEgger検定
regtest(res)                                        # metaforの既定:混合効果、予測変数 = SE
ranktest(res)                                       # Begg & Mazumdarの順位相関検定
regtest(res, model = "lm", predictor = "sqrtninv") # 1/sqrt(n)を予測変数とする重み付き回帰日本語のRチュートリアルの多くは、metaforではなくmetaパッケージを使っています。metaで同じ検定を行う場合は次のとおりです(meta 8.5-0)。
library(meta)
m <- metabin(tpos, tpos + tneg, cpos, cpos + cneg, data = dat.bcg,
             sm = "RR", method = "Inverse", method.tau = "REML", common = FALSE)
metabias(m, method.bias = "Egger")    # t = -1.40, p = 0.189(metaforと同一)
metabias(m, method.bias = "Harbord")  # 二値アウトカム用のスコアに基づく検定
metabias(m, method.bias = "Peters")   # 予測変数は総標本サイズの逆数
実際の出力は次のとおりです。
| 検定(同じ13試験) | ソフトウェア | 統計量 | p値 |
|---|---|---|---|
| Egger検定・古典的(重み付き回帰、予測変数SE) | metafor / meta(同一) | t = −1.40、df = 11 | 0.189 |
| 混合効果メタ回帰、予測変数SE(metaforの既定) | metafor | z = −0.80 | 0.422 |
| Begg & Mazumdarの順位相関 | metafor | Kendallのτ = 0.026 | 0.952 |
| Harbord検定(Harbord et al., 2006) | meta | t = −1.05、df = 11 | 0.318 |
| Peters検定(Peters et al., 2006)、予測変数1/N | meta | t = −1.27、df = 11 | 0.230 |
| 重み付き回帰、予測変数1/√n(独自の変法で、発表されたPeters検定ではない) | metafor | t = −2.63、df = 11 | 0.024 |
| 混合効果、予測変数SE、緯度で調整後 | metafor | z = −0.60 | 0.549 |
この表から、次のことが読み取れます。
- 主な答え:古典的なEgger検定ではp = 0.19で、ファンネルの非対称性を示す統計的に有意な証拠はありません。
- 「有意でない」は「バイアスがない」ではありません。これらの検定は、研究数が少ないと検出力が限られます(P値の正しい解釈も参照)。BeggとMazumdar(1994)は、25研究でも自らの順位検定の検出力は中程度にとどまることを示し、「検定が有意でなくても、バイアスは否定できない(bias cannot be ruled out if the test is not significant)」と警告しています。13研究は、Cochraneの最低基準である10研究をわずかに上回るにすぎません。
- 検定の選び方で答えが変わります。発表された検定は、ここではすべて同じ結論です(p = 0.19〜0.95)。しかし予測変数を1/√nとした独自の変法では、同じデータでp = 0.024になります。非対称性の検定(とその予測変数)を、解析の前にプロトコルで定めておくべき理由はここにあります。そうしなければ、結果を見てから検定を選んだのではないかと、査読者にもっともな質問をされることになります。Cochrane Handbook(13.3.4.4)は、元のEgger検定を含む一部の検定は、効果量と標準誤差の見かけ上の相関があるため、オッズ比と標準化平均差には推奨されないとしています。そしてオッズ比については、HarbordらとPetersらが提案した方法がこの問題を克服していると述べています。
- 診断精度研究のレビューは別に考えます。感度・特異度(診断オッズ比)のメタアナリシスについて、Deeksら(2005)はシミュレーションにより、典型的な診断オッズ比ではBegg、Egger、Macaskillの検定の第1種の過誤率が高くなること、有効標本サイズに基づく検定は妥当であることを示しました。診断精度研究(DTA)のレビューでは、これが「Deeksのファンネルプロット非対称性検定」として登場します。
- 他の方法もあります。選択モデル(selection models)やPET-PEESEなどは、それぞれ異なる方法で欠けた研究をモデル化したり補正したりしようとするものです。いずれも独自の仮定に基づいており、次のtrim-and-fill法と同様に、感度分析として扱うのが適切です。
4. Trim-and-fill法:調整した推定値であり、補正された「真の値」ではない
DuvalとTweedie(2000)が提案したtrim-and-fill法は、ファンネルの片側から「欠けている」とみられる研究の数を順位に基づいて推定し、その鏡像を補完して統合推定値を計算し直す方法です。
tf <- trimfill(res)          # 既定:L0推定量、補完する側はデータから選択
tf
predict(tf, transf = exp)
funnel(tf)                   # 補完された研究は白抜きの円で表示
読み方:metaforの既定の設定では、仮想的な「欠けた」試験を1件補っても、推定値はほとんど動きません。ただし次の表のとおり、他の妥当な設定では推定値ははるかに大きく動きます。
妥当な設定ごとの実際の出力は次のとおりです。
| ソフトウェア・モデル・推定量 | 補完された研究数(その数のSE) | trim-and-fill前の統合RR | trim-and-fill後の統合RR |
|---|---|---|---|
metafor trimfill()、変量効果(REML)、L0(既定) |
1(SE 2.45)、右側 | 0.49(0.34–0.70) | 0.52(0.37–0.74) |
| metafor、固定効果、L0 | 4(SE 2.39)、右側 | 0.65(0.60–0.70) | 0.75(0.69–0.81) |
| metafor、変量効果(REML)、R0 | 0(p = 0.50) | 0.49(0.34–0.70) | 変化なし |
meta trimfill()の既定(トリミングは共通効果モデル ma.common = TRUE、統合は変量効果) |
4 | 0.49(0.34–0.70) | 0.71(0.46–1.10)、p = 0.12 |
「欠けた」研究の数は、ソフトウェアの既定値、モデル、推定量によって0から4まで変わります。その数の標準誤差も約2.4と大きく(metaforの既定では補完数1に対してSE 2.45)、補完数の推定自体がきわめて不確実です。最も注目すべきなのは、広く使われている2つのRパッケージが、既定の設定で異なる答えを出すことです。metaforは1研究を補完し、統合RRは0.52(0.37–0.74)にとどまります。一方、metaは4研究を補完し、調整後の変量効果の信頼区間は1をまたぎます(0.46–1.10)。(metaでma.common = FALSEと設定すると、metaforの結果が再現されます:1研究、RR 0.52。)
ソフトウェア、トリミングに用いたモデル、推定量は必ず報告してください。trim-and-fill法は、「非対称性が欠けた研究によるものだとしたら、結論はどれだけ動くか」を問う感度分析(sensitivity analysis)として扱い、真の効果とはみなさないでください。補完された試験は仮想的なものであり、実在する研究として記述してはいけません。
5. BCGのファンネルが広い理由:欠けた研究だけでなく、異質性
BCGの試験は、赤道からの距離が大きく異なる地域で行われました。緯度の絶対値を調整変数(moderator)として加えると、異質性の多くが説明されます。
rma(yi, vi, mods = ~ ablat, data = dat, method = "REML")| 緯度によるメタ回帰 | 値 |
|---|---|
| 傾き(緯度1度あたりの対数RR) | −0.029(95% CI −0.043〜−0.015)、p < 0.0001 |
| 緯度1度あたりのRRの倍率 | 0.971 |
| 残差I² | 68.4%(92.2%から低下) |
| 説明された異質性(R²) | 75.6% |

読み方:赤道から離れた地域の試験ほど予防効果が大きく、ファンネルの散らばりの多くは、欠けた研究ではなく、実施環境の本当の違いを反映しています。
これは、Cochraneの一覧にある「真の異質性」という原因を、目に見える形にしたものです。メタアナリシスの小規模な試験が、たまたま効果が本当に大きい環境で行われていれば、出版バイアスがまったくなくてもファンネルは非対称に見えます。ファンネルプロットは問いを立てることはできますが、その問いに答えられるのは、研究そのものについての知識(デザイン、対象集団、実施環境、バイアスリスク、資金源、試験登録)だけです。
自分のメタアナリシスで出版バイアスを評価する手順
| 段階 | 行うこと | 査読者が重視する理由 |
|---|---|---|
| プロトコル(検索の前) | 事前に定める:10研究以上の場合にファンネルプロットを作成すること、用いる非対称性の検定とその予測変数、感度分析としてtrim-and-fill法などを使うかどうか | 「検定の選り好み」を防ぐ(上のp = 0.19とp = 0.024の例を参照) |
| 検索 | データベースに加えて、試験登録と灰色文献も検索する(例:WHO ICTRP、日本の試験であればjRCTとUMIN-CTR)。登録されたアウトカムと出版されたアウトカムを比較する(検索全体の流れはシステマティックレビューのやり方を参照) | 欠測結果への最善の対策は、モデルで補うことではなく、見つけ出すこと |
| 解析 | 等高線付きファンネルプロット、事前に定めた検定、感度分析としてのtrim-and-fill法など。異質性は別に探索する。ソフトウェアと設定を明記する(R metafor/meta、Stata、SPSS。SPSSのメタアナリシスのダイアログにはファンネルプロットのタブがあります) | 出版バイアスの可能性を他の原因と区別できる。パッケージによって既定値が異なる(上の4を参照) |
| 解釈 | 研究数、検定の結果、検出力の限界、別の説明を記述する | 8研究で「非対称性なし」は安心材料にならない |
| エビデンスの確実性 | 判断をGRADE(出版バイアスの領域)に反映させる | GRADEでは、出版バイアスが疑われる場合に確実性を下げることができる |
| 報告 | PRISMA 2020の項目14と21。ファンネルプロットは本文または補足資料に掲載する | 編集者はチェックリストに記載されたページ番号を確認する |
研究数が10未満の場合は、検定を行わないでください。その旨をMethodsに記載し(英文例:「Funnel plots and tests for small-study effects were planned only if ≥10 studies contributed to a meta-analysis」、和訳:「ファンネルプロットと小規模研究効果の検定は、10研究以上が寄与するメタアナリシスに限って行う計画とした」)、欠測結果のリスクは定性的に考察します。たとえば、見つかった登録試験がすべて結果を報告しているかどうかを確認します。
論文での書き方とよくある誤り(BCGの数値を使った例文)
Methodsの英文例
Small-study effects were assessed by visual inspection of contour-enhanced funnel plots and by Egger’s regression test (weighted regression with the standard error as predictor) when at least 10 studies contributed to an analysis. As a sensitivity analysis, the trim-and-fill method (L0 estimator, with trimming and pooling based on the random-effects model) was used to estimate the pooled effect after imputation of potentially missing studies. Analyses were performed in R 4.3.3 with the metafor package (version 5.0-1).
和訳:小規模研究効果は、10研究以上が寄与する解析について、等高線付きファンネルプロットの目視とEggerの回帰検定(標準誤差を予測変数とする重み付き回帰)により評価した。感度分析として、trim-and-fill法(L0推定量、トリミングと統合はいずれも変量効果モデルに基づく)を用い、欠けている可能性のある研究を補完した後の統合効果を推定した。解析はR 4.3.3とmetaforパッケージ(バージョン5.0-1)で行った。
Resultsの英文例
The funnel plot for tuberculosis incidence (13 trials) showed no clear asymmetry, and Egger’s test did not indicate small-study effects (t = −1.40, df = 11, p = 0.19). Trim-and-fill imputed one study, and the adjusted pooled risk ratio (0.52, 95% CI 0.37–0.74) was similar to the primary estimate (0.49, 95% CI 0.34–0.70); when trimming was based on a common-effect model, four studies were imputed and the adjusted risk ratio was 0.71 (95% CI 0.46–1.10). Given the small number of trials and substantial heterogeneity (I² = 92%), which was partly explained by latitude, these tests have limited power and publication bias cannot be excluded.
和訳:結核発生率のファンネルプロット(13試験)に明らかな非対称性はなく、Egger検定でも小規模研究効果は示されなかった(t = −1.40、df = 11、p = 0.19)。trim-and-fill法では1研究が補完され、調整後の統合リスク比(0.52、95% CI 0.37–0.74)は主解析の推定値(0.49、95% CI 0.34–0.70)と同程度であった。トリミングを共通効果モデルに基づいて行った場合は4研究が補完され、調整後のリスク比は0.71(95% CI 0.46–1.10)であった。試験数が少なく、緯度で一部が説明される大きな異質性(I² = 92%)があることから、これらの検定の検出力は限られており、出版バイアスは否定できない。
このResultsの段落が書いていないことに注目してください。「出版バイアスはなかった」とは書かず、安心材料にならないtrim-and-fillの設定も隠さずに報告しています。「There was no publication bias(出版バイアスはなかった)」という書き方は、このセクションで査読者がよく指摘する言い過ぎです。
日本語の抄録・学位論文での書き方
日本語の抄録や学位論文では、Methodsは次のように書くのが一般的です:「出版バイアスは、10研究以上を含む解析について、ファンネルプロットの目視とEggerの回帰検定により評価した」。
研究数7件で「出版バイアスを評価してください」と査読者に求められたら
協調的な回答としては、Cochrane Handbookの10研究ルールを説明し、透明性のために正式な検定は行わずにファンネルプロットを補足資料に示し、未発表研究を探すために行ったこと(試験登録、学会抄録、著者への問い合わせ)を記述します。統計に関する査読コメントへの答え方は、査読で統計を指摘されたらも参考にしてください。
投稿されたメタアナリシスでよく見る7つの誤り
統計全般の誤りは査読で指摘される統計エラーにまとめています。ここでは、投稿されたメタアナリシスで私たちがよく目にする誤りを挙げます。
- 4〜6研究でEgger検定を行い、「出版バイアスなし(p = 0.42)」と報告している。
- 非対称性を出版バイアスと同一視し、Discussionで異質性、研究の質、偶然を検討していない。
- RRやORを線形目盛で描き、対称なファンネルを非対称に見せている。
- 検定の種類やソフトウェアを明記していない(古典的なEgger検定か混合効果か、オッズ比でHarbordやPetersを使ったか、予測変数はSEか1/nか、metaforとmetaのどちらのtrim-and-fillの既定値か)。
- trim-and-fill法の推定値を「真の」効果や「補正された」効果として報告している、あるいは補完した研究を実在する研究のように記載している。
- 異なるアウトカムやデザインを統合したメタアナリシスで1つのファンネルプロットを描き、無関係な変動の要因を混ぜてしまっている。
- PRISMA 2020の項目14と21を省略している、あるいはページ番号を書かずにチェックだけ入れている。
採用研究と抽出データはそろっていて、解析をきちんと仕上げたい方へ
メタアナリシス支援では、効果量の算出、モデルの選択、異質性と感度分析、等高線付きファンネルプロット、事前に定めた小規模研究効果の検定、trim-and-fill法、Methods・Resultsの記述まで対応し、解析を完全に再現できるRコードも納品します。結果の解釈と結論は研究者ご自身のものです。私たちは、数値とその報告が正確であることを確認します。
メタアナリシス支援(¥198,000):原稿1本単位のお申し込みで、アクセプトまで追加料金なしでサポートを継続します(採否はジャーナルが判断します)。
研究課題の段階から依頼する場合:系統的レビュー・メタアナリシス完全制作(¥448,000)
投稿済みの論文で、査読者から出版バイアスの解析を求められた場合:査読対応・統計再解析(¥98,000)
まとめ
- ファンネルプロットは、各研究の効果(比の指標は対数目盛)を標準誤差に対してプロットした図です。小規模研究効果がなければ、点は左右対称のファンネルを形作ります。
- 非対称性は小規模研究効果のサインです。出版バイアスはその原因の一つで、異質性、小規模研究の質の低さ、効果指標による見かけ上の相関、偶然も原因になります。
- 正式な検定は10研究以上の場合に限って用い、どの検定を使うかを事前に定めてください。有意でない結果は、バイアスがないことを意味しません。
- BCGの例(13試験)では、古典的なEgger検定はp = 0.19(Harbord検定とPeters検定も同じ結論)で、緯度が異質性の約4分の3を説明しました。つまりファンネルの広さの大部分は、実施環境の本当の違いを反映しています。一方、trim-and-fill法はソフトウェアの既定値に左右されました。metaforは1研究を補完し(RR 0.49→0.52)、metaは4研究を補完しました(RR 0.71、信頼区間は1をまたぐ)。設定を明記したうえで、感度分析として報告すべきことを示す例です。
- 方法と結果はPRISMA 2020の項目14と21に沿って報告し、その判断をGRADEに反映させてください。
公費・研究費でのお支払いについて
見積書・納品書・請求書を発行し、科研費・AMED・JSTなどの研究費でのお支払いに対応しています。前払いは不要です。詳しくは公費・研究費でのお支払いをご覧いただくか、お問い合わせください。
よくあるご質問
ファンネルプロットやEgger検定を使うには、研究は何件必要ですか?
Cochrane Handbookの目安では、ファンネルプロットの非対称性の検定には10研究以上が必要です。研究数がそれより少ないと検定の検出力が足りないため、評価は実施できなかったと報告し、欠測結果のリスクを定性的に考察してください。
ファンネルプロットが非対称なら、出版バイアスがあると証明されたことになりますか?
いいえ。非対称性が示すのは小規模研究効果であり、真の異質性、小規模研究の方法論的な質の低さ、効果指標による見かけ上の相関、偶然によっても生じます。等高線付きファンネルプロットを使うと、見かけ上の空白が有意でない領域にあるかどうかを判断しやすくなります。有意でない領域に空白がある場合は、出版バイアスの可能性が高まります。
Egger検定が有意でなければ、「出版バイアスはなかった」と書いてよいですか?
特に研究数が少ない場合は、「検定では小規模研究効果は示されなかったが、出版バイアスは否定できない」と書くほうが安全です。検出力の低い検定で有意にならなかったことは、バイアスがないことの証拠にはなりません。
trim-and-fill法の推定値を主な結果として報告すべきですか?
いいえ。trim-and-fill法は感度分析です。本記事のBCGの例では、補完された研究の数はソフトウェアの既定値・モデル・推定量によって0から4まで変わりました(調整後のRRは0.52から0.71)。調整後の推定値は真の効果ではなく、結論がどれだけ変わりうるかを示すものです。
出版バイアスに関係するPRISMA 2020の項目はどれですか?
項目14(欠測結果によるバイアスリスクの評価に用いた方法)と項目21(各統合についての評価結果)です。この判断は、エビデンスの確実性の評価(項目22、例:GRADE)にも反映されます。
関連記事
- 系統的レビュー・メタアナリシス支援
- メタアナリシスとは?手順・フォレストプロットの読み方・よくある誤り
- システマティックレビューとは?やり方を8ステップで解説
- PRISMA声明でシステマティックレビューを正しく報告する方法
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 信頼区間の解釈|95% CIの正しい意味と論文での報告方法
- 臨床研究文書支援
- 研究の選別(スクリーニング)の手順と記録
- 検索の網羅性を支えるPubMed検索式の作り方
- GRADEシステムの5つの格下げ領域と、論文での確実性の書き方
参考資料
- Egger M, Davey Smith G, Schneider M, Minder C. Bias in meta-analysis detected by a simple, graphical test. BMJ. 1997;315(7109):629-34. PMID: 9310563. DOI: 10.1136/bmj.315.7109.629
- Duval S, Tweedie R. Trim and fill: A simple funnel-plot-based method of testing and adjusting for publication bias in meta-analysis. Biometrics. 2000;56(2):455-63. PMID: 10877304. DOI: 10.1111/j.0006-341x.2000.00455.x
- Peters JL, Sutton AJ, Jones DR, Abrams KR, Rushton L. Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry. J Clin Epidemiol. 2008;61(10):991-6. PMID: 18538991. DOI: 10.1016/j.jclinepi.2007.11.010
- Begg CB, Mazumdar M. Operating characteristics of a rank correlation test for publication bias. Biometrics. 1994;50(4):1088-101. PMID: 7786990. DOI: 10.2307/2533446(DOIはCrossRefによる)
- Colditz GA, Brewer TF, Berkey CS, Wilson ME, Burdick E, Fineberg HV, Mosteller F. Efficacy of BCG vaccine in the prevention of tuberculosis. Meta-analysis of the published literature. JAMA. 1994;271(9):698-702. PMID: 8309034. DOI: 10.1001/jama.1994.03510330076038(CrossRefによる)
- Page MJ, McKenzie JE, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, Shamseer L, Tetzlaff JM, Akl EA, Brennan SE, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71. PMID: 33782057. DOI: 10.1136/bmj.n71
- Guyatt GH, Oxman AD, Montori V, Vist G, Kunz R, Brozek J, Alonso-Coello P, Djulbegovic B, Atkins D, Falck-Ytter Y, et al. GRADE guidelines: 5. Rating the quality of evidence–publication bias. J Clin Epidemiol. 2011;64(12):1277-82. PMID: 21802904. DOI: 10.1016/j.jclinepi.2011.01.011
- Harbord RM, Egger M, Sterne JAC. A modified test for small-study effects in meta-analyses of controlled trials with binary endpoints. Stat Med. 2006;25(20):3443-57. PMID: 16345038. DOI: 10.1002/sim.2380
- Peters JL, Sutton AJ, Jones DR, Abrams KR, Rushton L. Comparison of two methods to detect publication bias in meta-analysis. JAMA. 2006;295(6):676-80. PMID: 16467236. DOI: 10.1001/jama.295.6.676
- Deeks JJ, Macaskill P, Irwig L. The performance of tests of publication bias and other sample size effects in systematic reviews of diagnostic test accuracy was assessed. J Clin Epidemiol. 2005;58(9):882-93. PMID: 16085191. DOI: 10.1016/j.jclinepi.2005.01.016
- (さらに学びたい方へ。書誌情報は確認済みですが、本文中の特定の記述の根拠としては引用していません)Sterne JAC, Sutton AJ, Ioannidis JPA, Terrin N, Jones DR, Lau J, Carpenter J, Rücker G, Harbord RM, Schmid CH, et al. Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ. 2011;343:d4002. PMID: 21784880. DOI: 10.1136/bmj.d4002
- Cochrane Handbook for Systematic Reviews of Interventions, Chapter 13: Assessing risk of bias due to missing results in a synthesis(13.3.4.3〜13.3.4.4、表13.3.b)
- PRISMA 2020 Statement and checklist
- GRADE Working Group
- metafor package(Viechtbauer):
dat.bcg、regtest()、trimfill()、funnel()のドキュメント。metaパッケージ(Schwarzer)はmetabin()、metabias()、trimfill()(バージョン8.5-0)を使用 - UMIN臨床試験登録システム(UMIN-CTR)
- IBM SPSS Statistics 30 ドキュメント:メタアナリシスのファンネルプロット
- 国立がん研究センター:プロセス指標のファンネルプロット(用語の区別のためにのみ参照)