【統計エラー10選】査読で指摘される前に確認すべき統計的問題
統計的エラーは、高品質な研究内容があっても査読でリジェクトされる最大の原因の一つです。本記事では、実際の査読現場で頻繁に指摘される統計エラーを10項目にまとめ、具体的な修正方法と予防策を解説します。これらを投稿前に確認することで、採択率を大幅に向上させることができます。
エラー1: 正規性確認なしのパラメトリック検定適用
問題: Shapiro-Wilk検定やQ-Qプロットによる正規性確認なしにt検定・ANOVAを使用
影響: 特に小サンプル(n<30)では誤った結論につながる
影響: 特に小サンプル(n<30)では誤った結論につながる
修正: 統計的仮定の確認ガイドに従い、正規性を確認してから検定を選択。非正規分布にはMann-Whitney U検定等を使用。
エラー2: 効果量・信頼区間の未報告
問題: P値のみ報告し、効果量(Cohen’s d、η²、OR等)と95% CIを記載しない
影響: NEJM、JAMA、Lancet等の高インパクトジャーナルでは必須報告事項の欠如とみなされる
影響: NEJM、JAMA、Lancet等の高インパクトジャーナルでは必須報告事項の欠如とみなされる
エラー3: 多重比較補正の欠如
問題: 複数のアウトカムや比較を行いながら、α = 0.05をそのまま使用
影響: 偽陽性率が大幅に膨張(20回検定で64%の確率で偽陽性が発生)
影響: 偽陽性率が大幅に膨張(20回検定で64%の確率で偽陽性が発生)
修正: 多重比較補正ガイドに従い、Bonferroni/Holm(確証的研究)またはBenjamini-Hochberg FDR(探索的研究)を適用。
エラー4: P値の誤解釈
問題:
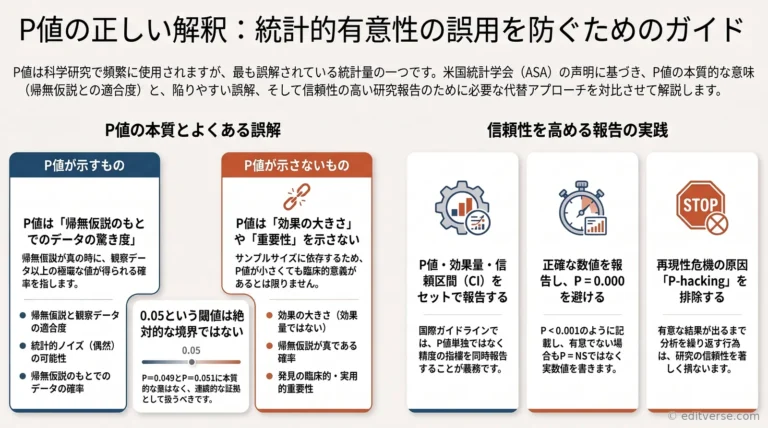
- 「P = 0.000」と表記(P < 0.001 が正しい)
- 「P = NS」と記載(正確な値を報告すべき)
- 「P値が小さいほど効果が大きい」と主張
- 「有意な傾向(P = 0.07)」という表現使用
修正: P値の正しい解釈ガイドを参照。P < 0.001の場合は「P < 0.001」と記述。P > 0.05の場合は正確な値(例: P = 0.234)を報告。
エラー5: 不適切なサンプルサイズと検出力の欠如
問題: 事前検出力分析なしに研究を開始。サンプルサイズの根拠が「過去の慣例」や「募集可能な人数」のみ
影響: 低検出力研究は真の効果を見逃す(Type II error)か、効果量を過大推定する
影響: 低検出力研究は真の効果を見逃す(Type II error)か、効果量を過大推定する
修正: 検出力分析ガイドに従い、G*Powerで事前計算。Methods に計算根拠(効果量の出典、α水準、検出力)を明記。
エラー6: 記述統計の誤り
問題:
- 非正規データに Mean ± SD を使用(Median (IQR) が正しい)
- SD と SEM の混同(SEM は平均の精度、SD はデータのばらつき)
- カテゴリデータに平均値を使用
| データの種類 | 正しい記述統計 | 誤り |
|---|---|---|
| 正規分布連続変数 | Mean ± SD | Mean ± SEM(記述統計には不適) |
| 非正規連続変数 | Median (IQR) | Mean ± SD |
| カテゴリ変数 | n (%) | 平均値や中央値 |
| 生存データ | Median survival (95% CI) | Mean survival |
エラー7: 欠測データの不適切な処理
問題: 欠測データの数や理由を報告せず、完全データだけで分析(Complete Case Analysis)
影響: 欠測がランダムでない場合(MAR, MNAR)、完全ケース分析は偏ったバイアスを生む
影響: 欠測がランダムでない場合(MAR, MNAR)、完全ケース分析は偏ったバイアスを生む
修正:
- 欠測データの数と欠測メカニズムを報告(MCAR、MAR、MNARの判断)
- 多重代入法(Multiple Imputation)の使用とその報告
- 感度分析として完全ケース分析との比較
エラー8: 相関と因果の混同
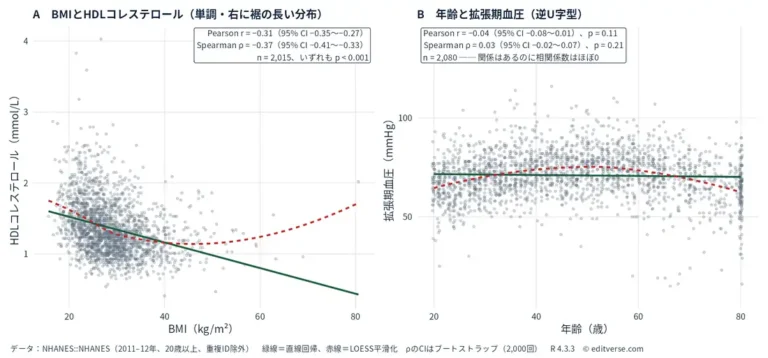
問題: 横断研究・相関研究で「Aが Bを引き起こす」と結論付ける
典型例: 「血中ビタミンD低値が骨折リスクを高める(相関研究)」→「ビタミンD補充で骨折を予防できる」と過剰解釈
典型例: 「血中ビタミンD低値が骨折リスクを高める(相関研究)」→「ビタミンD補充で骨折を予防できる」と過剰解釈
修正: 横断・コホート研究では「関連(associated with)」を使用。「cause」「result in」は介入研究(RCT)のみ使用可。交絡因子を調整した多変量解析の実施と報告。
統計エラーを防ぐための投稿前チェック
統計エラーの多くは、学術英語表現の問題ではなく、メソッドセクションの記述内容の問題です。また投稿規程でジャーナルが要求する統計基準を事前に確認することも重要です。
エラー9: 統計ソフトウェア情報の欠如
問題: 使用した統計ソフトウェアの名称・バージョン・パッケージ名を記載しない
影響: 研究の再現性が担保できない
影響: 研究の再現性が担保できない
修正例(英語): “Statistical analyses were performed using R version 4.3.1 (R Foundation for Statistical Computing, Vienna, Austria) with the ‘lme4’ package (version 1.1-34) for mixed-effects models and ‘effectsize’ package (version 0.8.3) for effect size calculations.”
エラー10: サブグループ解析の統計的問題
問題:
- 事前に計画していないサブグループ解析を「探索的」と断りなく報告
- サブグループ間の交互作用検定を実施しない
- 多重比較補正なしでサブグループ解析を報告
修正:
- 事前登録済みのサブグループ解析と探索的解析を明確に区別
- 交互作用(interaction)検定を実施・報告
- 多重比較補正を適用
- サブグループ解析結果は「仮説生成」として解釈
投稿前統計チェックリスト
| チェック項目 | 確認内容 | 参照記事 |
|---|---|---|
| □ 正規性確認 | Shapiro-Wilk検定実施・記録 | 仮定の確認 |
| □ 効果量報告 | Cohen’s d/η²/OR + 95% CI | 効果量計算 |
| □ 多重比較補正 | 補正法の選択と適用 | 多重比較 |
| □ P値の正しい記述 | P = 0.000 → P < 0.001 | P値解釈 |
| □ 検出力分析 | サンプルサイズの根拠 | 検出力分析 |
| □ 記述統計の適切性 | 正規 → Mean±SD、非正規 → Median(IQR) | 本記事 |
| □ 欠測データ処理 | 欠測数・処理方法の記述 | 本記事 |
| □ ソフトウェア情報 | 名称・バージョン・パッケージ | 本記事 |
投稿前に統計エラーを完全チェックしませんか?
上記10のエラーを1つでも見落とすと、査読でのリジェクト原因になります。Editverse Japanの統計専門家が、投稿前の統計セクション完全チェックを提供します。エラーを事前に修正して採択率を上げましょう。
参考PMID
| PMID | 著者 | 内容 |
|---|---|---|
| 27225100 | Wasserstein & Lazar (2016) | ASA声明 — P値の誤用と統計エラー |
| 25892050 | Open Science Collaboration (2015) | 統計エラーが再現性危機に与える影響 |
| 26186117 | Ioannidis (2015) | 研究における統計エラーの包括的分析 |
| 30581843 | Amrhein et al. (2019) | 統計エラーの根本的改善策の提言 |
| 28817453 | Benjamin et al. (2018) | 統計基準の強化による誤り削減の提言 |
Cluster 7 統計シリーズの完全活用
本シリーズ(統計検定基礎→P値→効果量→検出力→Type I/II Error→仮定→仮説検定→信頼区間→多重比較→統計エラー)を通じて、論文の統計セクションを国際基準に引き上げることができます。さらに専門家サポートが必要な場合はEditverse Japan統計解析サービスをご活用ください。
関連サービス:医学統計解析サポート
関連記事(Cluster 7 完全シリーズ)
- 散布図なしの相関係数報告を避ける:相関係数の使い分けと書き方
- Article 66: 統計検定の基礎と選択フレームワーク
- Article 67: P値の正しい解釈
- Article 68: 効果量の計算と報告
- Article 69: サンプルサイズと検出力分析
- Article 70: 第1種・第2種の過誤
- Article 71: 統計的仮定の確認
- Article 72: 仮説検定のフレームワーク
- Article 73: 信頼区間の正しい解釈
- Article 74: 多重比較補正
- 小標本でのカイ二乗検定の誤用(Fisher正確検定との使い分け)
- データから選んだカットオフ値は楽観的|ROC曲線とAUCの見方
- 順序尺度を連続量として扱う誤り|リッカート尺度の報告例
- 交絡因子の調整でよくある誤りと正しい書き方
- 有意差なし=差がない、という誤り
- 欠測データの感度分析|完全ケース解析と多重代入法の比較
- SDとSEの混同(エラーバーの書き方)