分散分析の書き方|二元配置・反復測定・Tukey法
分散分析(ANOVA:analysis of variance)は、3群以上の平均、または同じ人を3回以上測定した平均を、1回のF検定でまとめて比較する方法です。t検定を何度も繰り返すと偽陽性の確率が上がりますが、分散分析ならそれを避けられます。ただしFが有意だったときにわかるのは「少なくとも1つの平均が異なる」ことだけです。どの群の間に差があるかは、全体の第1種の過誤(ファミリーワイズ誤差率)を制御した多重比較(たとえばTukeyのHSD)で示します。本記事では、Rの実データと実際の出力を使って、一元配置・二元配置・反復測定の選び分け、事前に確認すること、論文のResultsでの書き方を解説します。
分散分析表の読み方は、一元配置では「要因」の行を見るのが基本です(二元配置では交互作用の行が先です。第4節)。自由度(Df)、平方和(Sum Sq)、平均平方(Mean Sq)、F値、P値(Pr(>F))が並び、F値は要因の平均平方を誤差(Residuals)の平均平方で割った値です。Fに対応するP値が事前に決めた有意水準を下回れば、「すべての母平均が等しい」という帰無仮説を棄却します。第3節の出力で、実際にこの割り算を確かめます。
本記事が扱うのは、分散分析の計画の選び方、交互作用、球面性の補正、そして多重比較の進め方と報告のしかたです。検定全般の選び方は統計検定の選び方、正規性・等分散性の確認は統計的仮定の確認、Bonferroni・Holm・FDRの理論は多重比較補正、効果量全般は効果量の計算をご覧ください。ここでは繰り返しません。ExcelやSPSS、EZRの画面操作の手順も扱いません。
1. 分散分析は何を検定し、何を検定しないのか
なぜt検定を何度も繰り返してはいけないのか。有意水準α = 0.05で比較を1回増やすたびに、偽陽性が起こる機会が1回増えます。独立な比較をk回行うとき、少なくとも1回偽陽性になる確率は 1 − (1 − α)k です。α = 0.05で3回比較すると 1 − 0.953 = 0.143 になります(Kim HY, 2015;Kim TK, 2017)[文献2・1]。分散分析は、「これらの平均のどこかに差はあるか」という問いに、選んだαで1回の検定として答えます。
F統計量とは。Fは、群間の分散と群内の分散の比です(Kim TK, 2017)[文献1]。
F = [ Σ nᵢ (Ȳᵢ − Ȳ)² / (K − 1) ] ÷ [ Σ (Yᵢⱼ − Ȳᵢ)² / (N − K) ]
Ȳᵢは群iの平均、Ȳは全体の平均、Kは群の数、Nは観測値の総数です。帰無仮説は「すべての母平均が等しい」で、対立仮説は「すべての平均が異なる」ではなく「少なくとも1つの平均が異なる」です(Kim TK, 2017)[文献1]。次の一元配置の例で確かめられます。群間の平均平方は 3.766 / 2 = 1.883、群内の平均平方は 10.492 / 27 = 0.389 で、F = 1.883 / 0.389 = 4.85 です。
Fが有意でもわからないこと。どの群とどの群が異なるかはわかりません。それを示すのが事後比較(多重比較)です(Kim TK, 2017;LeeとLee, 2018;Kim HY, 2015)[文献1・4・2]。
前提。観測値が互いに独立であること、残差がおおむね正規分布に従うこと、群間で分散が等しいことです(Kim TK, 2017)[文献1]。等分散性の確認にはLevene検定、正規性の確認にはShapiro–Wilk検定が挙げられています(Kim TK, 2017)。Tukey法も同じ前提を引き継ぎます(LeeとLee, 2018)[文献4]。反復測定の計画では、4つ目の前提として球面性(sphericity)が加わります(第5節)。前提が満たされないときの実務的な対応は統計的仮定の確認で扱っています。
2. どの分散分析を使うか|デザインから決める
選ぶ基準は、統計ソフトのメニューではなく研究デザインです。
| 研究デザイン | 使う分散分析 | 最初に見る結果 |
|---|---|---|
| 要因が1つで、群ごとに別の参加者(例:対照群・処理1・処理2) | 一元配置分散分析(one-way ANOVA) | 要因のF検定。そのあとで、対ごとの事後比較 |
| 要因が2つで、すべてのセルが別の参加者(例:2種類のサプリメント × 3段階の用量) | 交互作用を含む二元配置分散分析(two-way ANOVA) | 交互作用の項。どちらの主効果よりも先に見る(Kim HY, 2014)[文献3] |
| 1つの群を3回以上測定(または3つ以上の条件で測定) | 一元配置反復測定分散分析(repeated-measures ANOVA) | Mauchly検定とイプシロン補正。そのあとで、補正後の自由度とP値 |
| 参加者の群と反復測定の両方(例:治療群と対照群を3時点で測定) | 混合計画(split-plot)分散分析。被験者間要因を1つ含む二元配置の反復測定 | 群 × 時間の交互作用。群のみ、時間のみのP値は補足的な位置づけ(Kim Jら, 2025)[文献5] |
文献から、実務上の2つのルールが導かれます。
- 二元配置の計画を、別々の一元配置分散分析に置き換えない。一方の要因の各水準で、もう一方の要因について一元配置分散分析を行うだけでは、要因間の交互作用を検出できません(Kim HY, 2014)[文献3]。
- 反復測定を、独立な群として扱わない。同じ人の測定値は互いに相関します。その従属性を考慮した分散分析が、反復測定分散分析です(Kim Jら, 2025)[文献5]。第5節で、答えがどれだけ変わるかを示します。
アウトカムがほぼ連続でない場合、分布が大きく歪んでいる場合、欠測のある多数の時点で測定した場合は、古典的な分散分析よりも、順位に基づく検定や混合効果モデルのほうが適していることがあります。Armstrong(2017)は、反復測定データの代替手段としてMANOVAと混合モデルによる解析を概説しています[文献7]。順位に基づく検定については、ここでは1行の言及にとどめます。
3. 実例1|一元配置分散分析とTukeyのHSD
データ。datasets::PlantGrowth(Dobson, 1983。Rに同梱)です。対照条件と2つの処理条件に各10株、計30株の乾燥重量が入っています。Rのドキュメントに重量の単位の記載はないため、単位なしで報告します。
fit1 <- aov(weight ~ group, data = PlantGrowth)
summary(fit1)
TukeyHSD(fit1)
出力(R 4.3.3、stats::aov、stats::TukeyHSD):
            Df Sum Sq Mean Sq F value Pr(>F)
group        2  3.766  1.8832   4.846 0.0159 *
Residuals   27 10.492  0.3886

$group
            diff        lwr       upr     p adj
trt1-ctrl -0.371 -1.0622161 0.3202161 0.3908711
trt2-ctrl  0.494 -0.1972161 1.1852161 0.1979960
trt2-trt1  0.865  0.1737839 1.5562161 0.0120064
群ごとの要約(平均、SD。各群n = 10):対照 5.03(0.58)、処理1 4.66(0.79)、処理2 5.53(0.44)。同じモデルでの前提の確認:Levene検定(car::leveneTest、中央値中心)F(2, 27) = 1.12、p = 0.34、残差のShapiro–Wilk検定 W = 0.966、p = 0.44。感度分析:Welchの分散分析 F(2, 17.13) = 5.18、p = 0.017、Kruskal–Wallis検定 p = 0.018。いずれも同じ方向を示すため、古典的な分散分析の結果を報告します。
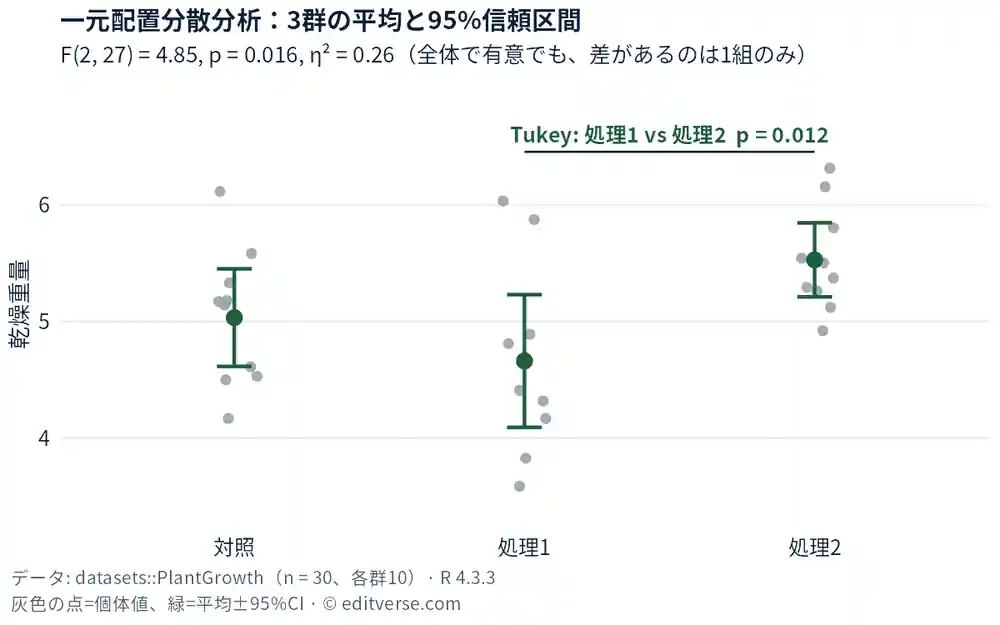
図の読み方:全体のFは有意ですが、Tukey調整後に差が認められるのは3つの対のうち1つ(処理1と処理2)だけです。
この同じデータで、事後比較の段階が重要な理由。プールしたSDを使い、調整しない対ごとのt検定を行うと、処理1と処理2はp = 0.0045になります(pairwise.t.test(..., p.adjust.method = "none"))。Tukeyの調整後の値はp = 0.012です。ここでは両方とも0.05を下回りますが、調整しない値は、3つの対を同時に調べることの不確実性を過小に見せます。報告するのは、調整後の値です。
論文での報告例(Resultsの英文例)
Dried weight differed among the three groups (one-way ANOVA, F(2, 27) = 4.85, p = 0.016, η² = 0.26). Tukey’s HSD showed that treatment 2 (M = 5.53, SD = 0.44) exceeded treatment 1 (M = 4.66, SD = 0.79; mean difference 0.87, Tukey-adjusted 95% CI 0.17 to 1.56, adjusted p = 0.012), whereas neither treatment differed from control (M = 5.03, SD = 0.58; adjusted p = 0.39 and 0.20).
ここでのη²(イータ二乗)は、群間平方和を全体の平方和で割った値です(3.766 / 14.258 = 0.264)。rstatix::anova_test が出力する一般化η²も、この一要因の計画では0.264です。
4. 実例2|二元配置分散分析と交互作用
データ。datasets::ToothGrowth(モルモット60匹。Crampton, 1947;Bliss, 1952)[文献11]です。ビタミンCをオレンジジュース(OJ)またはアスコルビン酸(VC)で、0.5・1・2 mg/日与えたあとの歯の長さ(変数名 len)です。Rのドキュメントによると、これは歯の成長を担う象牙芽細胞の長さです。1セルあたりn = 10です。ここでは用量を3水準の因子として扱います。これは研究計画上の判断ですので、Methodsに明記してください。
tg <- ToothGrowth; tg$dose <- factor(tg$dose)
fit2 <- aov(len ~ supp * dose, data = tg)     # "*" = 主効果2つ+交互作用
summary(fit2)
tk <- TukeyHSD(fit2, "supp:dose")             # 6セルの全15対
出力(R 4.3.3):
            Df Sum Sq Mean Sq F value   Pr(>F)
supp         1  205.4   205.4  15.572 0.000231 ***
dose         2 2426.4  1213.2  92.000  < 2e-16 ***
supp:dose    2  108.3    54.2   4.107 0.021860 *
Residuals   54  712.1    13.2
セルごとの平均(SD)は次のとおりです。
| 用量 | OJ | VC |
|---|---|---|
| 0.5 mg/日 | 13.23(4.46) | 7.98(2.75) |
| 1 mg/日 | 22.70(3.91) | 16.77(2.52) |
| 2 mg/日 | 26.06(2.66) | 26.14(4.80) |
6セルを通したLevene検定は F(5, 54) = 1.71、p = 0.15、残差のShapiro–Wilk検定は W = 0.985、p = 0.67 です。計画は釣り合っており(バランス計画)、car::Anova によるタイプIIIの表(和がゼロとなる対比)は、上の表と同じ結果です。
解釈の順序。Kim HY(2014)は、まず交互作用を含む完全なモデルを当てはめ、交互作用の項を検定することを勧めています[文献3]。交互作用が有意なら、一方の因子の効果は他方の因子の水準によって変わるため、どちらの因子の効果も単独では述べられません。この場合は、組み合わせたセル(ここでは2 × 3 = 6)を1つの因子のように扱い、事後比較で比べます(Kim HY, 2014)。ここでは、サプリメント × 用量の交互作用が有意(p = 0.022)です。したがって、有意な「サプリメント」の主効果(p = 0.0002)を、「OJのほうがVCより優れている」と無条件に報告してはいけません。
交互作用の内容を示すTukeyの比較は次のとおりです(15対のうち3対。比較の族は15)。
| OJ − VC(用量ごと) | 平均値の差 | Tukey調整後の95%信頼区間 | 調整後p |
|---|---|---|---|
| 0.5 mg/日 | 5.25 | 0.45〜10.05 | 0.024 |
| 1 mg/日 | 5.93 | 1.13〜10.73 | 0.007 |
| 2 mg/日 | −0.08 | −4.88〜4.72 | 1.00 |

図の読み方:2本の線は平行ではありません。OJは低い2つの用量でVCを上回り、2 mg/日では差がなくなります。この平行でない形が交互作用です。
表の読み方:OJとVCの差は用量によって異なります。0.5 mg/日では5.25、1 mg/日では5.93とOJが上回り、2 mg/日では−0.08とほぼ差がなくなります。用量が変わると差も変わる、このパターンが交互作用です。
事前に計画していた場合の、もう1つの妥当な方法。Kim Jら(2025)は、「単純主効果」の分析は有意な交互作用のあとの最も一般的な追加解析ですが、主効果と交互作用が混ざってしまうこと、代替として交互作用の対比があることを述べています[文献5]。用量ごとにOJとVCを比べる単純効果の分析(3つの比較にわたるHolm調整、emmeans 1.10.0)を事前に計画していた場合、p = 0.004、0.002、0.96となり、Tukeyと同じ結論です。方法はデータを見る前に決め、どちらを使ったかを書いてください。
効果量。偏η²(partial η²)は SS効果 / (SS効果 + SS誤差) です。サプリメント 0.22、用量 0.77、交互作用 0.13 です。この完全な被験者間計画では、rstatix::anova_test も同じ3つの値を一般化η²として出力します。
Resultsの英文例
A 2 (supplement) × 3 (dose) between-subjects ANOVA showed main effects of supplement, F(1, 54) = 15.57, p < 0.001, ηp² = 0.22, and dose, F(2, 54) = 92.00, p < 0.001, ηp² = 0.77, which were qualified by a supplement × dose interaction, F(2, 54) = 4.11, p = 0.022, ηp² = 0.13. Tukey-adjusted comparisons showed greater tooth length with orange juice than with ascorbic acid at 0.5 mg/day (difference 5.25, 95% CI 0.45 to 10.05, p = 0.024) and 1 mg/day (5.93, 95% CI 1.13 to 10.73, p = 0.007) but not at 2 mg/day (−0.08, 95% CI −4.88 to 4.72, p = 1.00).
5. 実例3|反復測定分散分析、球面性、事後比較
データ。lme4::sleepstudy です。睡眠制限試験の連続する日に測定した、18人の平均反応時間(ms)が入っています(Belenkyら, 2003。Rのドキュメントでの説明に従う)[文献10]。ドキュメントによると、0〜1日目は順応と訓練、2日目がベースライン、睡眠制限は2日目の後から始まります。簡潔な例にするため、ここでは2・4・6・8日目(ベースラインと、等間隔の後の日)を使います。事後比較の表を短くするため、当方で選びました。これは計算の仕組みを示す例であり、元の研究の解析の再現ではありません。元の研究は速度(1/反応時間)を解析し、日をカテゴリとして扱っています(Rのドキュメント)。
library(rstatix)
sl <- subset(lme4::sleepstudy, Days %in% c(2, 4, 6, 8)); sl$Day <- factor(sl$Days)
sl <- sl[order(sl$Subject, sl$Day), ]
res <- anova_test(sl, dv = Reaction, wid = Subject, within = Day)
res
pairwise.t.test(sl$Reaction, sl$Day, paired = TRUE, p.adjust.method = "holm")
出力(R 4.3.3、rstatix 0.7.2):
$ANOVA
  Effect DFn DFd      F        p p<.05   ges
1    Day   3  51 16.067 1.76e-07     * 0.225

$`Mauchly's Test for Sphericity`
  Effect     W     p p<.05
1    Day 0.466 0.035     *

$`Sphericity Corrections`
  Effect   GGe     DF[GG]    p[GG] p[GG]<.05   HFe      DF[HF]    p[HF]
1    Day 0.734 2.2, 37.44 5.16e-06         * 0.848 2.54, 43.25 1.21e-06

  Pairwise comparisons using paired t tests  (Holm)
  2       4       6
4 0.01488 -       -
6 0.01031 0.05969 -
8 0.00025 0.00049 0.05969
日ごとの平均(SD)は次のとおりです。
| 日 | 2日目 | 4日目 | 6日目 | 8日目 |
|---|---|---|---|---|
| 反応時間(ms)の平均(SD) | 265.4(29.5) | 288.6(42.5) | 312.2(63.2) | 336.6(60.2) |
2つのイプシロンは、4つの測定値の共分散行列から手計算でも確認しました(Greenhouse–Geisser 0.7342、Huynh–Feldt 0.8480)。補正後のP値もFから再計算しています(5.2 × 10⁻⁶と1.2 × 10⁻⁶)。
球面性とは。球面性とは、すべての条件の対について、その差の分散が等しいことです。各時点そのものの分散ではありません(Kim Jら, 2025)[文献5]。Armstrong(2017)も、被験者内の平均の対の差という言い方で同じ定義を示しています[文献7]。条件が2つだけなら差の集合は1つしかないため、問題になるのは条件が3つ以上のときです。成り立たないとF分布がゆがみ、第1種の過誤の確率が上がります(Kim Jら, 2025;Blancaら, 2023)[文献5・6]。対策は、2つの自由度の両方に、推定値ε(イプシロン。1/(k−1)以上1以下)を掛けることです。よく使う推定値は、Greenhouse–GeisserとHuynh–Feldtの2つです(Kim Jら, 2025;Blancaら, 2023)。
どちらの補正を使うか。公表されている経験則は一致していません。事前に決め、そのルールを報告してください。
- Kim Jら(2025):Greenhouse–Geisserのεが0.75を超えるときはHuynh–Feldt、0.75以下または球面性が疑わしいときはGreenhouse–Geisserを使います[文献5]。
- Blancaら(2023)(シミュレーション研究):2つの補正検定の結論が異なる場合、ε̂ < 0.60ならGreenhouse–Geisser、ε̂ ≥ 0.60ならHuynh–Feldtを信頼します。また、Mauchly検定は小さな逸脱への感度が高くなく、非正規性のもとでは第1種の過誤を制御できないとも述べています。そのため、Mauchly検定を判断の関門にするよりも、ε̂に基づいて判断する方法が代替になります[文献6]。
今回のデータではε̂(GG)は0.73で、2つのルールは異なる補正を指します。しかし、ここでは問題になりません。Greenhouse–Geisser(p = 5.2 × 10⁻⁶)とHuynh–Feldt(p = 1.2 × 10⁻⁶)は同じ結論になり、補正しないF(p = 1.8 × 10⁻⁷)も同じだからです。ここでは、より保守的なGreenhouse–Geisserの値を報告し、補正の選び方を読者が確認できるよう、Mauchly検定の結果も併記します。
反復構造を無視すると何が変わるか。同じ72個の数値を、72人の別々の参加者のデータとみなして通常の一元配置分散分析を行うと、F(3, 68) = 6.57になります。誤差項に、人どうしの安定した差が含まれてしまうためです(誤差平方和は174,982で、人の間の変動の平方和121,339を分けると53,643になります)。反復測定のFは、自由度3と51で16.07です。誤ったモデルを使うと、数値も自由度も変わります。
被験者内因子の事後比較。報告されている方法の1つは、多重性の補正をつけた対応のあるt検定です(Kim Jら, 2025は、Bonferroni補正の例を挙げています)[文献5]。ここではHolmの段階的下降法による調整を使いました。ファミリーワイズ誤差を制御しつつ、Bonferroniより検出力が高い方法です(Kim HY, 2015)[文献2]。対応のある平均値の差の、調整していない95%信頼区間(ms)は次のとおりです。4日目 − 2日目 23.3(8.1〜38.5)、6日目 − 2日目 46.8(18.8〜74.8)、8日目 − 2日目 71.3(43.8〜98.7)、6日目 − 4日目 23.5(2.6〜44.5)、8日目 − 4日目 48.0(28.0〜68.0)、8日目 − 6日目 24.5(1.8〜47.1)。これらの区間は多重性のために広げていないため、報告するときはその旨を書いてください。

図の読み方:個人ごとの反応時間は、人ごとに1本の線として描いています。反復測定の検定は、それらの線が同じ人のものであるという事実を使っています。平均につけた被験者間の区間は、検定が必要とする幅よりも広くなるため、個人の線も併せて示してください。
効果量はどれかを明記する。rstatix は一般化η²(ηG² = 0.225)を出力します。同じ表から計算した偏η²は 50,700 / (50,700 + 53,643) = 0.486 です。被験者内の計画では、この2つは大きく異なります。OlejnikとAlgina(2003)は、偏η²が計画をまたぐと誤解を招きうることを示し、一般化η²を提案しています[文献8]。Bakeman(2005)は、被験者間の計画と被験者内の計画の間で比較できることから、反復測定の計画では一般化η²を日常的に報告するよう勧めています[文献9]。どちらを報告するにせよ、名称を書いてください。効果量全般は効果量の計算をご覧ください。
Resultsの英文例
Mauchly’s test indicated that sphericity was violated (W = 0.47, p = 0.035), so Greenhouse–Geisser correction was applied (ε = 0.73). Reaction time changed across the four study days, F(2.20, 37.44) = 16.07, p < 0.001, ηG² = 0.22. Holm-adjusted paired t-tests showed longer reaction times than at baseline (Day 2) on Day 4 (mean difference 23.3 ms, adjusted p = 0.015), Day 6 (46.8 ms, adjusted p = 0.010) and Day 8 (71.3 ms, adjusted p < 0.001); Day 8 also exceeded Day 4 (48.0 ms, adjusted p < 0.001), whereas Day 6 did not differ from Day 4 or Day 8 after adjustment (both adjusted p = 0.060).
時間のような順序のある因子で測定点が多い場合は、対ごとの比較を標準にする前に、Kim Jら(2025)とArmstrong(2017)が述べる交互作用の対比や混合モデルの方法を検討する価値があります[文献5・7]。
6. 事後比較の選び方と、論文への書き方
事後比較の選び方
次の表は、Kim HY(2015)、LeeとLee(2018)、Kim TK(2017)の記述をまとめたものです[文献2・4・1]。補正の理論そのものは多重比較補正で扱っています。
| 状況 | 通常の選択 | 備考 |
|---|---|---|
| 全対比較、群の大きさが等しく、分散も等しい | TukeyのHSD | ステューデント化された範囲の分布を使う。全対比較に適した方法とされる(Kim HY, 2015) |
| 全対比較、群の大きさが不均等 | Tukey–Kramer | 不均衡なデータへのTukey法の修正(Kim HY, 2015;LeeとLee, 2018)。Rのドキュメントによると、TukeyHSD に含まれる標本サイズの調整が妥当な区間を与えるのは、わずかに不均衡な計画に限られる |
| 全対比較、分散が等しくない | Games–Howell | 等分散の前提が成り立たないときに用いる(Kim TK, 2017) |
| すべての群を1つの対照群と比べる | Dunnett検定 | この特定の状況で大きな検出力を示す(Kim HY, 2015) |
| 事前に選んだ少数の比較 | Bonferroni、Šidák、Holm | 比較の族が大きいとBonferroniは保守的になる。Holmはその段階的下降の改良(Kim HY, 2015) |
| 対だけではない複雑な対比 | Scheffé | 保守的。対ごとの比較だけが関心なら勧められない(Kim HY, 2015) |
| ファミリーワイズ誤差が問題になるあらゆる状況 | FisherのLSDは使わない | LSDはファミリーワイズ誤差率を制御しない(Kim HY, 2015) |
文献から、2点を補足します。事後比較の表は矛盾して見えることがあります。群Aは群Bと異なるのに、群Cは両方と区別できない、という場合です。各結果は論理的な主張ではなく統計的な主張であり、こうしたパターンは検出力の限界から生じることがあります(LeeとLee, 2018)[文献4]。また、事後比較の方法が異なれば結果も異なりえます(Kim TK, 2017)[文献1]。これは当方の見解ですが、データを見る前に、解析計画で事後比較の方法を固定しておくべき理由の1つです。
Methodsに書くこと
ICMJEは、著者に次の点を求めています。原データにアクセスできる知識のある読者が、統計手法の妥当性を判断し、報告された結果を検証できる程度に詳しく統計手法を記述すること。P値だけでなく、信頼区間のような不確実性の指標を含む推定値を示すこと。使用した統計ソフトとバージョンを明記すること。事前に規定した解析と探索的な解析を区別すること(ICMJE Recommendations、原稿作成の項)。
Methodsの英文テンプレート(そのままコピーせず、ご自身の研究に合わせて調整してください)。
Group means were compared by one-way ANOVA [two-way ANOVA with group and time as factors / one-way repeated-measures ANOVA]. Homogeneity of variance was assessed with Levene’s test and normality of residuals with the Shapiro–Wilk test and residual plots. For repeated measures, sphericity was assessed with Mauchly’s test and the Greenhouse–Geisser correction was applied [state your rule]. Significant omnibus effects were followed by [Tukey’s HSD / Holm-adjusted paired t-tests] to control the family-wise error rate at 0.05. Effect sizes are reported as [η² / partial η² / generalized η²] with 95% confidence intervals where available. Analyses were performed in R version [x.y.z] using [package versions]. [State which post-hoc comparisons were prespecified.]
和訳:群間の平均は、一元配置分散分析[群と時間を要因とする二元配置分散分析/一元配置反復測定分散分析]で比較した。分散の等質性はLevene検定、残差の正規性はShapiro–Wilk検定と残差プロットで評価した。反復測定では、球面性をMauchly検定で評価し、Greenhouse–Geisser補正を適用した[選択のルールを記載]。有意な全体の効果には、ファミリーワイズ誤差率を0.05に制御するため、[TukeyのHSD/Holm調整した対応のあるt検定]を続けて行った。効果量は[η²/偏η²/一般化η²]で、可能な場合は95%信頼区間とともに報告した。解析はRバージョン[x.y.z]と[パッケージのバージョン]を用いて行った。[どの事後比較を事前に規定したかを記載]
投稿前のチェックリスト
| 項目 | 書く場所 |
|---|---|
| 計画の明記(被験者間/被験者内/混合、水準の数) | Methods |
| 前提の確認と、満たされなかったときの対応 | Methods(詳細は補足資料) |
| 反復測定:MauchlyのW、ε、どの補正を使ったか | MethodsとResults |
| 要因計画:交互作用の検定を先に報告 | Results |
| Fは自由度を両方、正確なP値(またはp < 0.001)、効果量の名称 | Results |
| 事後比較の方法、比較の族、調整後P値と信頼区間 | Results |
| すべての群またはセルの平均とSD(または信頼区間) | 表または図 |
| 統計ソフトとバージョン | Methods |
査読者が確認する点
査読では、多重比較の補正がないといった統計上の指摘が出ることがあります。典型的な指摘と回答のしかたは査読で統計を指摘されたら、報告全般は論文における統計解析結果の報告方法をご覧ください。P値や信頼区間の読み方は、P値の正しい解釈と信頼区間の解釈で解説しています。
分散分析のモデル選択から、MethodsとResultsの記述までを確認したい方へ
統計モデルの選択、前提の確認、解析の実施、MethodsとResultsの執筆は、統計の専門家に並走してほしいと考える研究者の方が多い工程です。研究課題、解釈、結論は研究者の方に帰属します。協力者を謝辞に記すか、著者資格を満たすかは、当社ではなくICMJEの基準で決まります(医学統計解析の外注|依頼前の準備と納品物・著者資格をご覧ください)。Editverse Japanの医学統計解析サポートは、分散分析を含む解析を扱い、解析コードと結果レポートを納品し、MethodsとResultsの文章づくりも支援します。料金は原稿ごとの定額で、採択まで追加料金なしでサポートを継続します(採否はジャーナルが判断し、採択を保証するものではありません)。
すでに査読者から解析について指摘を受けている場合(たとえば「多重比較の補正が行われていない」)は、査読対応・統計再解析をご覧ください。再現可能なRスクリプトと出力ログによる再解析、修正した表と図、統計コメントへのポイントごとの回答まで対応します。
統計関連サービスの全体は、統計解析サービスのページでご覧いただけます。
まとめ
- 分散分析は、t検定の繰り返しによる偽陽性の増加を抑え、選んだαを保つ方法です。Fが有意とは「少なくとも1つの平均が異なる」という意味で、それ以上ではありません。
- モデルはデザインから選びます。一元配置(被験者間の要因が1つ)、二元配置(被験者間の要因が2つ。交互作用を先に)、反復測定(同じ人。球面性を確認)、混合計画(群 × 時間)です。
- 交互作用が有意なら、因子は別々に解釈できません。セルを比較するか、事前に計画した単純効果や交互作用の対比を使います。
- 反復測定では、MauchlyのW、ε、選んだ補正を報告し、通常の一元配置ではなく反復測定の誤差項を使います。
- 事後比較の方法を明記し(全対ならTukey、対照との比較ならDunnett、事前に計画した少数の比較ならHolmやBonferroni)、調整後P値と信頼区間を報告し、効果量の名称も書きます。
- 本記事の数値はすべて、上に示した実際のRのデータとコードから得たものです。ご自身の論文でも、同じチェックリストが当てはまります。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- 【統計的仮定の確認】正規性・等分散性の検証と論文記述
- 【多重比較補正】Bonferroni・Holm・FDRの選択と論文記述
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 査読で統計を指摘されたら|よくある7つの指摘と回答のしかた
- 医学統計解析の外注|依頼前の準備と納品物・著者資格
- 有意差とは|「有意差なし」の意味と論文での書き方・報告例文
- カイ二乗検定とFisher正確検定の使い分けと報告例文
- Kruskal-Wallis検定とDunn検定の使い方・報告例はノンパラメトリック検定の選び方
よくある質問
Q. 一元配置分散分析と二元配置分散分析は、何が違いますか?
一元配置分散分析は、グループ分けの要因が1つ(たとえば3種類の処置)です。二元配置分散分析は要因が2つ(たとえばサプリメントと用量)で、2つの主効果に加えて、一方の要因の効果が他方の要因の水準によって変わるか(交互作用)を検定します。交互作用が有意なときは、主効果を単独で解釈できません(Kim HY, 2014)[文献3]。
Q. 分散分析が有意でした。事後比較は必ず必要ですか?
どの群が異なるかを述べたいなら、必要です。F検定が示すのは、少なくとも1つの平均が異なることだけです(Kim TK, 2017)[文献1]。全対比較ならTukeyのHSD、対照群との比較ならDunnett検定のように、ファミリーワイズ誤差率を制御する方法を使います(Kim HY, 2015)[文献2]。FisherのLSDは制御しません(Kim HY, 2015)。
Q. Mauchly検定が有意(または有意でない)でした。反復測定では何を報告しますか?
Wとp、使ったε、補正後の自由度を報告します。Greenhouse–GeisserとHuynh–Feldtの補正は、自由度にεを掛けます。両者の選び方の指針は一致しないため(Kim Jら, 2025;Blancaら, 2023)、ご自身のルールを明記してください[文献5・6]。Mauchly検定だけを判断の関門にするのは、感度の面で十分ではありません(Blancaら, 2023)。
Q. 分散分析では、どの効果量を報告すればよいですか?
使った効果量の名称を必ず書いてください。偏η²はよく使われますが、計画をまたぐと誤解を招きうるものです。一般化η²は、被験者間の計画と被験者内の計画の間で比較できるため、反復測定の計画で推奨されています(OlejnikとAlgina, 2003;Bakeman, 2005)[文献8・9]。効果量の計算もご覧ください。
Q. 分散分析の解析を、Editverseに相談できますか?
はい。分散分析は医学統計解析サポートが扱う解析の1つで、R(またはSPSS・Stata・SAS)のコードと結果レポートを納品し、MethodsとResultsの文章づくりも支援します。研究デザイン、解釈、結論は著者に帰属します。協力者を謝辞に記すか共著者とするかは、ICMJEの基準に従います。上の案内と、医学統計解析の外注|依頼前の準備と納品物・著者資格をご覧ください。
参考資料
PubMed収載の文献(各文献はNCBI E-utilitiesのesummaryで記録を確認し、引用した記述については全文または抄録を開いて確認)
- Kim TK. Understanding one-way ANOVA using conceptual figures. Korean J Anesthesiol. 2017;70(1):22-26. doi: 10.4097/kjae.2017.70.1.22. PMID: 28184262. PMCID: PMC5296382
- Kim HY. Statistical notes for clinical researchers: post-hoc multiple comparisons. Restor Dent Endod. 2015;40(2):172-176. doi: 10.5395/rde.2015.40.2.172. PMID: 25984481. PMCID: PMC4432262
- Kim HY. Statistical notes for clinical researchers: Two-way analysis of variance (ANOVA)-exploring possible interaction between factors. Restor Dent Endod. 2014;39(2):143-147. doi: 10.5395/rde.2014.39.2.143. PMID: 24790929. PMCID: PMC3978106
- Lee S, Lee DK. What is the proper way to apply the multiple comparison test? Korean J Anesthesiol. 2018;71(5):353-360. doi: 10.4097/kja.d.18.00242. PMID: 30157585. PMCID: PMC6193594(訂正記事あり:Korean J Anesthesiol. 2020;73(6):572, PMID: 33271011)
- Kim J, Park JH, Kim TK. Analysis of interaction effect between within- and between-subject factors in repeated measures analysis of variance for longitudinal data. Korean J Anesthesiol. 2025;78(5):418-428. doi: 10.4097/kja.22617. PMID: 40963176. PMCID: PMC12489589
- Blanca MJ, Arnau J, García-Castro FJ, Alarcón R, Bono R. Repeated measures ANOVA and adjusted F-tests when sphericity is violated: which procedure is best? Front Psychol. 2023;14:1192453. doi: 10.3389/fpsyg.2023.1192453. PMID: 37711324. PMCID: PMC10499170
- Armstrong RA. Recommendations for analysis of repeated-measures designs: testing and correcting for sphericity and use of manova and mixed model analysis. Ophthalmic Physiol Opt. 2017;37(5):585-593. doi: 10.1111/opo.12399. PMID: 28726257.(抄録のみ確認)
- Olejnik S, Algina J. Generalized eta and omega squared statistics: measures of effect size for some common research designs. Psychol Methods. 2003;8(4):434-447. doi: 10.1037/1082-989X.8.4.434. PMID: 14664681.(抄録のみ確認)
- Bakeman R. Recommended effect size statistics for repeated measures designs. Behav Res Methods. 2005;37(3):379-384. doi: 10.3758/bf03192707. PMID: 16405133.(抄録のみ確認)
- Belenky G, Wesensten NJ, Thorne DR, Thomas ML, Sing HC, Redmond DP, Russo MB, Balkin TJ. Patterns of performance degradation and restoration during sleep restriction and subsequent recovery: a sleep dose-response study. J Sleep Res. 2003;12(1):1-12. doi: 10.1046/j.1365-2869.2003.00337.x. PMID: 12603781.(
sleepstudyの元となった研究。Rのドキュメントの記載に従って引用しており、統計上の主張には使っていません) - Crampton EW. The growth of the odontoblasts of the incisor tooth as a criterion of the vitamin C intake of the guinea pig. J Nutr. 1947;33(5):491-504. doi: 10.1093/jn/33.5.491. PMID: 20294344.(
ToothGrowthの元となった研究。Rのドキュメントの記載に従って引用しており、統計上の主張には使っていません)
ガイドライン・ソフトウェア・データ
- ICMJE. Recommendations for the Conduct, Reporting, Editing, and Publication of Scholarly Work in Medical Journals:Preparing for Submission(統計に関する段落)(2026年10月6日に確認)
- ICMJE. Defining the Role of Authors and Contributors(著者資格の4つの基準、非著者の協力者。2026年10月6日に確認)
- R Core Team.
stats::TukeyHSDのRドキュメント(R 4.3.3):標本サイズの調整は、わずかに不均衡な計画に適用される - R Core Team. R: A language and environment for statistical computing, version 4.3.3:https://www.r-project.org/
- データセット:
datasets::PlantGrowth(Dobson AJ, An Introduction to Statistical Modelling, Chapman and Hall, 1983)、datasets::ToothGrowth(Bliss CI, The Statistics of Bioassay, Academic Press, 1952。Crampton 1947)、lme4::sleepstudy(lme4 1.1.35.1)。いずれもRのヘルプページの記載に従う - パッケージ:rstatix 0.7.2(
anova_test)、car 3.1.2(leveneTest、Anova)、emmeans 1.10.0