ノンパラメトリック検定の選び方|U検定・Kruskal-Wallis・Wilcoxon
アウトカムが順序尺度の場合、標本がごく小さい場合、あるいは連続データの歪みや外れ値が大きく、平均値とSDでは実態を誤って伝えてしまう場合には、順位に基づく検定(ノンパラメトリック検定)を使います。独立した2群にはMann-Whitney U検定(Wilcoxon順位和検定)、対応のあるデータにはWilcoxon符号順位検定、独立した3群以上にはKruskal-Wallis検定(その後にDunn検定やSteel-Dwass検定)、反復測定にはFriedman検定が基本です。論文では、各群の中央値[四分位範囲]を示し、検定の種類(正確検定か正規近似か、連続性補正の有無、同順位の扱い)を明記し、さらにHodges-Lehmann推定値や効果量rなど「差の大きさ」を添えます。P値だけでは差の大きさが読者に伝わらないためです。本記事では、ニューヨークの日別オゾン濃度と古典的な睡眠データというRの実データを使い、すべての数値を再現できる形で解説します。
本記事が扱うのは、ノンパラメトリック検定の枝だけです。検定全般の選び方は統計検定の選び方を、正規性や等分散性の確認方法は統計的仮定の確認をご覧ください。リッカート項目や、尺度得点でのWelchのt検定とMann-Whitney検定の比較はリッカート尺度の分析に、パラメトリックな多重比較(Tukey、Dunnett)は分散分析の書き方にまとめてあります。順位相関(Spearman)は相関係数をご覧ください。
1. どの検定がどの問いに答えるのか
| デザイン | パラメトリック検定 | 順位に基づく検定 | Rの関数(特記以外はstats) |
|---|---|---|---|
| 独立した2群 | 対応のないt検定 | Mann-Whitney U検定=Wilcoxon順位和検定 | wilcox.test(y ~ g) |
| 対応のある2つの測定 | 対応のあるt検定 | Wilcoxon符号順位検定(方向だけが問題ならば符号検定) | wilcox.test(x, y, paired = TRUE) |
| 独立した3群以上 | 一元配置分散分析 | Kruskal-Wallis検定。その後にDunn、Steel-Dwass、または対ごとのWilcoxon検定 | kruskal.test(y ~ g)、FSA::dunnTest()、pairwise.wilcox.test() |
| 3回以上の反復測定 | 反復測定分散分析 | Friedman検定。その後に対ごとのWilcoxon符号順位検定 | friedman.test() |
表の対応関係は、Nahm(2016)[文献1]とKim(2014a、2014b)[文献2、3]に基づきます。
名称で混乱しやすい点が2つあります。「Wilcoxon順位和検定」と「Mann-Whitney U検定」は、独立した2群では同じ検定です(Rのヘルプは順位和検定を「Mann-Whitney検定と同等」としています)。一方、「Wilcoxon符号順位検定」は、対応のあるデータに使う別の検定です。
これらの検定はいずれも、元の値を順位に置き換えます(同順位には平均順位を与えます。Kim 2014a、2014b)。そのため極端な値の影響が限られる(Nahm 2016)一方、情報の一部が失われます(Kim 2014a)。Dunn検定は、Kruskal-Wallis検定が有意だったあとに行う対ごとの比較としてDunn(1964)が示した手順で、Rでは FSA::dunnTest() が実装しています(Rヘルプ)。Steel-Dwass検定(Dwass-Steel-Critchlow-Fligner検定とも呼ばれます)は、PMCMRplusパッケージの dscfAllPairsTest() として実装されています。パッケージの説明によれば、対ごとに順位をつけ直すことでU検定を拡張したもので、P値はスチューデント化された範囲分布から求めます。なお本記事の解析セッションではPMCMRplusをインストールできなかったため、Steel-Dwass検定は実行しておらず、その数値は示していません。
2. ノンパラメトリック検定を選ぶ場面と、選ばない場面
根拠のある選択理由は次のとおりです。
- 順序尺度のアウトカム。Kim(2014a)は、順序尺度のアウトカムを、ノンパラメトリック検定を使う一般的な理由の1つに挙げています。リッカート項目が一例です(リッカート尺度の記事をご覧ください)。
- 正規性を保証できない小標本、および強い歪みや明らかな外れ値を持つ連続データ。ただし、まず対数変換などの変換を検討してからです(Kim 2014a)。
- 事前に決めた解析計画。SAMPLは、歪んだデータはノンパラメトリック検定で解析したこと、対応のあるデータは対応のある検定で解析したことを、Methodsに明記するよう求めています(Lang と Altman, 2015)[文献6]。
一方、次の点には注意が必要です。
- 大標本。Fagerland(2012)[文献4]のシミュレーションでは、平均値も中央値も等しいが、ばらつきがわずかに違う歪んだ2群で、Wilcoxon-Mann-Whitney検定がt検定よりはるかに高い頻度で帰無仮説を棄却することがありました。結論は、ノンパラメトリック検定は小規模な研究で最も有用であり、大規模な研究では「間違った問いへの答え」になりうる、というものです。この高い棄却率は、一方の群からの無作為な観測値がもう一方の群の観測値より小さい確率が50%と異なることを検出する検出力、と読むのが適切です。標本が大きい場合は、強く歪んだデータでも、t検定と信頼区間を使うことを勧めています。
- ベースライン測定のあるランダム化比較試験。Vickers(2005)[文献5]のシミュレーションでは、ANCOVAが多くの状況でMann-Whitney検定より優れており、特に対数変換したデータを用いた場合に顕著でした。
- 既定では「中央値の検定」ではない。この検定が扱うのは、一方の群の値が他方の群の値を上回る確率です(Nahm 2016、Fagerland 2012)。Rのヘルプも、
wilcox.test(..., conf.int = TRUE)が返す位置の推定値は中央値の差ではなく、xからの標本とyからの標本の差の中央値だと述べています。この点は、下の実例で実際の数値で確かめます。 - 情報が少なくなる。Kim(2014a)は、順位への変換で情報の一部が失われること、ノンパラメトリック検定は主に事前に設定した仮説を検定するものでパラメータの推定を行わないことを指摘しています。本記事が、区間つきの推定値を添えることにこだわるのはこのためです。
- データが正規分布なら、失うものは小さい。Nahm(2016)は、正規性が成り立つときのWilcoxon検定とMann-Whitney検定の、t検定に対する漸近相対効率が0.955であると紹介しています(NahmはHodges と Lehmann 1956、Chernoff と Savage 1958を引用しています。この2つの原著は、本記事の作成では確認していません)。
実務上の原則は、P値を見る前に検定を決めること、その理由を解析計画に書くこと、選択が自明でない場合はもう一方の解析を感度分析として報告することです(リッカート尺度と分散分析の記事に例があります)。
3. Rによる実例
データ。datasets::airquality には、1973年5月から9月までのニューヨークの日別大気質(153行)が収録されています。Ozone は、ルーズベルト島で13時から15時に測定した平均オゾン濃度(ppb)です(Rのドキュメント)。オゾンは37日分が欠測で、残る116件が解析対象です(5月26、6月9、7月26、8月26、9月29)。6月は30日のうち21日が欠測のため、9件しかありません。1つの都市の1年分の日別データは時系列なので、これらの検定が前提とする独立性には疑問があります。このデータは検定と報告の実演のためだけに使っており、大気質についての結論を導くものではありません。対応のある例には datasets::sleep を使います。10人の患者について、2種類の薬での追加睡眠時間(時間)を測定したデータで、出典はStudent(1908)とCushny と Peebles(1905)です(Rのドキュメント。変数 group は2つの薬を表し、同じ10人が両方の条件で測定されています)。
3.1 記述統計|平均値(SD)ではなく中央値[四分位範囲]
| 月 | n | 中央値[Q1, Q3] ppb | 平均値(SD) ppb |
|---|---|---|---|
| 5月 | 26 | 18[11, 31.5] | 23.6(22.2) |
| 6月 | 9 | 23[20, 37] | 29.4(18.2) |
| 7月 | 26 | 60[36.25, 79.75] | 59.1(31.6) |
| 8月 | 26 | 52[28.75, 82.5] | 60.0(39.7) |
| 9月 | 29 | 23[16, 36] | 31.5(24.1) |
四分位数はRの既定(quantile(type = 7))によるもので、ほかのタイプでは値がわずかに変わります(5月のQ3は、タイプ6では32.5になります)。使ったソフトウェアを明記してください。5月の分布は明らかに歪んでおり(歪度2.60、Shapiro-Wilk検定 W = 0.714、P < 0.001)、8月はそれほどではありません(歪度0.79、W = 0.933、P = 0.090)。SAMPLは、正規分布していないデータは中央値と分位範囲で要約するよう勧めています(Lang と Altman, 2015)。正規性の確認方法は統計的仮定の確認をご覧ください。
3.2 独立した2群|Mann-Whitney U検定(5月と8月)
# R 4.3.3
oz <- airquality[!is.na(airquality$Ozone), ]
d2 <- oz[oz$Month %in% c(5, 8), ]
d2$Month <- factor(d2$Month, labels = c("May", "Aug"))
wilcox.test(Ozone ~ Month, data = d2, exact = FALSE, correct = FALSE)

a <- d2$Ozone[d2$Month == "Aug"]; m <- d2$Ozone[d2$Month == "May"]
wilcox.test(a, m, conf.int = TRUE, exact = FALSE, correct = FALSE)
出力(Rのセッションからのコピー、抜粋):
	Wilcoxon rank sum test
data:  Ozone by Month
W = 127.5, p-value = 0.0001164

(2つ目の呼び出し:W = 548.5, p-value = 0.0001164)
95 percent confidence interval:
 14.99997 52.99996
sample estimates:
difference in location
              31.99996
結果(各群n = 26、N = 52)は次のとおりです。
- U統計量。5月のU = 127.5、もう一方のUは 26 × 26 − 127.5 = 548.5 で、Rはこれを8月の標本のWとして出力します。連続性補正なしの正規近似(既定の
correct = TRUEではP = 0.0001208)で、Z = −3.85、P = 0.0001164 です。 - 効果量 r = |Z| / √N = 3.8536 / √52 = 0.534。
rstatix::wilcox_effsize()は、rをZ統計量÷総標本サイズの平方根として計算し、0.5以上を慣例的に「大」と分類します(Rのヘルプはこの基準を、文献でよく使われるものと述べており、決まりではありません)。 - 優越確率(無作為に選んだ8月の日が無作為に選んだ5月の日を上回る確率。同値は0.5として数えます。U / (n1 × n2) に等しい)= 548.5 / 676 = 0.811。
- Hodges-Lehmann推定値(8月 − 5月の差)= 32 ppb、95%信頼区間 15〜53 ppb。これは群間の676通りの差すべての中央値です。中央値の差は 52 − 18 = 34 ppb、平均値の差は36.3 ppbで、3つはそれぞれ別の量です(Rのヘルプ)。
- ばらつきも違います。四分位範囲は5月が20.5、8月が53.75 ppbで、Fligner-Killeen検定はP < 0.001(0.00015)でした。したがって、純粋な位置のずれとして読む前提は厳密には成り立たず、差の説明には優越確率(0.81)のほうが安全です(Fagerland 2012)。
- 感度分析。元の値へのWelchのt検定は、t = 4.07、自由度39.3、P = 0.0002、平均値の差36.3 ppb(95%信頼区間 18.3〜54.4)でした。対数変換後では、P < 0.001(6.9 × 10⁻⁵)、幾何平均の比2.81です。方向も結論も同じです。
3.3 同順位と正確検定
オゾンは整数のppbで記録されているため、同順位が多くあります(5月と8月を合わせた52個の値のうち、異なる値は41個だけです)。Rの wilcox.test() は、値が50個未満で同順位がないときだけ正確P値を計算します。それ以外では正規近似を使い、「cannot compute exact p-value with ties」と警告します(Rヘルプ)。Kim(2014a)も、同順位が問題を生じうること、調整が必要なことを指摘しています。明示的に扱う方法が2つあります。
library(coin)
wilcox_test(Ozone ~ Month, data = d2, distribution = "asymptotic")  # Z = -3.8536, P = 0.0001164
wilcox_test(Ozone ~ Month, data = d2, distribution = exact())       # Z = -3.8536, P = 0.00006109
同順位を扱える正確な条件付き検定では、P = 6.1 × 10⁻⁵ となり、漸近的な1.2 × 10⁻⁴ の約半分です。この例ではどちらも0.05を大きく下回りますが、P値が閾値に近いときは、この選択で結論が変わりえます。次の対応のある例がその実例です。10万回のリサンプリングによるモンテカルロ近似ではP = 5 × 10⁻⁵ となり、正確な値と整合しました。
3.4 対応のあるデータ|Wilcoxon符号順位検定(sleep)
x <- sleep$extra[sleep$group == 1]; y <- sleep$extra[sleep$group == 2]
wilcox.test(y, x, paired = TRUE, conf.int = TRUE)                   # V = 45, P = 0.009091(既定:連続性補正あり)
wilcox.test(y, x, paired = TRUE, exact = FALSE, correct = FALSE)   # V = 45, P = 0.007632
coin::wilcoxsign_test(y ~ x, distribution = exact())                 # P = 0.003906
10組の差(薬2 − 薬1)は 1.2、2.4、1.3、1.3、0.0、1.0、1.8、0.8、4.6、1.4 で、差がちょうど0のものが1組、同じ値のものが2組あります。Rは、同順位とゼロがあるため正確P値と正確な信頼区間を計算できないと警告します。同じデータでも、検定の種類によってP値は次の4通りになります。
| 検定の種類 | P |
|---|---|
wilcox.test の既定(連続性補正つきの正規近似) |
0.0091 |
wilcox.test、correct = FALSE |
0.0076 |
coin、漸近、Pratt法のゼロ処理 |
0.0058 |
正確検定(coin::wilcoxsign_test(distribution = exact()) と exactRankTests::wilcox.exact) |
0.0039 |
正確な値は手計算で確かめられます。ゼロの差を除くと9組が残り、すべてが正なので、両側の正確Pは 2 / 29 = 2 / 512 = 0.0039 です。この例では4つのP値すべてが0.05を下回りますが、どれを報告したのかは、Methodsに書かない限り読者にはわかりません。対応のある差の中央値に対するHodges-Lehmann推定値は1.4時間(正確な95%信頼区間 1.05〜2.90、漸近では1.05〜2.95)です。一方、10個の差の中央値は1.3、平均値は1.58時間です(対応のあるt検定:P = 0.0028、95%信頼区間 0.70〜2.46)。
3.5 独立した3群以上|Kruskal-Wallis検定とその後の多重比較
kruskal.test(Ozone ~ factor(Month), data = oz)
rstatix::kruskal_effsize(oz, Ozone ~ Month)        # eta2[H] = 0.228
FSA::dunnTest(Ozone ~ factor(Month), data = oz, method = "holm")
pairwise.wilcox.test(oz$Ozone, factor(oz$Month), p.adjust.method = "holm", exact = FALSE)
出力(抜粋):
	Kruskal-Wallis rank sum test
Kruskal-Wallis chi-squared = 29.267, df = 4, p-value = 6.901e-06
全体の検定は有意です(H = 29.27、自由度4、P < 0.001。eta2[H] = (H − k + 1) / (N − k) = 0.228。rstatixは0.14以上を「大」と分類します)。これが示すのは、5つの月がすべて同じではないということだけです。どの月が違うのかを言うには、ファミリーワイズ誤差率を制御する事後検定が必要です(多重比較補正をご覧ください)。Kim(2014b)は、Bonferroni補正した有意水準での対ごとのWilcoxon順位和検定を1つの方法として説明しており、Elliott と Hynan(2011)[文献7]は、Kruskal-Wallis検定のあとの専用の事後検定を説明しています。Rでの結果は次のとおりです。
| 対 | Dunn検定、Holm調整後のP | 対ごとのWilcoxon検定、Holm調整後のP |
|---|---|---|
| 5月 − 6月 | 1.000 | 0.578 |
| 5月 − 7月 | 0.0001 | 0.0003 |
| 5月 − 8月 | 0.0003 | 0.0011 |
| 5月 − 9月 | 0.746 | 0.474 |
| 6月 − 7月 | 0.149 | 0.085 |
| 6月 − 8月 | 0.207 | 0.130 |
| 6月 − 9月 | 0.998 | 1.000 |
| 7月 − 8月 | 1.000 | 1.000 |
| 7月 − 9月 | 0.010 | 0.006 |
| 8月 − 9月 | 0.024 | 0.023 |
(DunnでHolmの代わりにBonferroniを使うと、7月 − 9月は0.013、8月 − 9月は0.035で、0.05を下回る4つの対は同じです。)どちらの方法も同じ4つの対を検出します。5月は7月と8月より低く、9月は7月と8月より低い、という結果です。調整後のP値は方法によって異なり、たとえば6月 − 7月はDunnで0.149、対ごとのWilcoxonで0.085です。これは、Dunn検定のz統計量が、全群をまとめた1回の順位づけから得た平均順位を使う(本記事のために手計算で再計算し、FSA::dunnTest と一致することを確認しました)のに対し、対ごとのWilcoxon検定は対ごとに順位をつけ直す(Steel-Dwass検定も同様です)ためです。したがって、方法そのものが結果の一部です。必ず名前を書いてください。図1に、データとDunn検定の行列を示します。
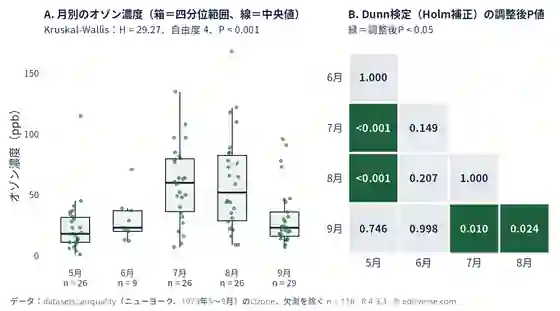
図の読み方:オゾンは7月と8月に、ほかの月より明らかに高く、ばらつきも大きくなっています。緑の4マスは、調整後も分布全体が異なる対です。残る6つの対は、このデータでは区別できません。3回以上の反復測定には、Friedman検定を使い、その後に多重性の調整つきで対ごとのWilcoxon符号順位検定を行います(Kim 2014b)。
4. 論文での報告方法
Methodsの例(ご自身の解析計画に合わせて調整してください)。
Ozone concentrations were right-skewed and are summarized as median [interquartile range]. Two independent groups were compared with the Wilcoxon-Mann-Whitney test (two-sided; normal approximation without continuity correction because of tied values), together with the Hodges-Lehmann estimate and 95% confidence interval of the location difference, the probability of superiority, and the effect size r = Z / sqrt(N). Paired data were compared with the Wilcoxon signed-rank test (exact P value; zero differences excluded). Three or more independent groups were compared with the Kruskal-Wallis test, followed by Dunn’s test with Holm adjustment. Analyses used R 4.3.3 (packages stats, coin, FSA, rstatix).
Resultsの例。
Median ozone was 52 ppb [IQR 28.75-82.5] in August (n = 26) and 18 ppb [11-31.5] in May (n = 26). The distributions differed (Wilcoxon-Mann-Whitney U = 127.5, Z = -3.85, P < 0.001, r = 0.53); the probability that a randomly chosen August day exceeded a randomly chosen May day was 0.81. The Hodges-Lehmann estimate of the difference was 32 ppb (95% CI 15 to 53). Across the five months ozone differed (Kruskal-Wallis H = 29.27, df = 4, P < 0.001); after Holm-adjusted Dunn tests, May was lower than July (adjusted P = 0.0001) and August (0.0003), and September was lower than July (0.010) and August (0.024).
報告チェックリスト。
| 項目 | 書く内容 |
|---|---|
| 要約統計量 | 群ごとに中央値[Q1, Q3](または中央値と範囲)とn。SAMPLは、分位範囲の幅だけでなく上下の境界値を示すよう求めています(Lang と Altman, 2015) |
| 検定名とデザイン | Mann-Whitney U/Wilcoxon順位和(独立)、Wilcoxon符号順位(対応あり)、Kruskal-Wallis、Friedman。データが対応ありか独立かも書く(SAMPL) |
| 検定の種類 | 正確検定か正規近似か、連続性補正の有無、同順位とゼロの差の扱い、どのUまたはWを報告するか |
| 片側・両側 | プロトコルで根拠が示されていない限り両側(SAMPL) |
| 統計量とP値 | UまたはW、Z、P値。SAMPLは実際のP値を示すこと、報告が必要な最小値はP < 0.001であることを述べています(SAMPLは小数第1〜2位も勧めています。Editverseの編集上の助言:Pが0.05に近いときは小数第3位まで示す) |
| 区間つきの効果指標 | 95%信頼区間つきのHodges-Lehmann推定値。効果量r(Z / √N、Nを明記)または優越確率。Kruskal-Wallis検定にはeta2[H]。SAMPLは、主要な比較に95%信頼区間などの精度の指標を求めています |
| 多重比較 | 事後検定と調整方法の名前(Dunn-Holm、Steel-Dwass、BonferroniまたはHolmによる対ごとのWilcoxon)。SAMPLは、多重比較の調整を行ったか、どのように行ったかの報告を求めています |
| ソフトウェア | 名称とバージョン、および事後検定のパッケージ |
5. よくある誤り
- 順位に基づく検定の横に平均値±SDを載せる。あるいは、群の分布の形が似ているかを確かめずに「中央値の比較」と呼ぶ(Fagerland 2012、Hodges-Lehmann推定値についてのRヘルプ)。
- 「P < 0.05」だけを報告し、差がどれだけ大きいかを示さない(Kim 2014a:ノンパラメトリック検定は通常、それ自体ではパラメータの推定値を与えない)。
- 対応のあるデータにWilcoxon順位和検定を、独立した群に符号順位検定を使う。
- Kruskal-Wallis検定のあとに、多重性の調整なしで、対ごとのMann-Whitney検定を繰り返す(多重比較補正をご覧ください)。
- 同順位があるのに、P値が正確か近似かを書かない。あるいは、小さいP値が出るほうを見てから検定の種類を選ぶ(睡眠データの0.0039〜0.0091をご覧ください)。
- 非常に大きな標本で、正規性の検定がP < 0.05だったことだけを理由にノンパラメトリック検定を選ぶ。または、そこでは信頼区間つきのt検定のほうが適切でありうることを見落とす(Fagerland 2012)。
- クラスターのあるデータや反復測定データ(1人の患者に複数の観測がある)に、観測が独立であるかのように順位検定を使う。この場合は、対応のある検定、反復測定の分析、または混合モデルが必要です。
6. Editverse Japanがお手伝いできること
検定の選択と記述を、投稿前に確認したい方へ
Editverse Japanの医学統計解析サポート(定額 79,800円)は、統計手法の選択、記述統計・推測統計の実施、MethodsとResultsの執筆支援までを、研究者の方と一緒に進めるサービスです。解析コードと結果レポートを納品し、R・SPSS・Stata・SASに、投稿先ジャーナルの要件に合わせて対応します。納期の目安は解析内容により5〜14営業日です。採択まで追加料金なしでサポートを継続します(採否はジャーナルの編集者・査読者が判断し、採択を保証するものではありません)。最終的な内容、結果の解釈、結論、投稿の判断は著者に帰属します(ICMJE・COPE準拠。統計支援は正当な貢献であり、研究デザイン・解釈・結論は研究者のものです)。
すでに査読者から検定について指摘を受けている場合(「ノンパラメトリック検定を使うべき」「t検定の前提が満たされていない」など)は、査読対応・統計再解析(定額 98,000円)をご覧ください。再解析、再現可能なRスクリプトと出力ログ、統計コメントへのポイントごとの回答まで対応します。
まとめ
- 順位に基づく検定は、Mann-Whitney U検定(独立2群)、Wilcoxon符号順位検定(対応あり)、Kruskal-Wallis検定(3群以上。事後検定はDunn、Steel-Dwass、または調整つきの対ごとのWilcoxon)、Friedman検定(反復測定)です。順序尺度、小標本、強く歪んだデータや外れ値の多いデータに向きますが、自動的に中央値の検定になるわけではなく、大標本では信頼区間つきのt検定のほうがよいこともあります(Fagerland 2012)。
- 実データでは、5月と8月のオゾン濃度(各群n = 26)で、Mann-Whitney検定はZ = −3.85、P = 0.0001164、r = 0.53、優越確率0.81、Hodges-Lehmann推定値32 ppb(95%信頼区間 15〜53)でした。この値は、中央値の差(34)や平均値の差(36.3)とは異なります。5つの月のKruskal-Wallis検定はH = 29.27、P < 0.001で、Dunn-Holm検定は、対ごとのWilcoxon-Holm検定と同じ4つの月の対を検出しました。
- 同順位とゼロの差の扱いで、P値が正確かどうかが決まります。睡眠データのP値は、検定の種類により0.0091、0.0076、0.0058、0.0039となるため、Methodsに種類を明記してください。
- 論文には、中央値[四分位範囲]とn、検定とその種類、両側であること、UまたはWとZ、P値、区間つきの効果指標、事後検定と調整方法の名前、ソフトウェアを書きます。
公費・研究費でのお支払いについて
Editverse Japanのサービスは、公費・研究費でお支払いいただけます。所属機関の経理手続きに必要な見積書・納品書・請求書を発行します。詳しくは公費・研究費でのお支払いをご覧いただくか、無料見積もり・お問い合わせからご相談ください。
関連記事
- 統計解析サービス
- 統計検定の選び方|論文で使う検定の基礎と適用方法
- 【統計的仮定の確認】正規性・等分散性の検証と論文記述
- 分散分析の書き方|二元配置・反復測定・Tukey法
- リッカート尺度の分析|平均か中央値か・検定の選び方と書き方
- 【多重比較補正】Bonferroni・Holm・FDRの選択と論文記述
- 効果量の計算|Cohen’s d・η²・オッズ比の使い分け
- 【統計の書き方】論文における統計解析結果の報告方法
- 標準偏差と標準誤差の違い|論文でのSD・SEの使い分け
よくある質問
Q. Mann-Whitney U検定とWilcoxon順位和検定は同じものですか?
独立した2群では同じ検定です。Rのヘルプは、Wilcoxon順位和検定をMann-Whitney検定と同等としており、Nahm(2016)も、計算の過程は異なるものの同じ統計量を使うと述べています。Wilcoxon符号順位検定は、対応のあるデータに使う別の検定です。
Q. 先に正規性を検定してから選ぶべきですか?
P値を見る前に、デザインとデータから決めてください。Kim(2014a)は、正規性をグラフや正規性の検定で確認し、対数変換などの変換を検討し、それでも前提が満たされない場合にノンパラメトリック検定を使う、という流れを説明しています。確認方法は仮定の記事で扱っています。標本が大きい場合は、信頼区間つきのt検定のほうがよいこともあり(Fagerland 2012)、ベースライン測定のあるランダム化比較試験では、一般にANCOVAが推奨されます(Vickers 2005)。
Q. ノンパラメトリック検定で、平均値とSDを報告してもよいですか?
SAMPLは、正規分布していないデータには中央値と分位範囲を勧めています(Lang と Altman, 2015)。平均値とSDを別の列に加えることは、どちらの要約が検定に対応するかを明記すれば差し支えありません。ただし、主たる記述には、解析に合った要約を使ってください。
Q. Kruskal-Wallis検定のあとは、Dunn、Steel-Dwass、対ごとのWilcoxonのどれを使いますか?
3つとも使われています。上の例では、DunnとHolm調整つきの対ごとのWilcoxonは同じ4つの対を検出しましたが、調整後のP値は異なりました(たとえば6月−7月は0.149と0.085)。Dunnは全群をまとめた順位を使い、Steel-Dwassと対ごとのWilcoxonは対ごとに順位をつけ直します(PMCMRplusのドキュメント)。事前に選び、方法と調整の名前を書き、投稿先のジャーナルや分野の慣行も確認してください。
Q. Mann-Whitney検定の効果量は、どう報告しますか?
95%信頼区間つきのHodges-Lehmann推定値と、効果量r(Zを総標本サイズNの平方根で割ったもの。本例では0.53)または優越確率(本例では0.81)を示します。どれを使ったか、その式も書いてください。Hodges-Lehmann推定値は群の中央値の差ではありません(Rヘルプ)。本例では32 ppbで、中央値の差は34 ppbでした。
参考資料
PubMed収載の文献(各文献は2026年10月7日にNCBI E-utilitiesのesummary/efetchで確認)
- Nahm FS. Nonparametric statistical tests for the continuous data: the basic concept and the practical use. Korean J Anesthesiol. 2016 Feb;69(1):8-14. doi: 10.4097/kjae.2016.69.1.8. PMID: 26885295. PMCID: PMC4754273(全文を確認)。
- Kim HY. Statistical notes for clinical researchers: Nonparametric statistical methods: 1. Nonparametric methods for comparing two groups. Restor Dent Endod. 2014 Aug;39(3):235-239. doi: 10.5395/rde.2014.39.3.235. PMID: 25110650. PMCID: PMC4125590(全文を確認)。
- Kim HY. Statistical notes for clinical researchers: Nonparametric statistical methods: 2. Nonparametric methods for comparing three or more groups and repeated measures. Restor Dent Endod. 2014 Nov;39(4):329-332. doi: 10.5395/rde.2014.39.4.329. PMID: 25383354. PMCID: PMC4223105(全文を確認)。
- Fagerland MW. t-tests, non-parametric tests, and large studies–a paradox of statistical practice? BMC Med Res Methodol. 2012 Jun 14;12:78. doi: 10.1186/1471-2288-12-78. PMID: 22697476. PMCID: PMC3445820(抄録を確認。本文での記述は抄録の範囲にとどめています)。
- Vickers AJ. Parametric versus non-parametric statistics in the analysis of randomized trials with non-normally distributed data. BMC Med Res Methodol. 2005 Nov 3;5:35. doi: 10.1186/1471-2288-5-35. PMID: 16269081. PMCID: PMC1310536(抄録を確認。本文での記述は抄録の範囲にとどめています)。
- Lang TA, Altman DG. Basic statistical reporting for articles published in biomedical journals: the “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. Int J Nurs Stud. 2015 Jan;52(1):5-9. doi: 10.1016/j.ijnurstu.2014.09.006. PMID: 25441757.(SAMPLの本文はEQUATOR NetworkのPDFで確認)
- Elliott AC, Hynan LS. A SAS macro implementation of a multiple comparison post hoc test for a Kruskal-Wallis analysis. Comput Methods Programs Biomed. 2011 Apr;102(1):75-80. doi: 10.1016/j.cmpb.2010.11.002. PMID: 21146248.(抄録を確認。本文での記述は、Kruskal-Wallis検定のあとの事後検定が存在する点にとどめています)
ガイドライン・ソフトウェア・データ
- EQUATOR Network. SAMPL Guidelines (Lang & Altman):EQUATOR Network: SAMPL(PDF)
- R Core Team.
wilcox.test(statsパッケージ)、airqualityとsleep(datasetsパッケージ)のRヘルプ(R 4.3.3)。FSAパッケージ(dunnTestのヘルプ、Dunn 1964の手順)。rstatixパッケージ(wilcox_effsize、kruskal_effsizeのヘルプ。r = Z / √N、eta2[H] = (H − k + 1)/(N − k))。coinパッケージ(wilcox_test、wilcoxsign_test、正確および漸近の条件付き分布)。exactRankTestsパッケージ(wilcox.exact)。 - PMCMRplusパッケージのドキュメント、
dscfAllPairsTest(Dwass-Steel-Critchlow-Fligner全対比較検定):rdrr.io: dscfAllPairsTest(ドキュメントのみ確認。パッケージは実行していません) - データ:
datasets::airquality(ニューヨークの大気質測定、1973年5〜9月)、datasets::sleep(Student 1908, Biometrika 6;Cushny と Peebles 1905, J Physiol 32:501-510。いずれもRのドキュメントの記載による)